> For the complete documentation index, see [llms.txt](https://docs.airops.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.airops.com/docs/pt/acoes/workflow-concepts/workflow-steps/web-research/web-page-scrape.md).
# Raspagem de página web
Extraia texto, markdown ou HTML de um site
A etapa "Web Page Scrape" permite automatizar uma extração de texto/markdown/HTML a partir de um URL específico. Pode combiná-la com uma etapa de iteração para extrair de vários sites e analisar a saída separadamente.
## Configurar a etapa "Web Page Scrape"
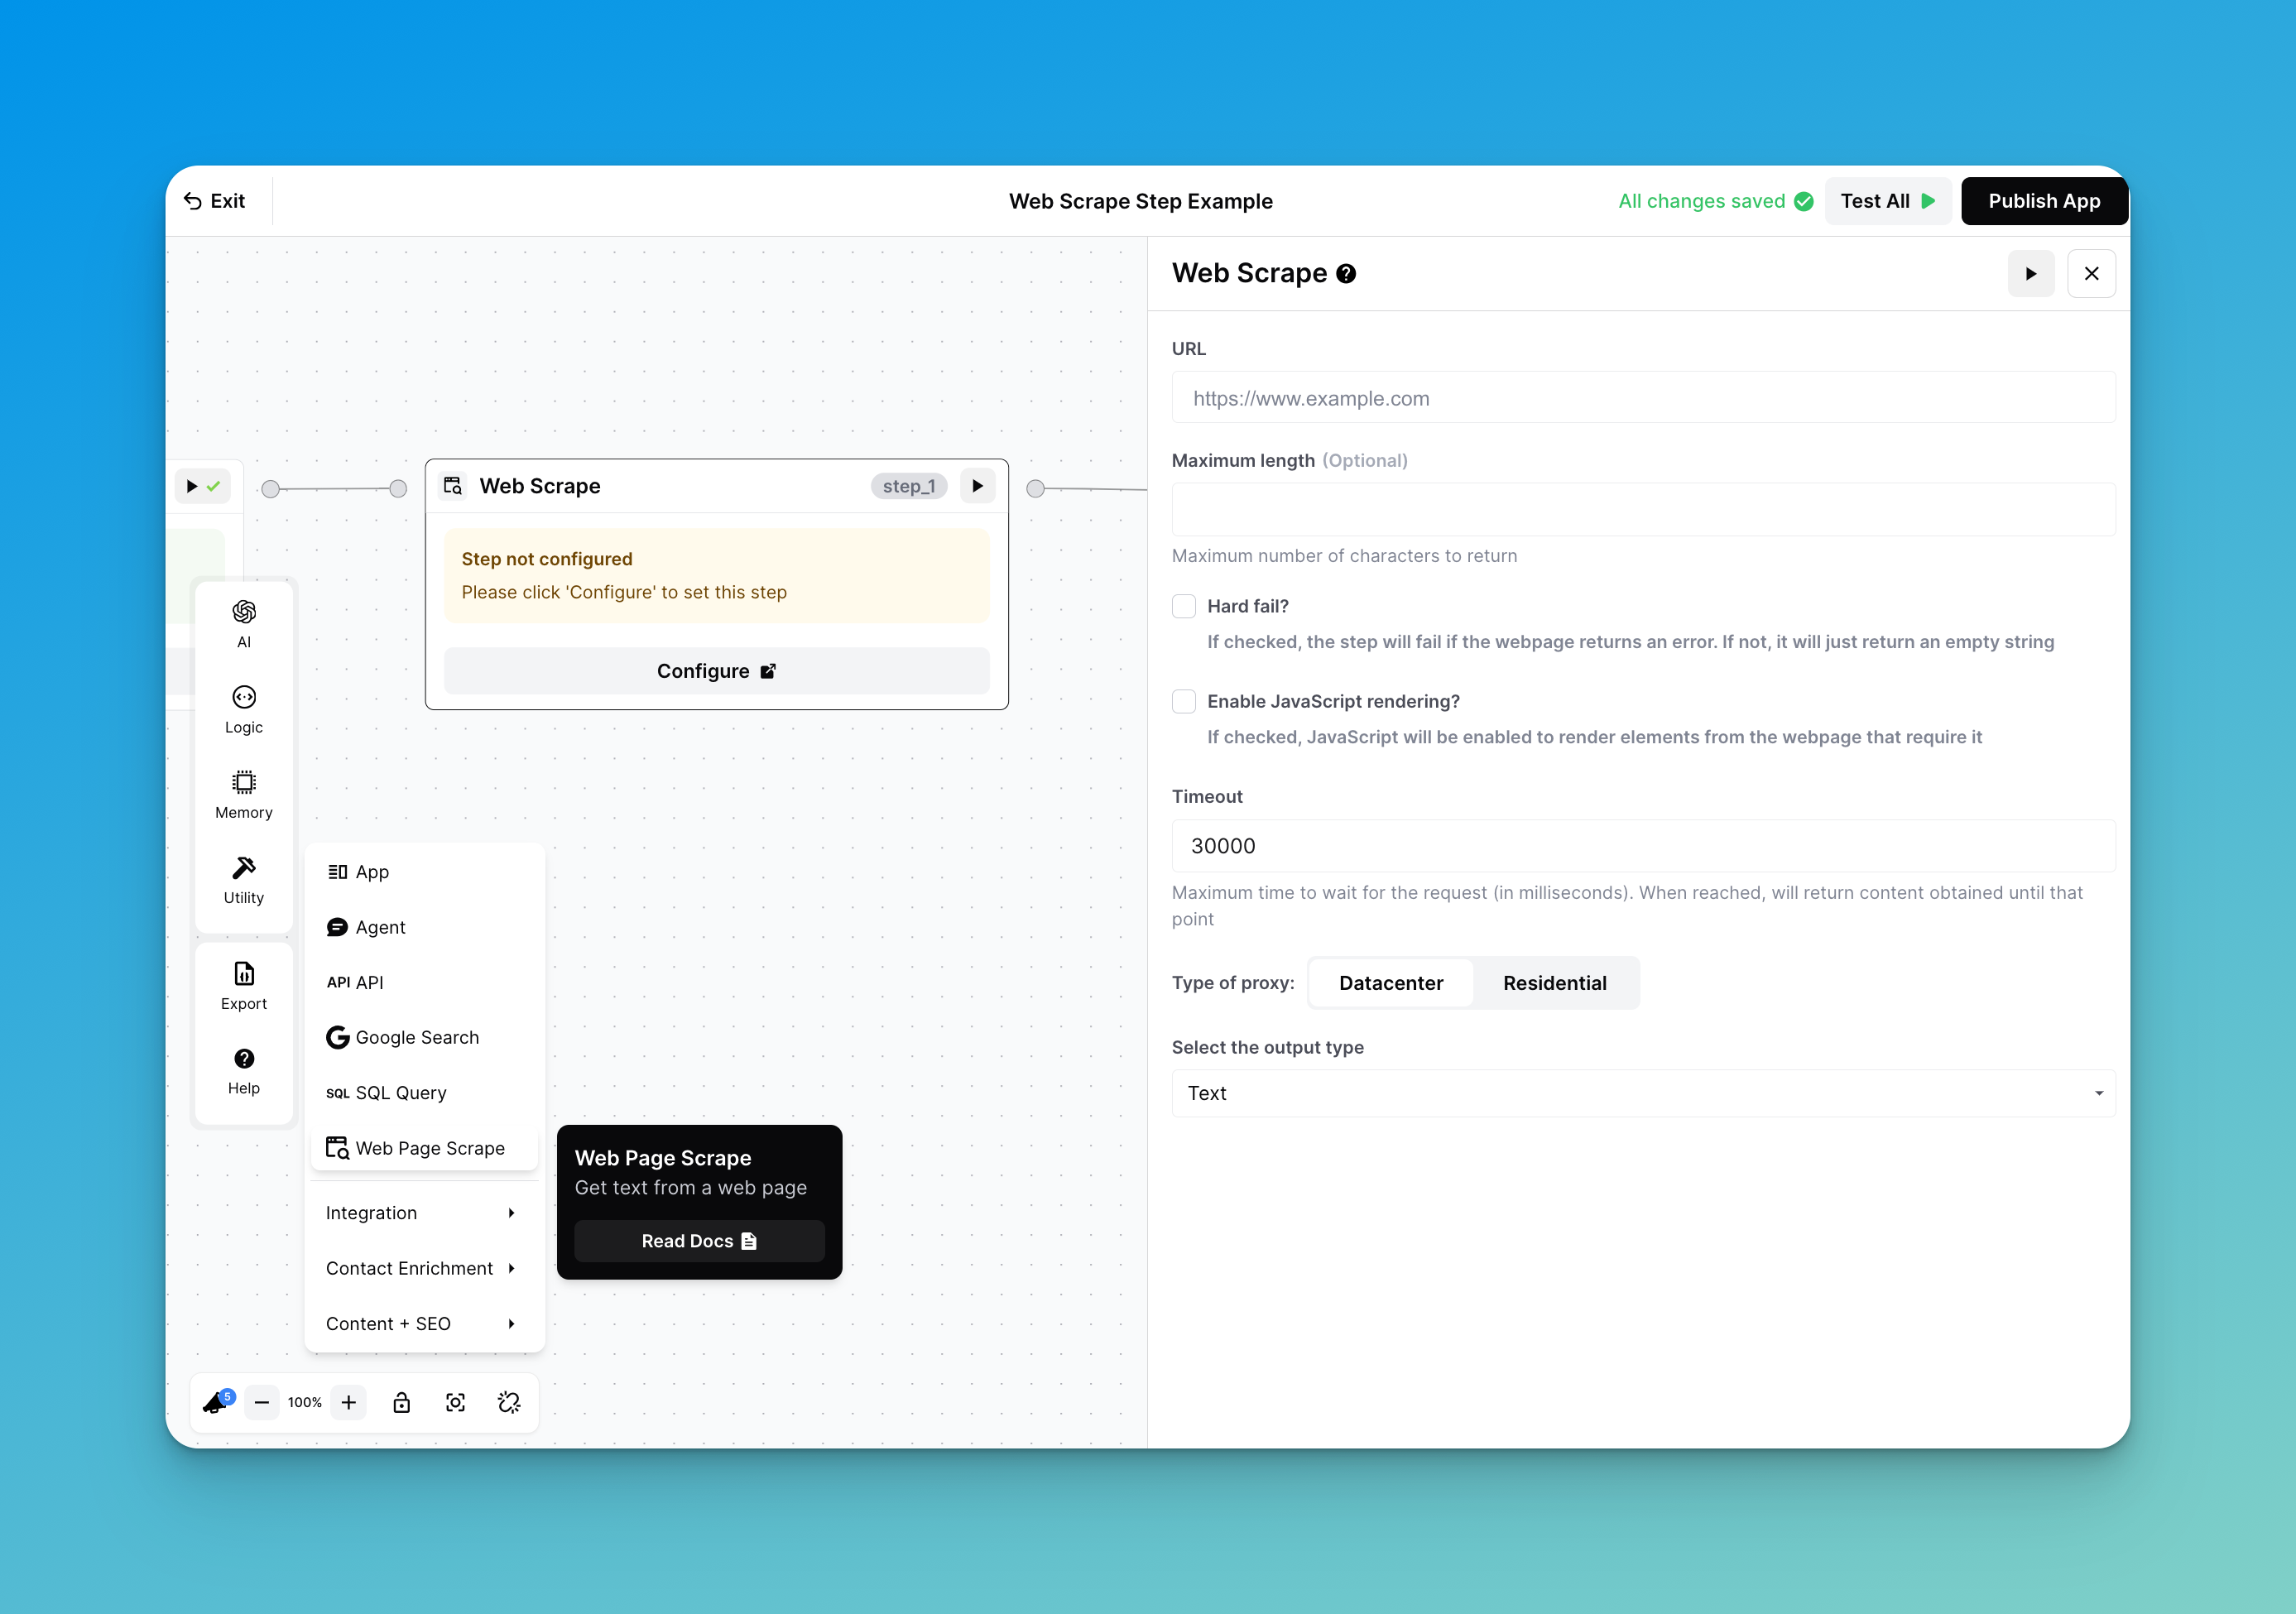
Configurar a etapa requer definir os parâmetros mostrados abaixo:
Configure os parâmetros da sua Web Page Scrape
### URL
Adicione o URL específico que pretende que a etapa extraia.
### Comprimento máximo
Opcionalmente, pode limitar o número de caracteres devolvidos pela etapa.
Este parâmetro pode ser útil para limitar a quantidade de texto passada para uma etapa LLM subsequente, que tem uma janela de contexto limitada.
{% hint style="warning" %}
**1 token corresponde aproximadamente a 4 caracteres em inglês.** Para estimar o número de caracteres que deve passar para uma etapa LLM, multiplique o número de tokens que pretende passar por 4.
{% endhint %}
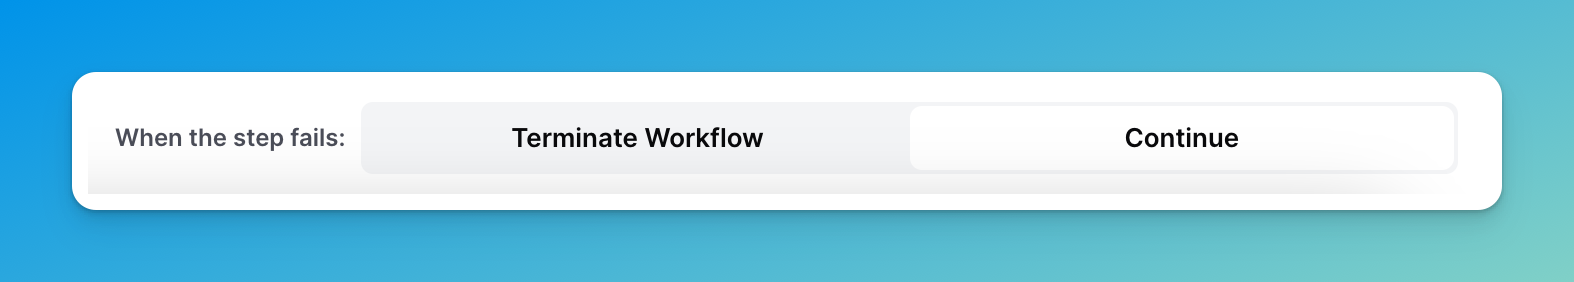
### Como continuar se a etapa Web Scrape falhar
Por predefinição, o code step terminará o workflow se falhar. No entanto, para continuar o workflow se o passo falhar, basta clicar `Continuar` na parte inferior do passo.
Clique em continuar para continuar o workflow
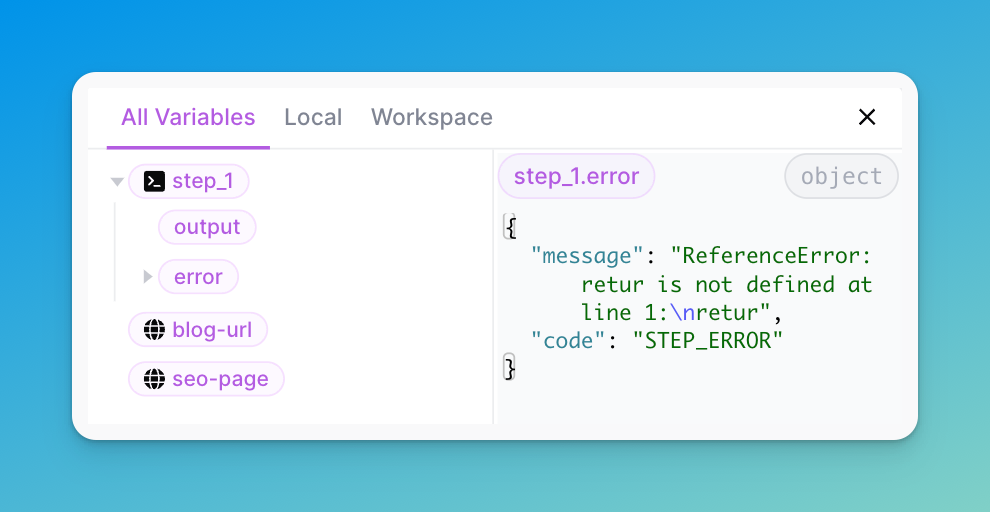
O passo devolverá as seguintes chaves:
* `saída` : este será `null`
* `erro` :
* `mensagem`: a mensagem retornada pela etapa
* `código` : o código de erro que representa o erro
### Ativar renderização JavaScript?
Por predefinição, a etapa Web Page Scrape não renderiza websites que usam JavaScript.
Marque esta caixa para ativar a extração de websites que usam JavaScript para ajudar a renderizar conteúdo dinâmico (exemplos incluem Facebook, Airbnb e outros).
### Tempo limite
O tempo máximo de espera para que os resultados da sua webscrape sejam devolvidos, em milissegundos.
### Tipo de proxy:
Use a funcionalidade **proxy residencial** para sites que exigem mais fiabilidade e taxas de sucesso mais elevadas. Por outro lado, use o **proxy de datacenter** quando a fiabilidade e as taxas de sucesso não forem uma preocupação.
**Datacenter:**
* Endereços IP privados alojados em centros de dados
* Oferecem maior velocidade, mas são menos fiáveis em termos de anonimato
* Mais propensos a ser detetados e bloqueados por websites e serviços de Internet.
#### Residencial
* Um endereço IP real associado a uma localização física
* A webscraping parecerá vir de uma casa residencial numa determinada localização
* Considerado mais legítimo e com menor probabilidade de ser bloqueado por websites
{% hint style="info" %}
Nota: usar um proxy residencial é mais caro do que usar o datacenter, por isso é bom comparar isto com o seu caso de uso ao decidir que proxy utilizar.
{% endhint %}
#### Cabeçalhos
Use este campo para passar cabeçalhos personalizados para o pedido de web scrape. Certifique-se de que os cabeçalhos estão formatados como JSON válido. Por exemplo:
```javascript
{
"authorization": "Bearer YOUR_API_KEY",
"Content-Type": "{{ a_variable }}"
}
```
### Tipo de saída
* **Texto:** Sem formatação incluída
* **HTML:** Extrair cabeçalhos e formatação de um website em HTML
* **Markdown:** Extrair os cabeçalhos de um website em markdown
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.airops.com/docs/pt/acoes/workflow-concepts/workflow-steps/web-research/web-page-scrape.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.