> For the complete documentation index, see [llms.txt](https://docs.airops.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.airops.com/docs/pt/acoes/workflow-concepts/workflow-steps/memory-steps/knowledge-base-read.md).
# Obter Ficheiro da Base de Conhecimento
Leia dados das suas Bases de Conhecimento usando filtros.
## O que é uma etapa de leitura da Base de Conhecimento?
A etapa de leitura da Base de Conhecimento permite consultar as suas Bases de Conhecimento usando filtros para obter quaisquer dados relevantes para uso nos seus fluxos de trabalho. Isto é especialmente útil ao fazer [Geração Aumentada por Recuperação](https://en.wikipedia.org/wiki/Retrieval-augmented_generation) (RAG).
A principal diferença entre esta etapa e a [Pesquisa na Base de Conhecimento](/docs/pt/acoes/workflow-concepts/workflow-steps/memory-steps/memory-search.md) etapa é que, enquanto na etapa de pesquisa, você pode fazer consultas e obter fragmentos de texto, a etapa de leitura permite aplicar filtros e obter documentos completos.
Para mais informações sobre como configurar uma Base de Conhecimento, consulte a nossa página de documentação [aqui](/docs/pt/contexto/memory-stores.md).
## Como Configurar uma Etapa de Leitura da Base de Conhecimento
### Selecionar uma Base de Conhecimento
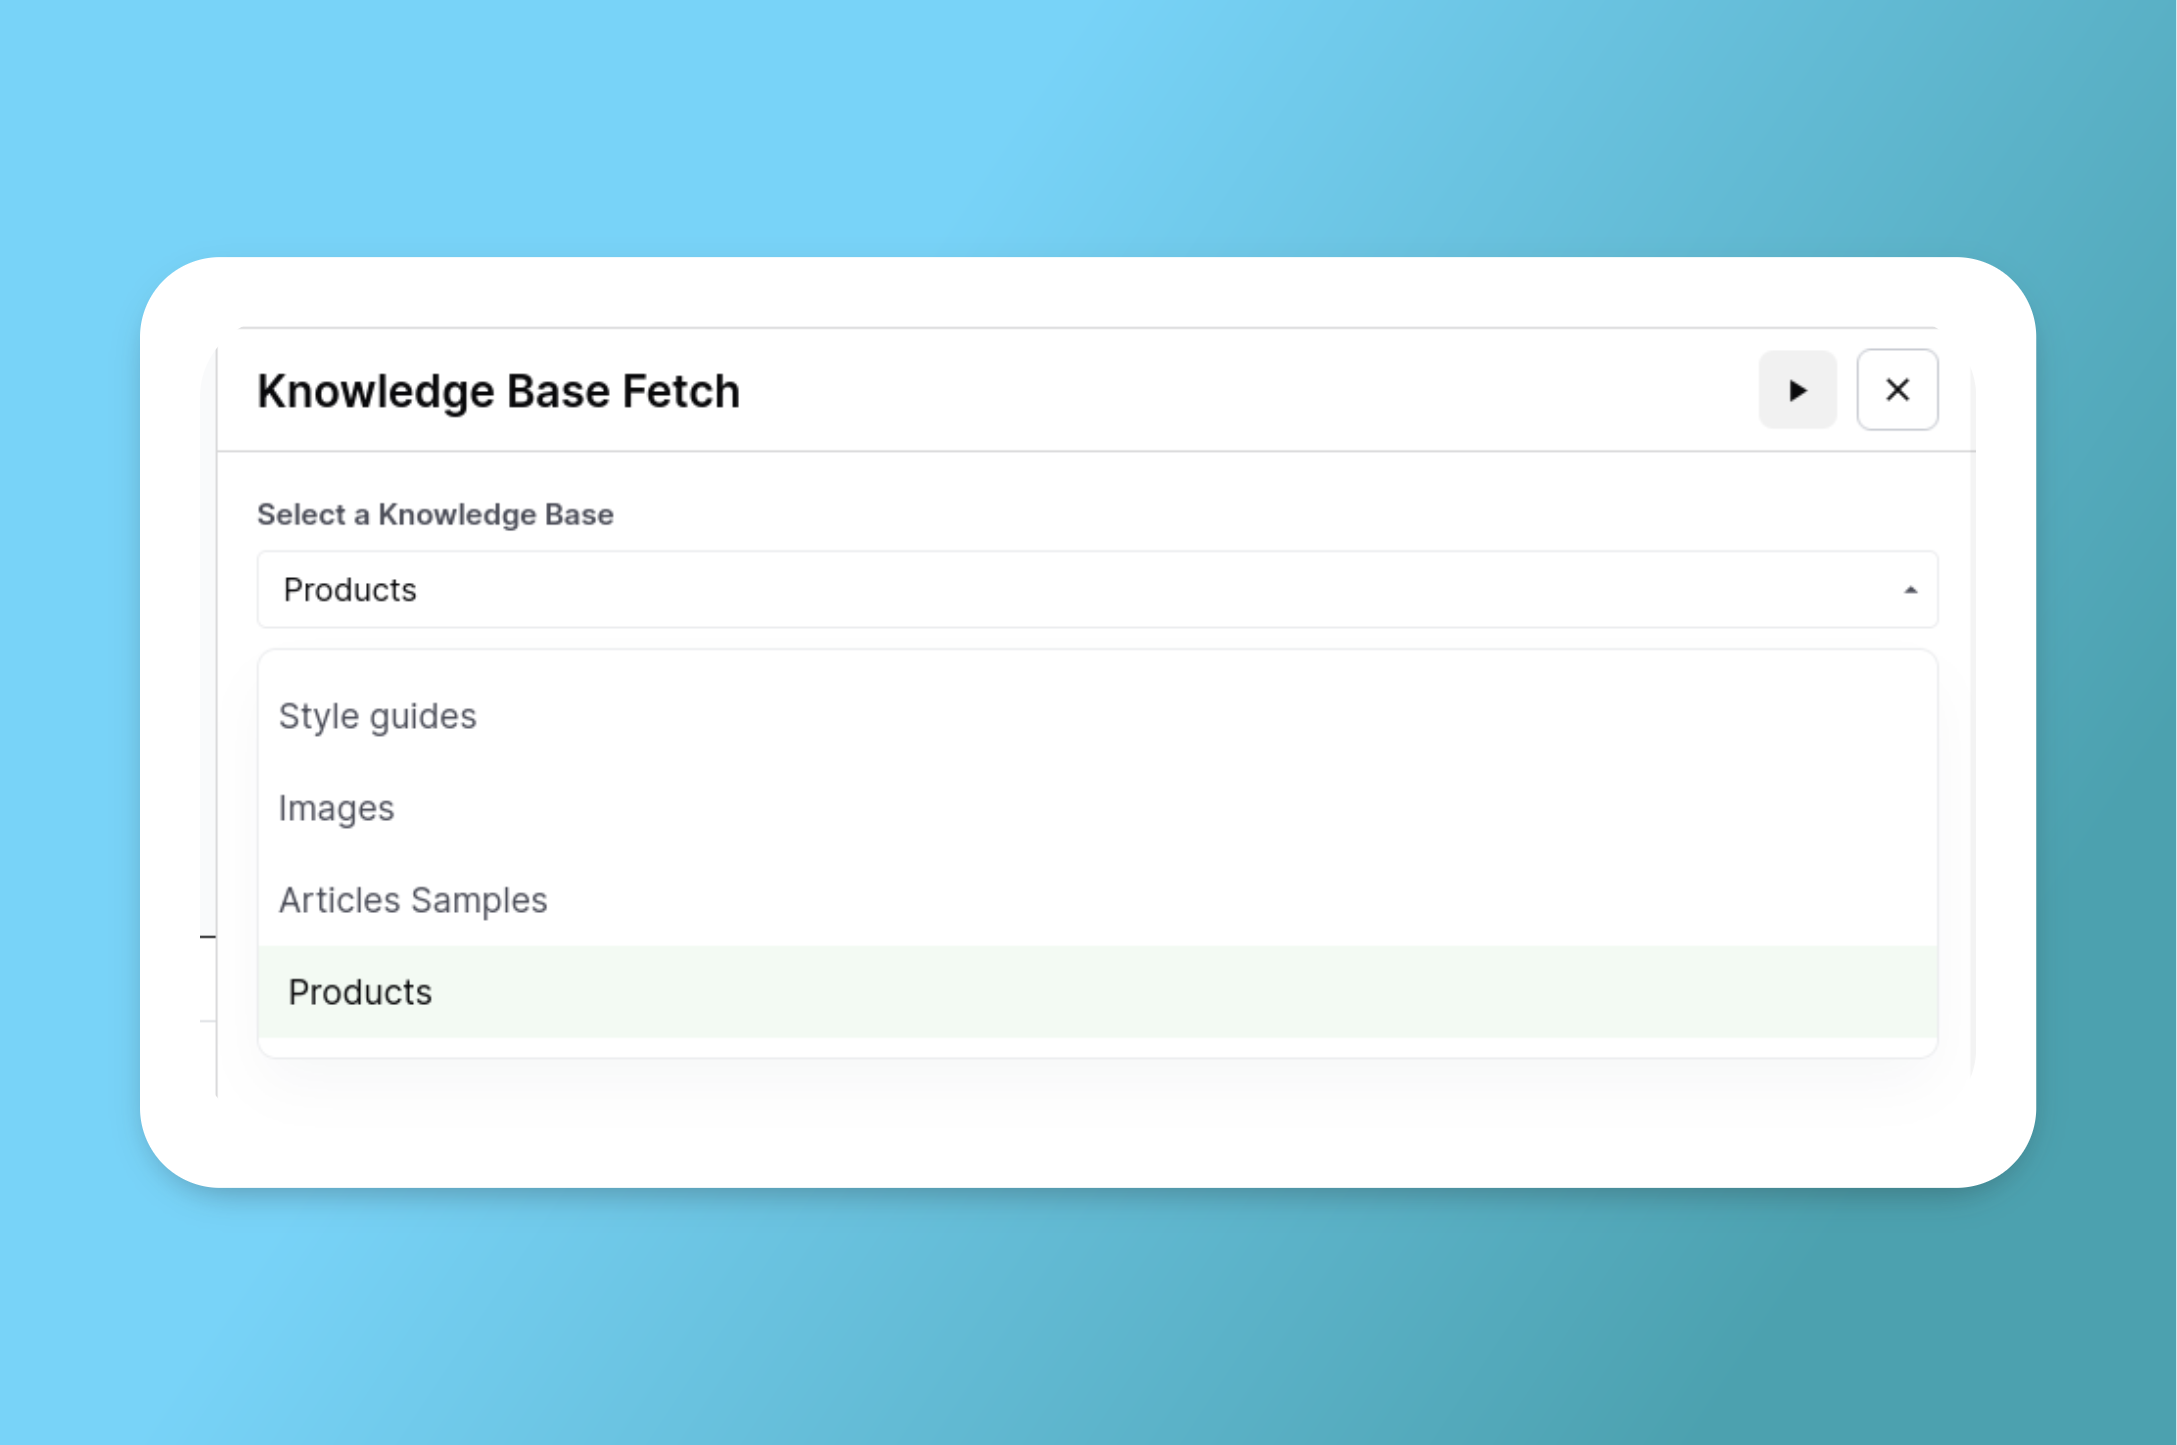
Selecione a Base de Conhecimento que deseja usar no menu suspenso.
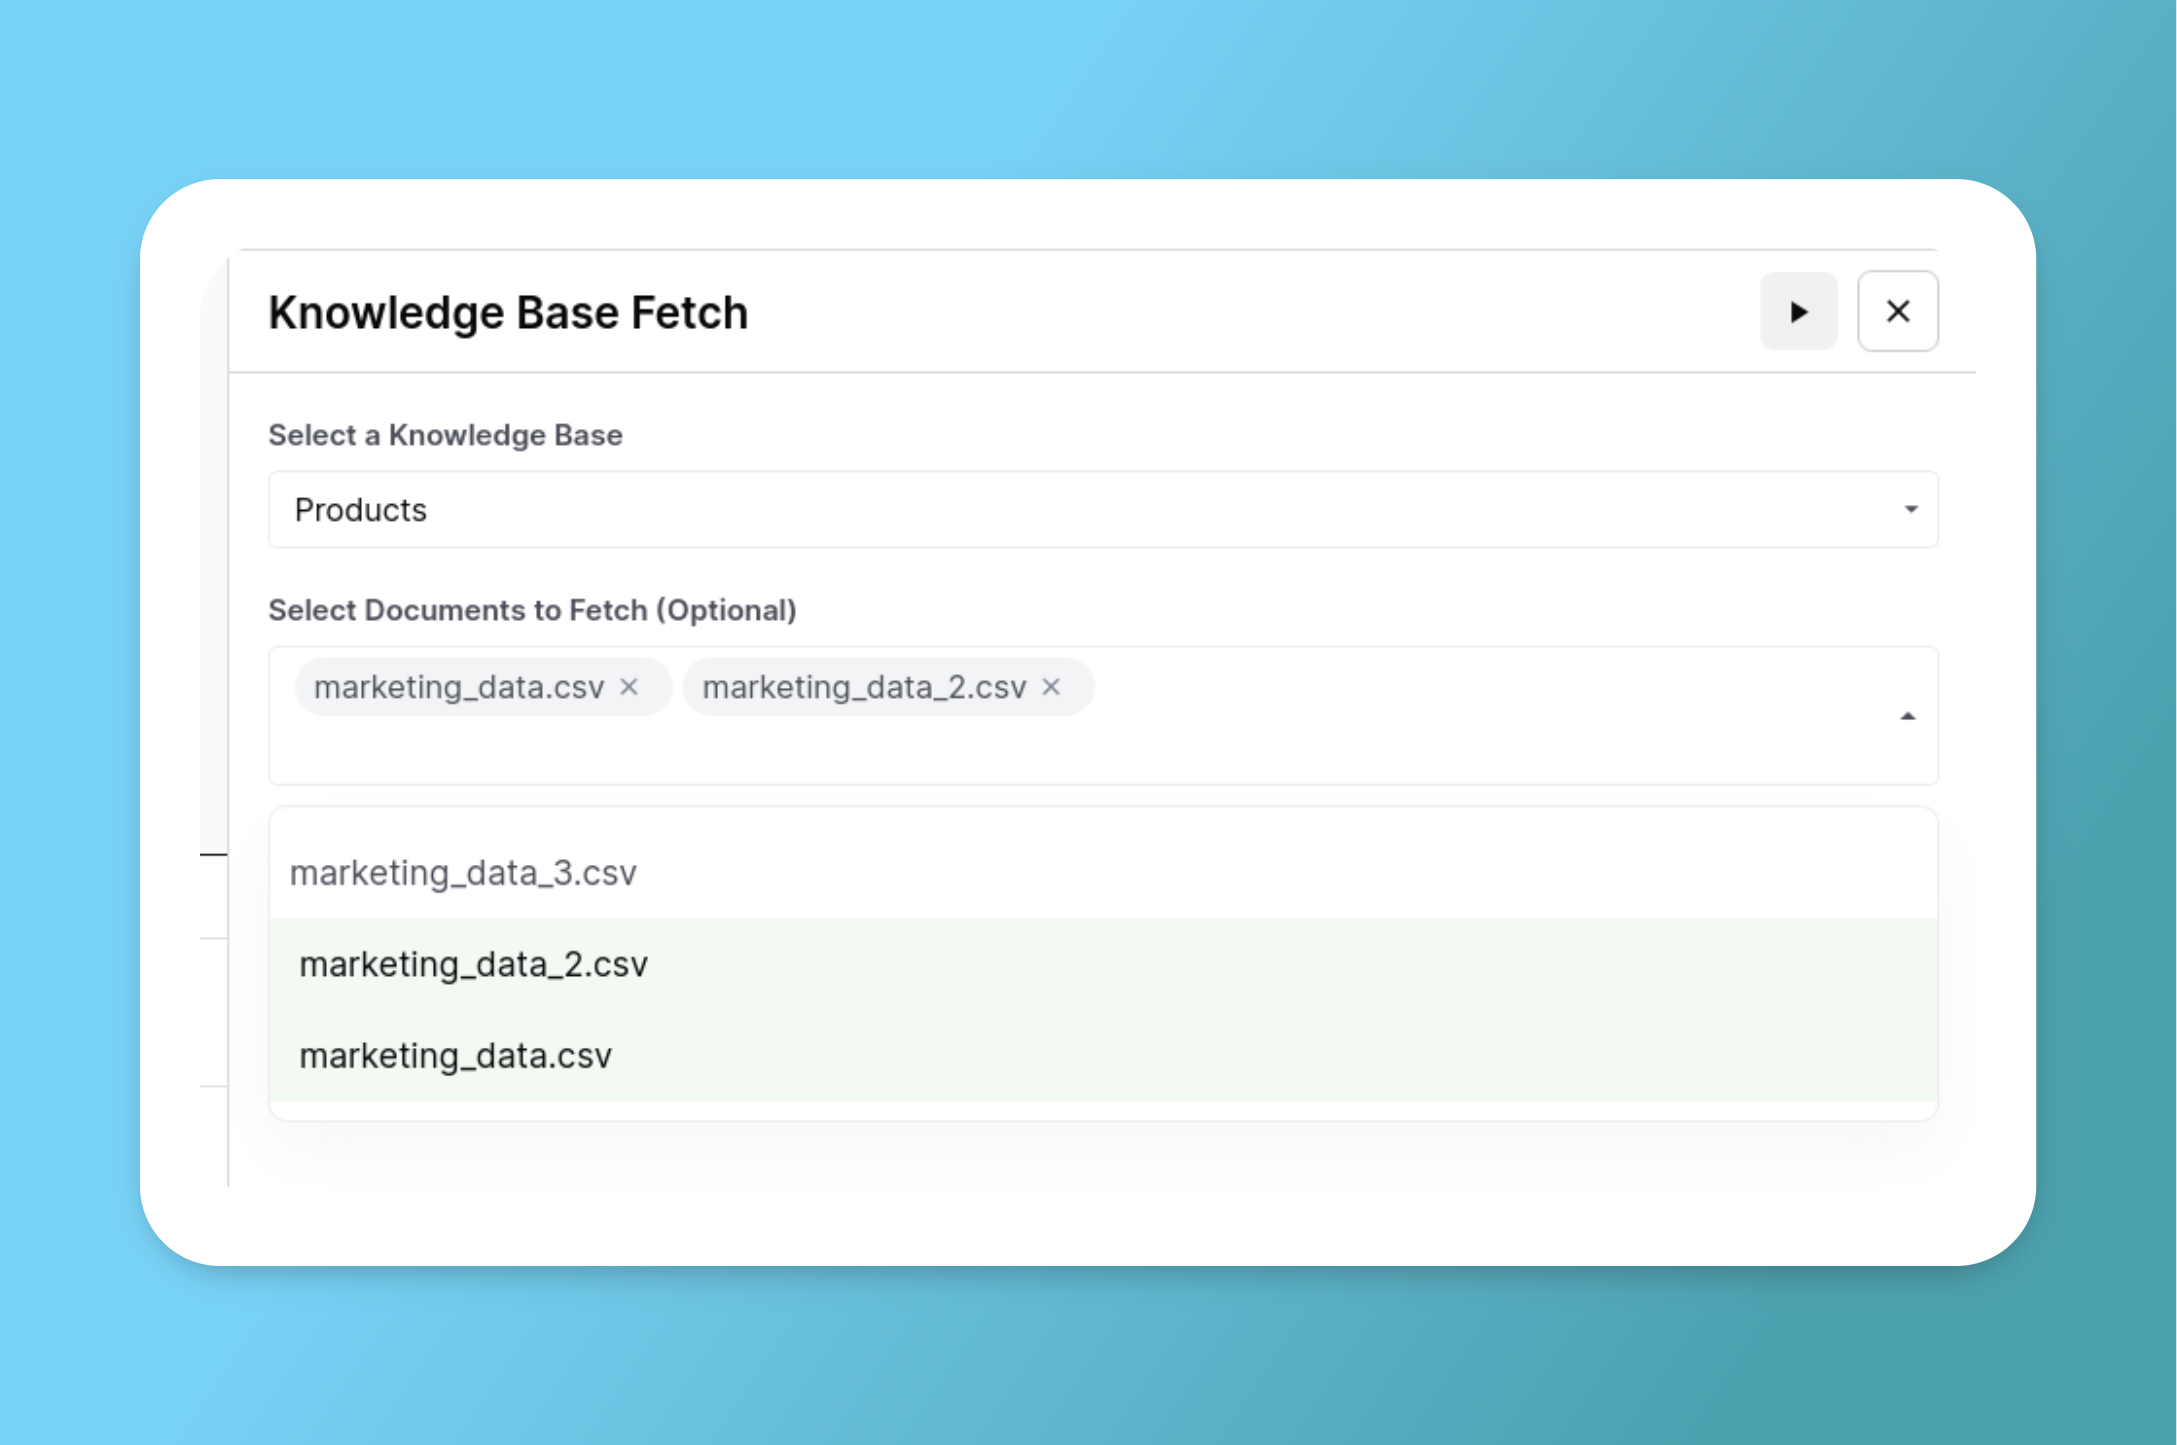
### Selecione ficheiros específicos (opcional)
Opcionalmente, você pode selecionar vários documentos que deseja ler de uma lista:
### Adicionar filtros (opcional)
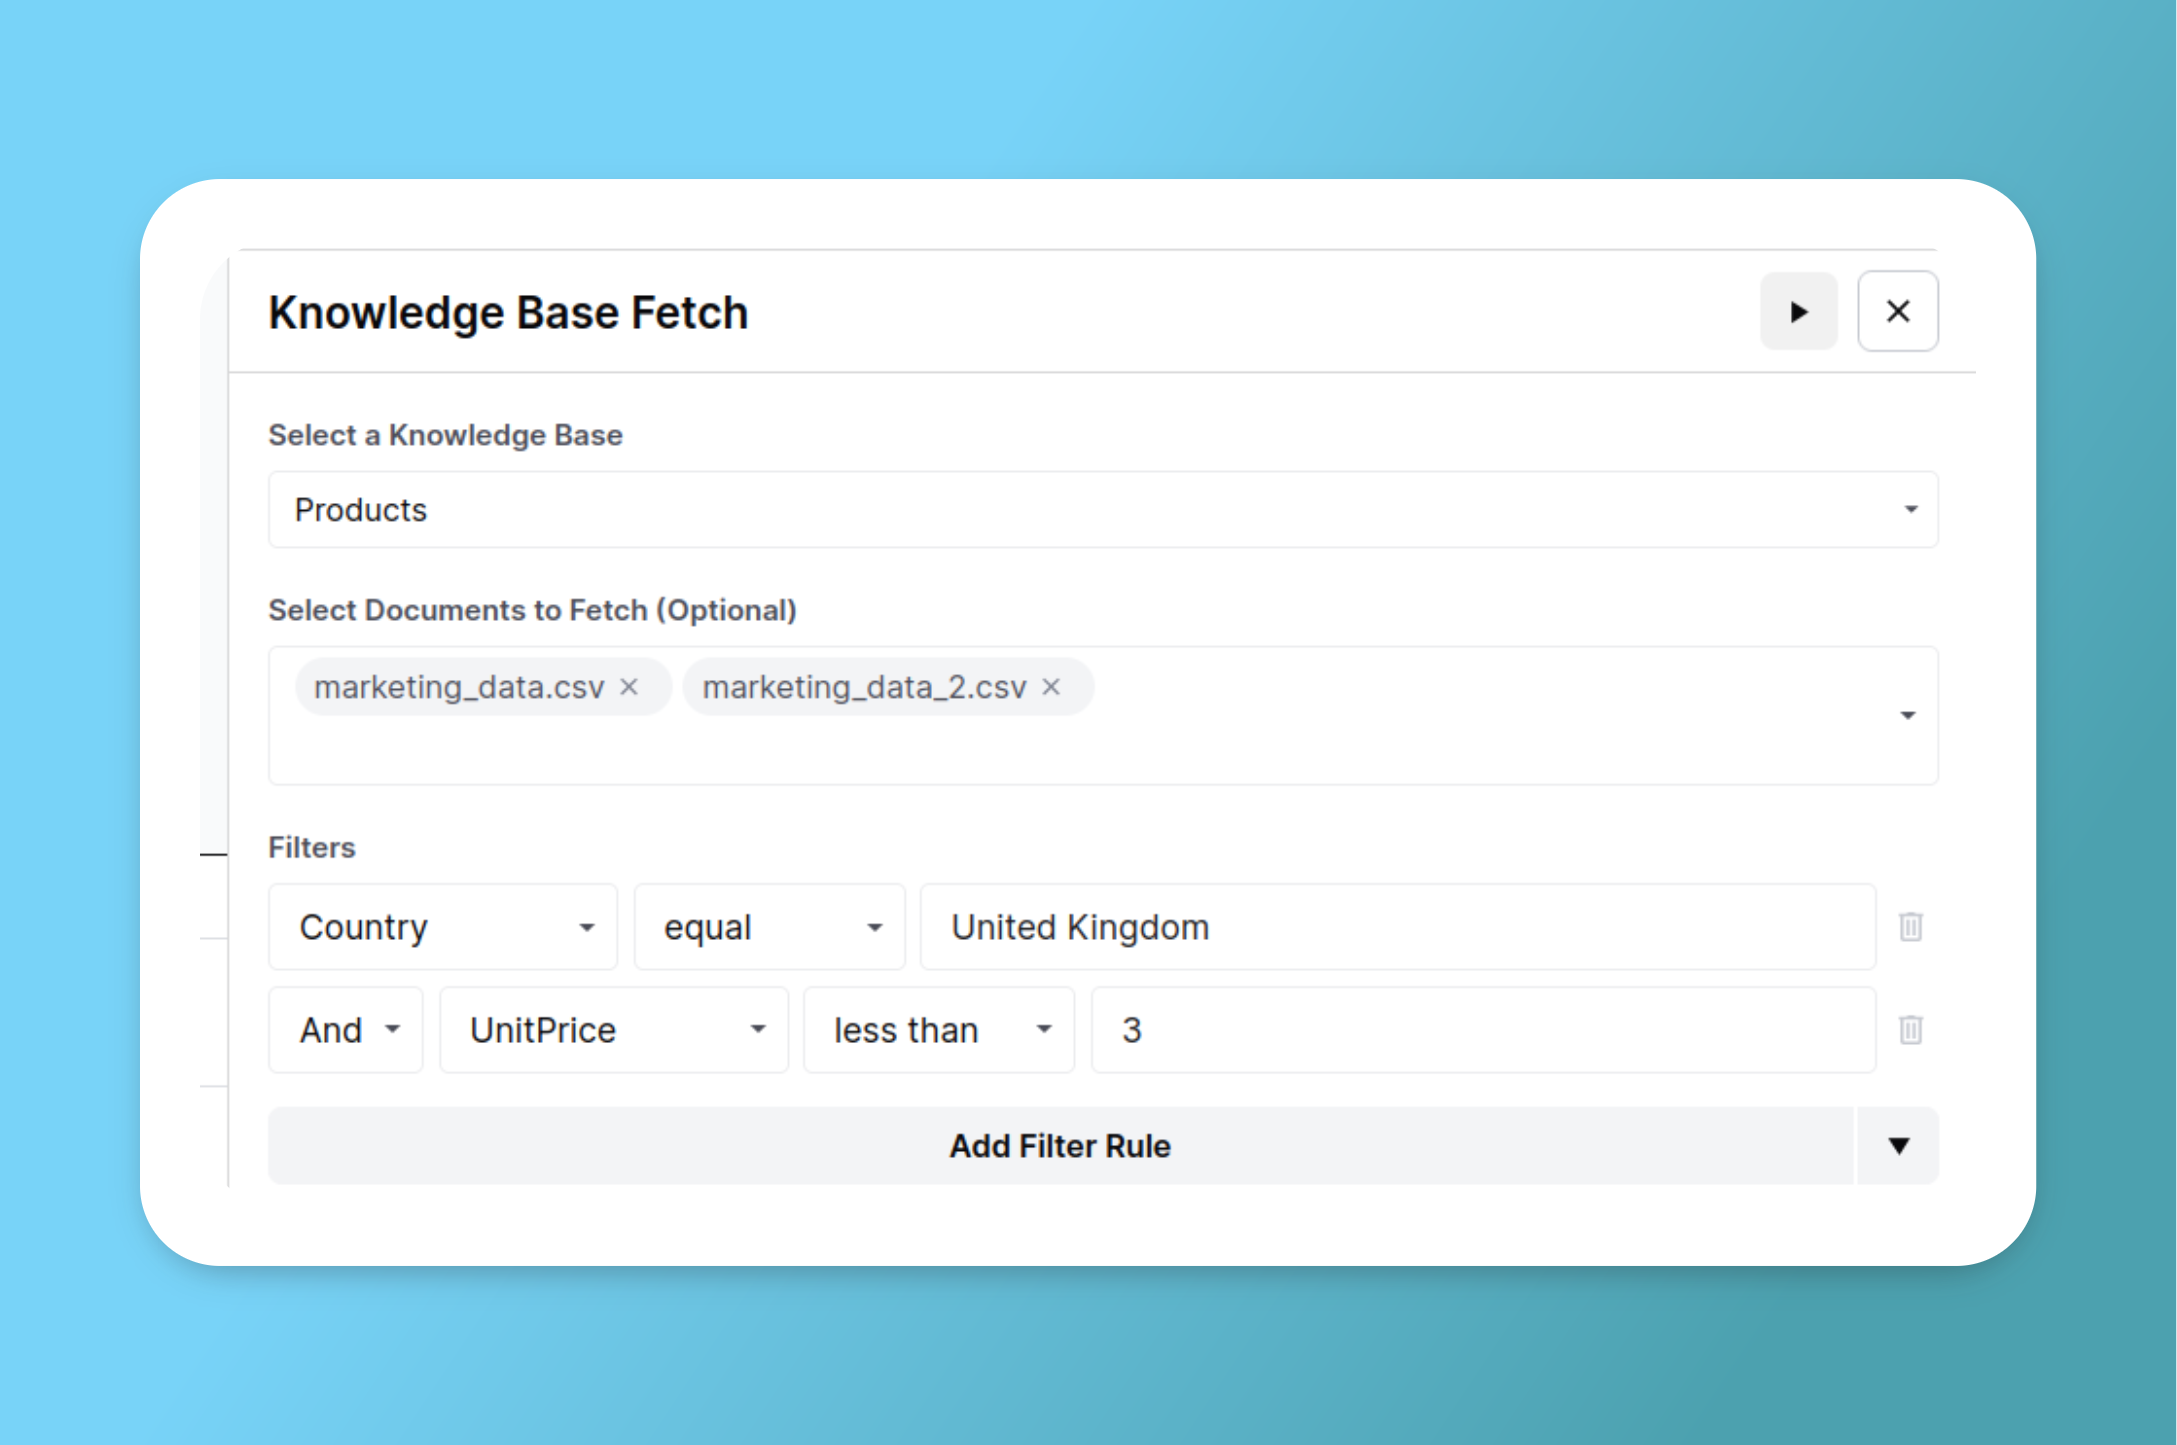
Você pode adicionar filtros para refinar os resultados com base em campos de metadados. Isso inclui:
* **Metadados padrão** herdados da origem (por exemplo, nome do ficheiro, URL de origem)
* **Metadados personalizados** que você adicionou para etiquetar ficheiros (por exemplo, país, produto, público)
* **Colunas de CSV/Folha de cálculo** quando a Base de Conhecimento contém dados estruturados
**Exemplo: Filtragem por Metadados Personalizados**
Se você tiver estudos de caso de clientes etiquetados com um `country` campo de metadados personalizado, você pode filtrar para recuperar apenas estudos de caso de uma região específica:
{% hint style="success" %}
**Filtragem dinâmica**
Use entradas do fluxo de trabalho para tornar os filtros dinâmicos. Por exemplo, defina o filtro como `country` é igual a `{{input.region}}` e o fluxo de trabalho recuperará ficheiros correspondentes à região que for passada em tempo de execução.
{% endhint %}
Para que a filtragem seja eficaz, recomendamos ler [Metadados das Bases de Conhecimento](/docs/pt/contexto/memory-stores/memory-stores-metadata.md) para aprender a adicionar etiquetas de metadados personalizados aos seus ficheiros da Base de Conhecimento.
## Saída da Etapa de Leitura da Base de Conhecimento
A etapa de leitura da Base de Conhecimento produzirá uma lista de documentos com os respetivos registos. No nosso exemplo anterior de produtos filtrados, a saída será assim:
```json
[
{
"document_name": "marketing_data.csv",
"records": [
{
"__text": "WHITE HANGING HEART T-LIGHT HOLDER\n\n-----\n\nReino Unido",
"InvoiceNo": 536365,
"StockCode": "85123A",
"Description": "WHITE HANGING HEART T-LIGHT HOLDER",
"Quantity": 6,
"InvoiceDate": "12/1/2010 8:26",
"UnitPrice": 2.55,
"CustomerID": 17850,
"Country": "Reino Unido"
},
...
]
},
{
"document_name": "marketing_data_2.csv",
"records": [
{
"__text": "CREAM CUPID HEARTS COAT HANGER\n\n-----\n\nReino Unido",
"InvoiceNo": 536365,
"StockCode": "84406B",
"Description": "CREAM CUPID HEARTS COAT HANGER",
"Quantity": 8,
"InvoiceDate": "12/1/2010 8:26",
"UnitPrice": 2.75,
"CustomerID": 17850,
"Country": "Reino Unido"
},
...
]
}
]
```
Pode notar que:
* Apenas os documentos selecionados no menu suspenso são devolvidos.
* Cada documento tem uma lista de registos associada. Como estes documentos são CSVs, cada registo representa uma linha diferente.
* Apenas os registos que correspondem aos filtros selecionados são devolvidos (Reino Unido e UnitPrice < 3).
* Existe um campo especial "\_\_text" que mostra qual é o texto pesquisável selecionado durante o carregamento do CSV. Como neste caso apenas as colunas "Description" e "Country" foram selecionadas como pesquisáveis, essas são as colunas incorporadas no campo "\_\_text".
O seguinte é um exemplo de saída da recuperação de um documento PDF:
```json
[
{
"document_name": "US_Congress-2023-SB546-Enrolled.pdf",
"records": [
{
"__text": "S. 546 \n\nCentésimo décimo oitavo Congresso dos Estados Unidos da América\n\nNA SEGUNDA SESSÃO\n\nIniciado e realizado na cidade de Washington na quarta-feira, o terceiro dia de janeiro de dois mil e vinte e quatro\n\nUma lei\n\nPara alterar a Lei Omnibus de Controle do Crime e Ruas Seguras de 1968 para autorizar agências de aplicação da lei a usar subsídios COPS para atividades de recrutamento, e para outros fins...",
"__languages": [
"eng"
],
}
]
}
]
```
## Usando a saída da etapa para fazer RAG
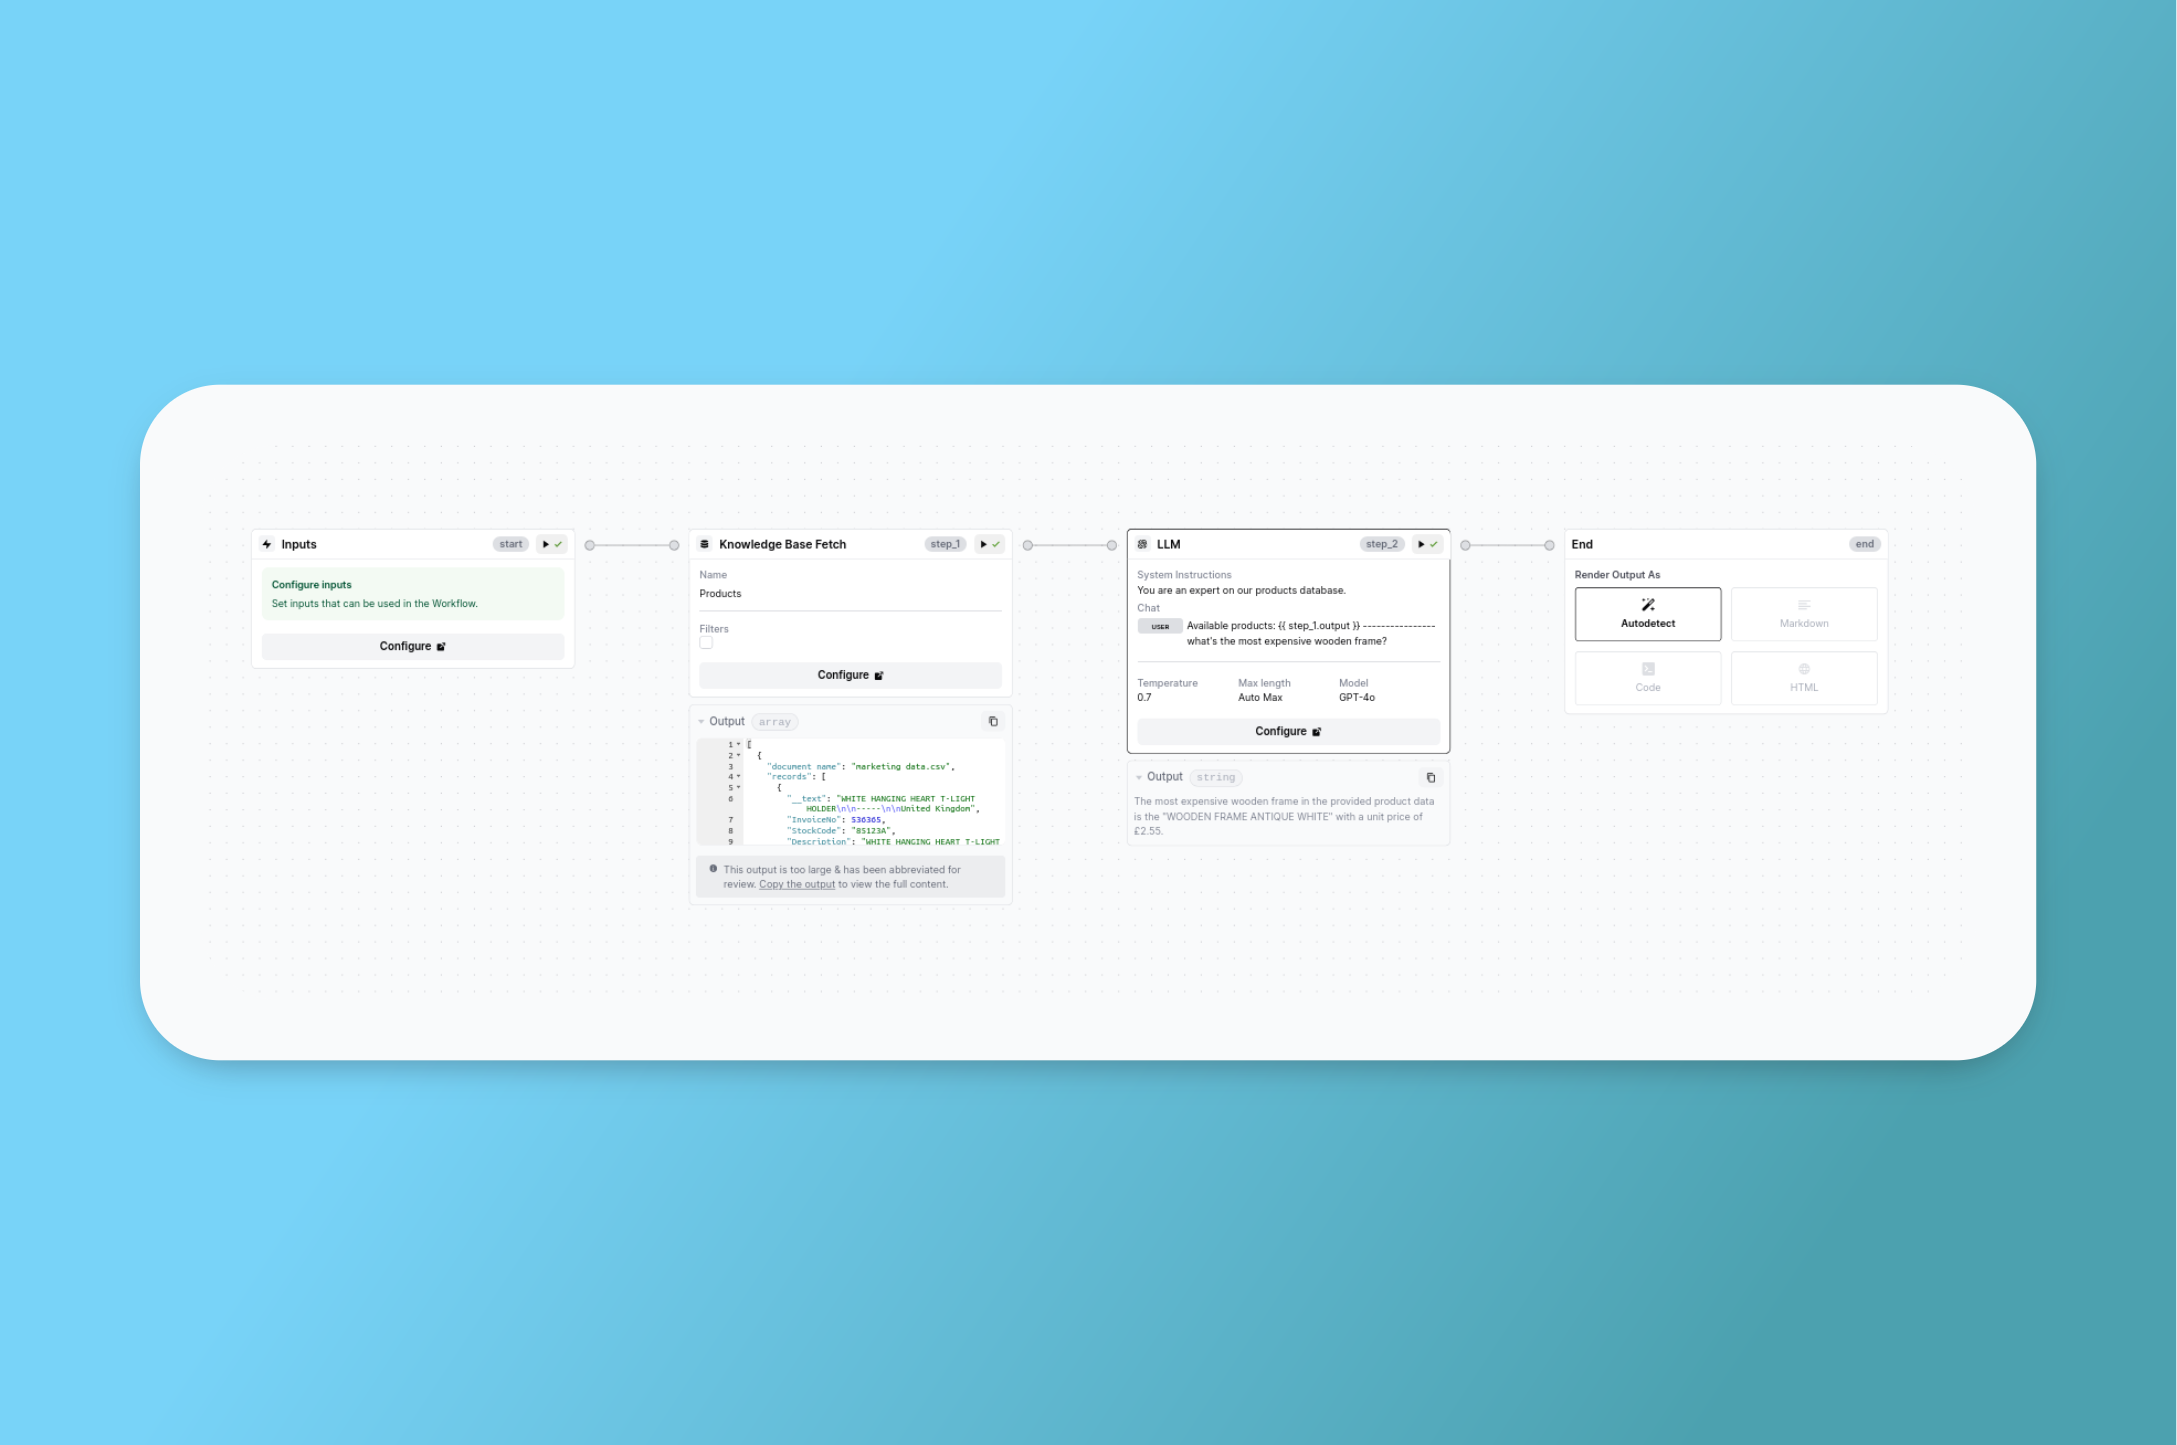
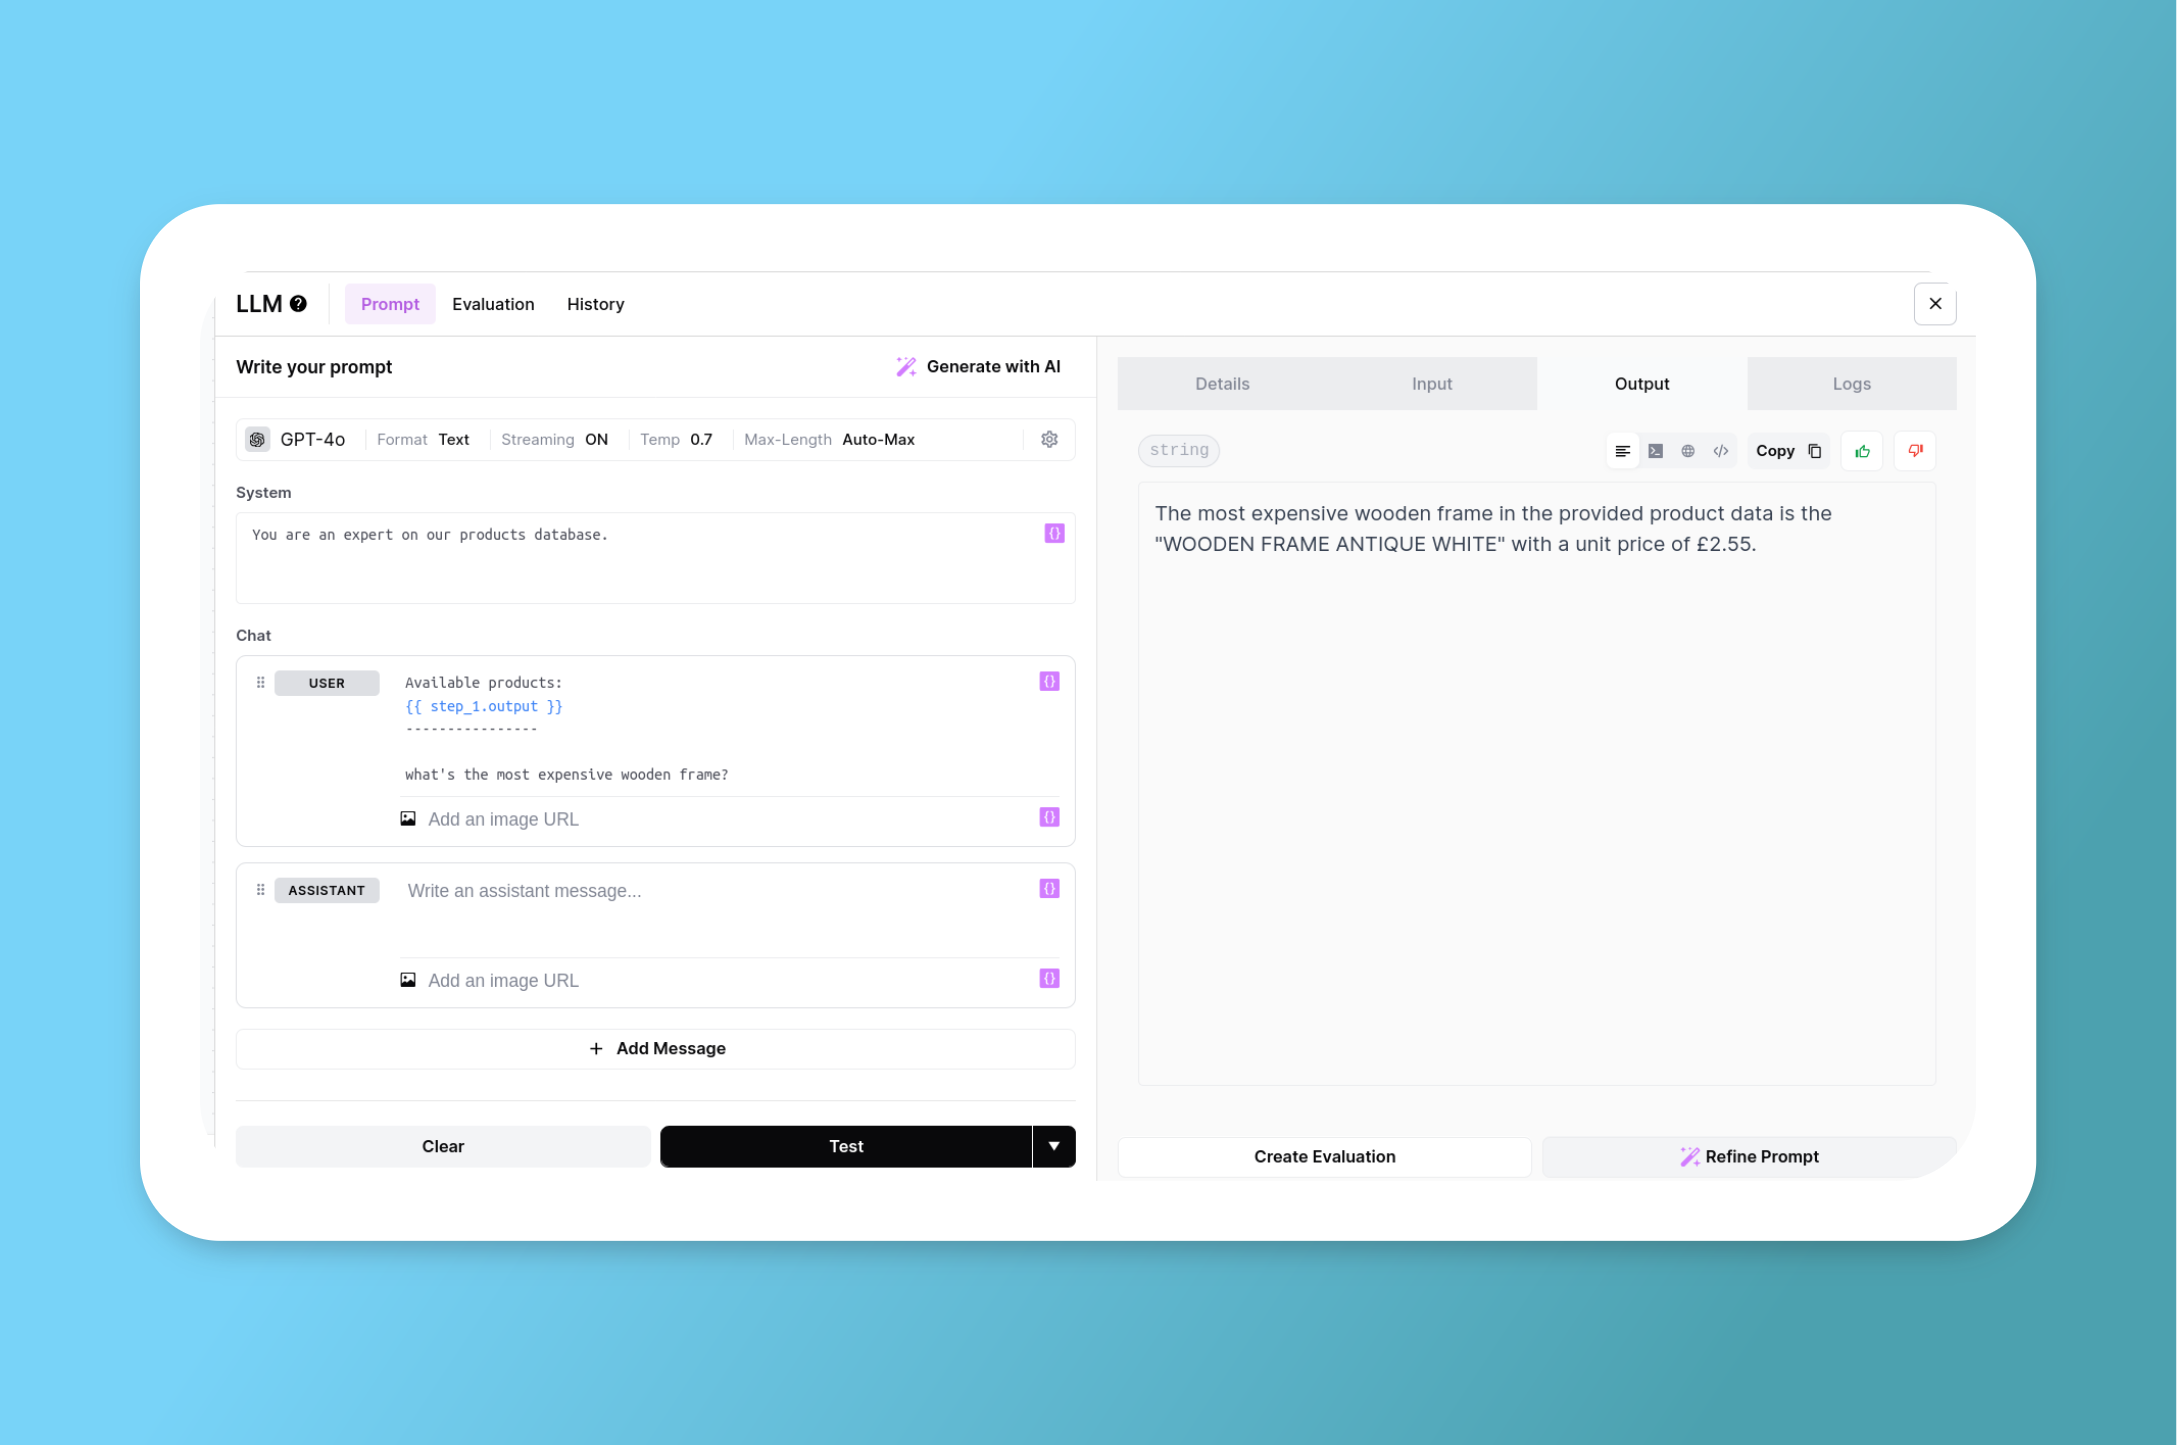
Podemos passar a saída da etapa de busca da Base de Conhecimento para uma etapa de LLM para fazer Geração Aumentada por Recuperação.
Seguindo o nosso exemplo de produtos, podemos recuperar a lista completa de produtos e passá-la para uma etapa de LLM assim:
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.airops.com/docs/pt/acoes/workflow-concepts/workflow-steps/memory-steps/knowledge-base-read.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.