> For the complete documentation index, see [llms.txt](https://docs.airops.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.airops.com/docs/fr/actions/workflow-concepts/workflow-steps/web-research/web-page-scrape.md).
# Extraction de page web
Extrayez du texte, du Markdown ou du HTML d'un site web
L’étape « Web Page Scrape » vous permet d’automatiser l’extraction de texte/Markdown/HTML à partir d’une URL spécifique. Vous pouvez la combiner avec une étape d’itération pour extraire des données de plusieurs sites web, et analyser la sortie séparément.
## Configuration de l’étape « Web Page Scrape »
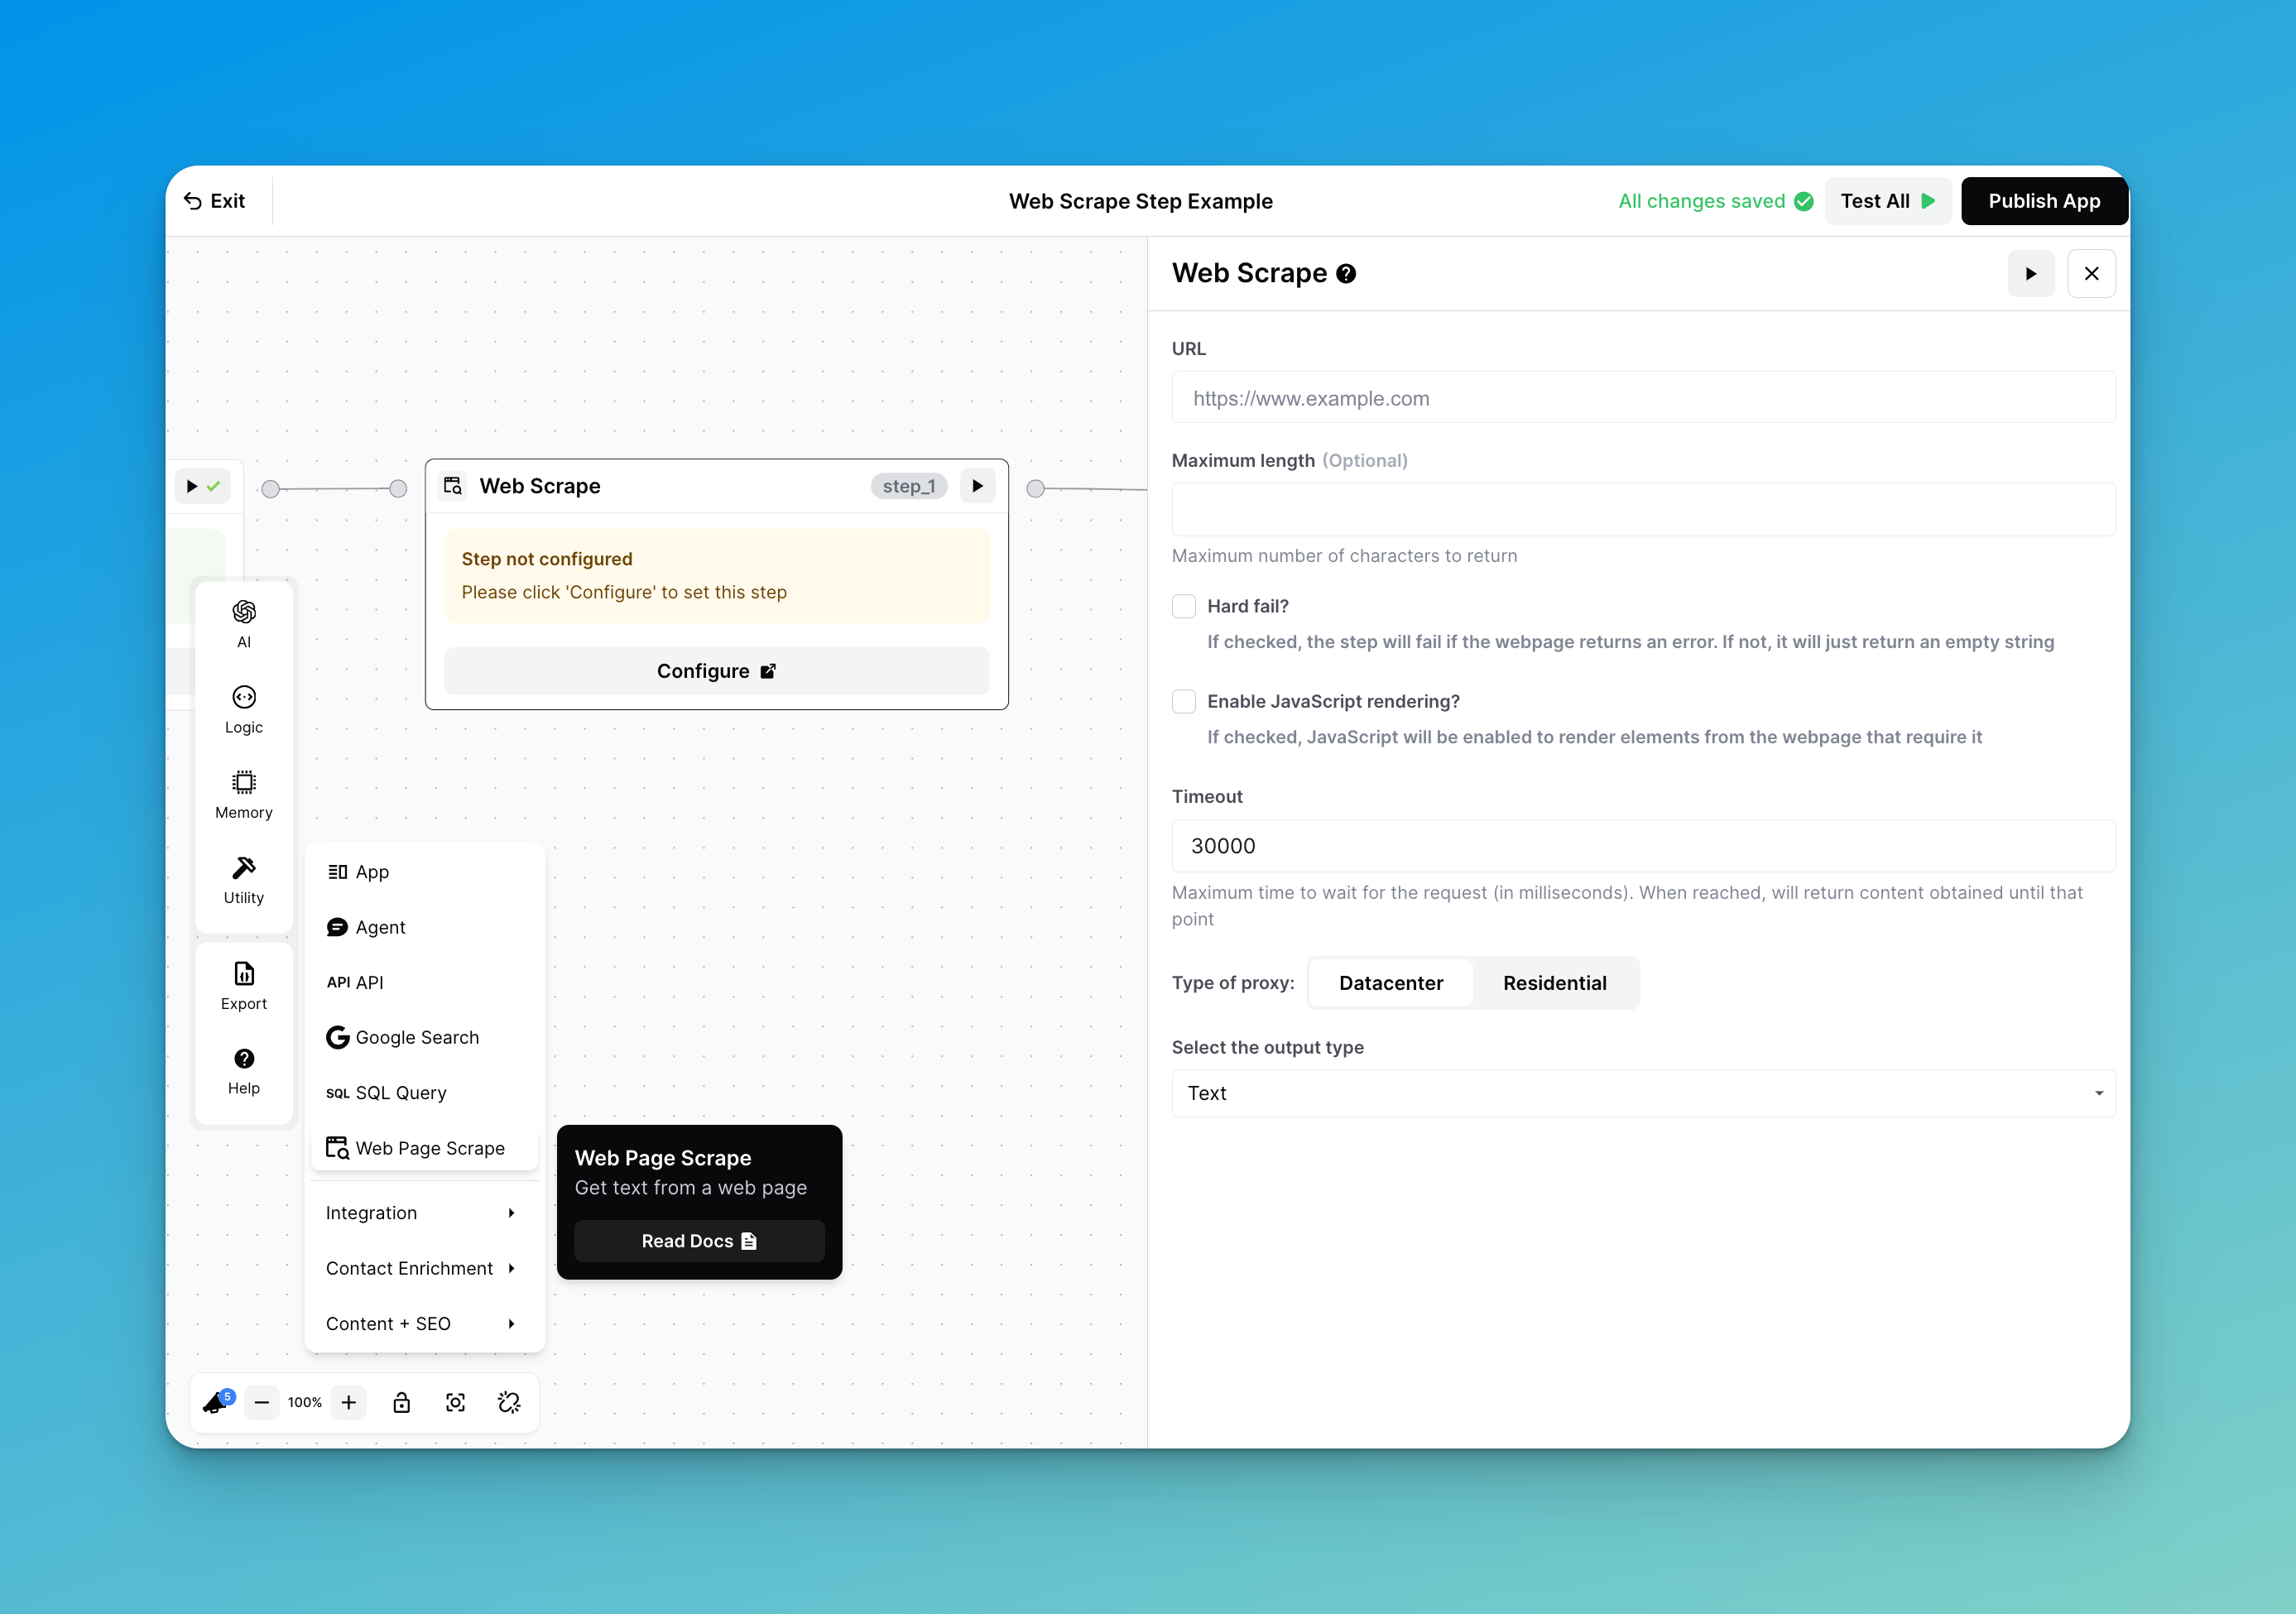
La configuration de l’étape nécessite de définir les paramètres ci-dessous :
Configurez vos paramètres Web Page Scrape
### URL
Ajoutez l’URL spécifique que vous souhaitez que l’étape scrape.
### Longueur maximale
Facultativement, vous pouvez limiter le nombre de caractères renvoyés par l’étape.
Ce paramètre peut être utile pour limiter la quantité de texte transmise à une étape LLM ultérieure, qui dispose d’une fenêtre de contexte limitée.
{% hint style="warning" %}
**1 jeton correspond approximativement à 4 caractères en anglais.** Pour estimer le nombre de caractères que vous devez transmettre à une étape LLM, multipliez le nombre de jetons que vous souhaitez transmettre par 4.
{% endhint %}
### Comment continuer si l’étape Web Scrape échoue
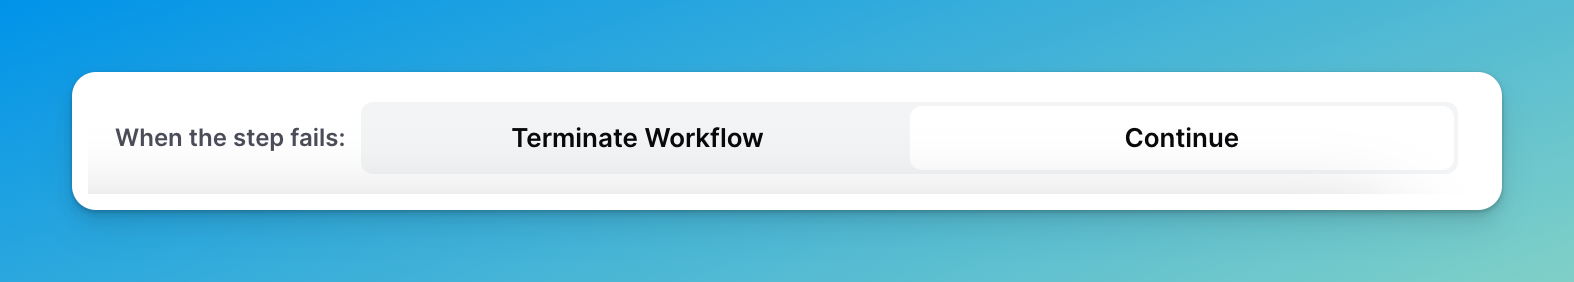
Par défaut, l’étape de code mettra fin au workflow en cas d’échec. Cependant, pour continuer le workflow si l’étape échoue, cliquez simplement sur `Continuer` en bas de l’étape.
Cliquez sur continuer pour poursuivre le workflow
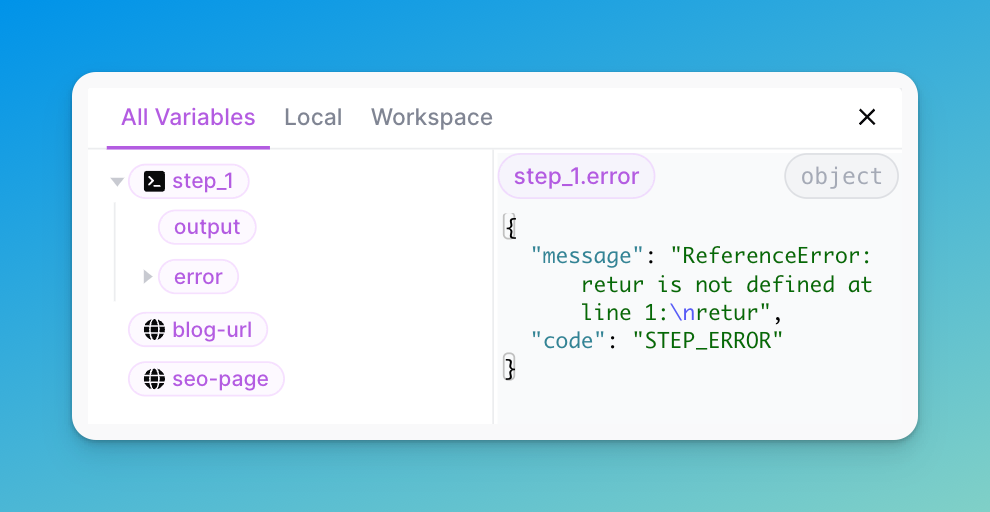
L’étape renverra les clés suivantes :
* `output` : ce sera `null`
* `error` :
* `message` : le message renvoyé par l’étape
* `code` : le code d’erreur représentant l’erreur
### Activer le rendu JavaScript ?
Par défaut, l’étape Web Page Scrape ne rendra pas les sites web qui utilisent JavaScript.
Cochez cette case pour activer l’extraction à partir de sites web qui utilisent JavaScript afin d’aider à rendre le contenu dynamique (par exemple Facebook, Airbnb, et bien d’autres).
### Délai d’attente
Le temps maximal d’attente, en millisecondes, pour le retour de vos résultats extraits du web.
### Type de proxy :
Utilisez la **proxy résidentiel** pour les sites qui exigent une plus grande fiabilité et des taux de réussite plus élevés. En revanche, utilisez le **proxy de centre de données** là où la fiabilité et les taux de réussite ne sont pas une préoccupation.
**Centre de données :**
* Des adresses IP privées hébergées dans des centres de données
* Offrent une vitesse plus élevée mais sont moins fiables en termes d’anonymat
* Plus susceptibles d’être détectés et bloqués par les sites web et les services Internet.
#### Résidentiel
* Une adresse IP réelle associée à un emplacement physique
* L’extraction web apparaîtra comme si elle provenait d’un domicile résidentiel situé dans un certain lieu
* Considéré comme plus légitime et moins susceptible d’être bloqué par les sites web
{% hint style="info" %}
Remarque : l’utilisation d’un proxy résidentiel est plus coûteuse que l’utilisation du centre de données, il est donc judicieux de l’évaluer par rapport à votre cas d’usage au moment de décider quel proxy utiliser.
{% endhint %}
#### En-têtes
Utilisez ce champ pour transmettre des en-têtes personnalisés pour la requête d’extraction web. Assurez-vous que les en-têtes sont formatés en JSON valide. Par exemple :
```javascript
{
"authorization": "Bearer YOUR_API_KEY",
"Content-Type": "{{ a_variable }}"
}
```
### Type de sortie
* **Texte :** Aucun formatage inclus
* **HTML :** Extraire les en-têtes et la mise en forme d’un site web en HTML
* **Markdown :** Extraire les en-têtes d’un site web en Markdown
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.airops.com/docs/fr/actions/workflow-concepts/workflow-steps/web-research/web-page-scrape.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.