> For the complete documentation index, see [llms.txt](https://docs.airops.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.airops.com/docs/fr/actions/workflow-concepts/workflow-steps/memory-steps/knowledge-base-read.md).
# Obtenir le fichier de la base de connaissances
Lisez les données de vos bases de connaissances à l'aide de filtres.
## Qu'est-ce qu'une étape de lecture de base de connaissances ?
L'étape de lecture de base de connaissances vous permet d'interroger vos bases de connaissances à l'aide de filtres afin d'obtenir toutes les données pertinentes à utiliser dans vos workflows. C'est particulièrement utile pour faire [Génération augmentée par récupération](https://en.wikipedia.org/wiki/Retrieval-augmented_generation) (RAG).
La principale différence entre cette étape et la [Recherche dans la base de connaissances](/docs/fr/actions/workflow-concepts/workflow-steps/memory-steps/memory-search.md) étape est que, tandis que dans l'étape de recherche, vous pouvez effectuer des requêtes et obtenir des segments de texte, l'étape de lecture vous permet d'appliquer des filtres et d'obtenir des documents complets.
Pour plus d'informations sur la configuration d'une base de connaissances, consultez notre page de documentation [ici](/docs/fr/contexte/memory-stores.md).
## Comment configurer une étape de lecture de base de connaissances
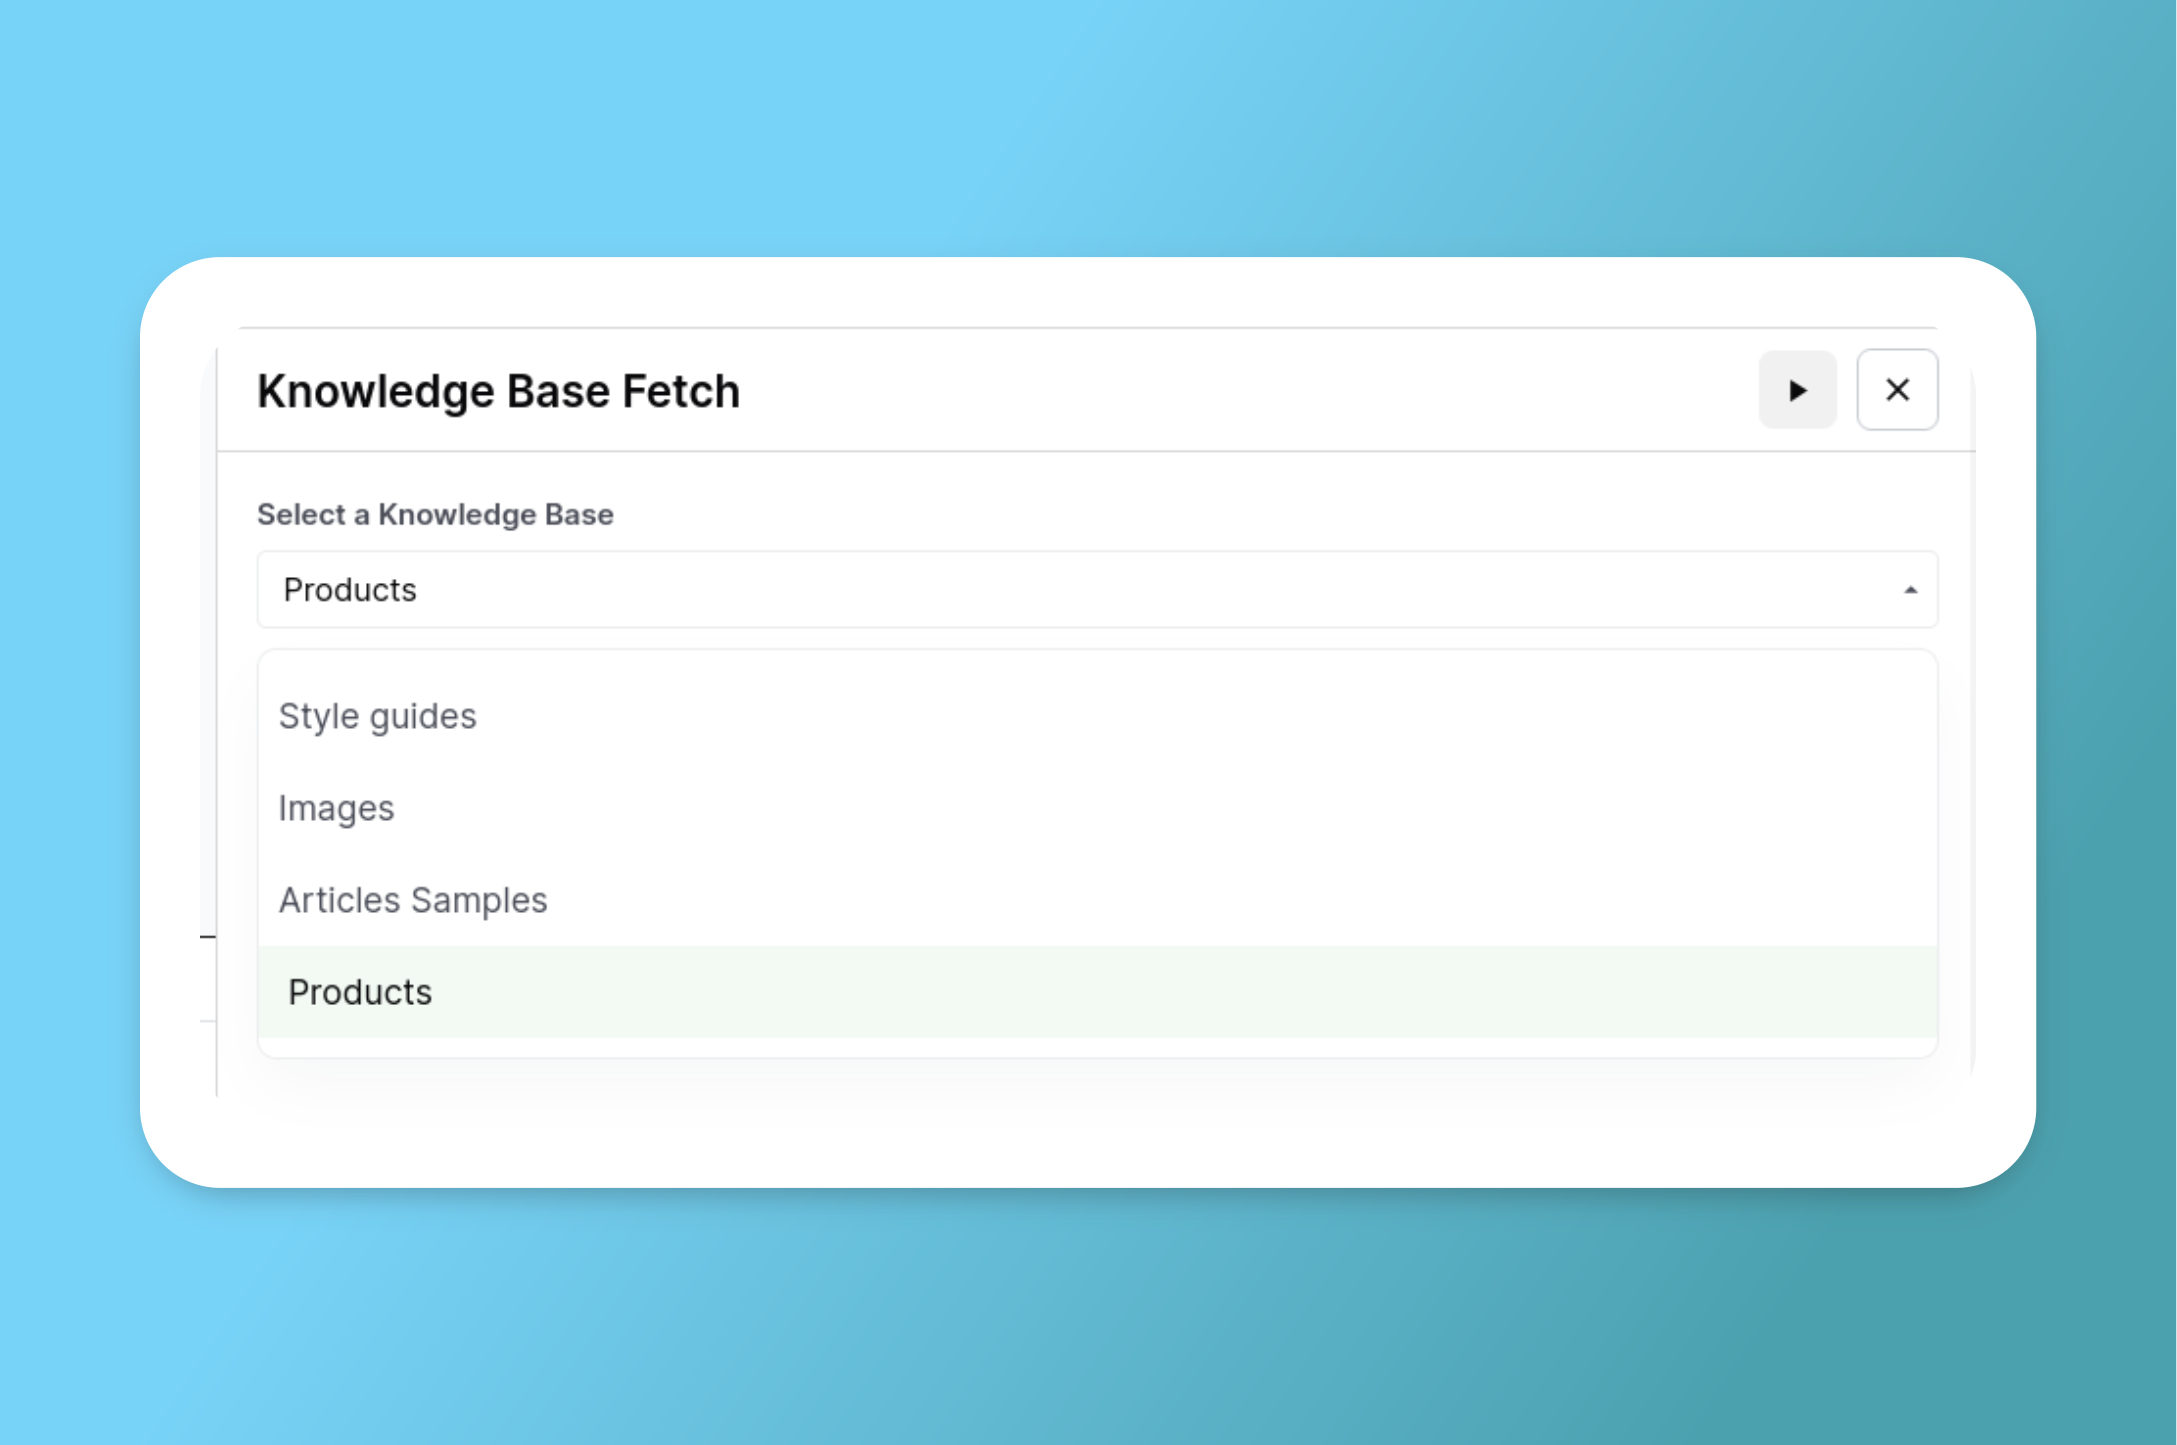
### Sélectionnez une base de connaissances
Sélectionnez la base de connaissances que vous souhaitez utiliser dans la liste déroulante.
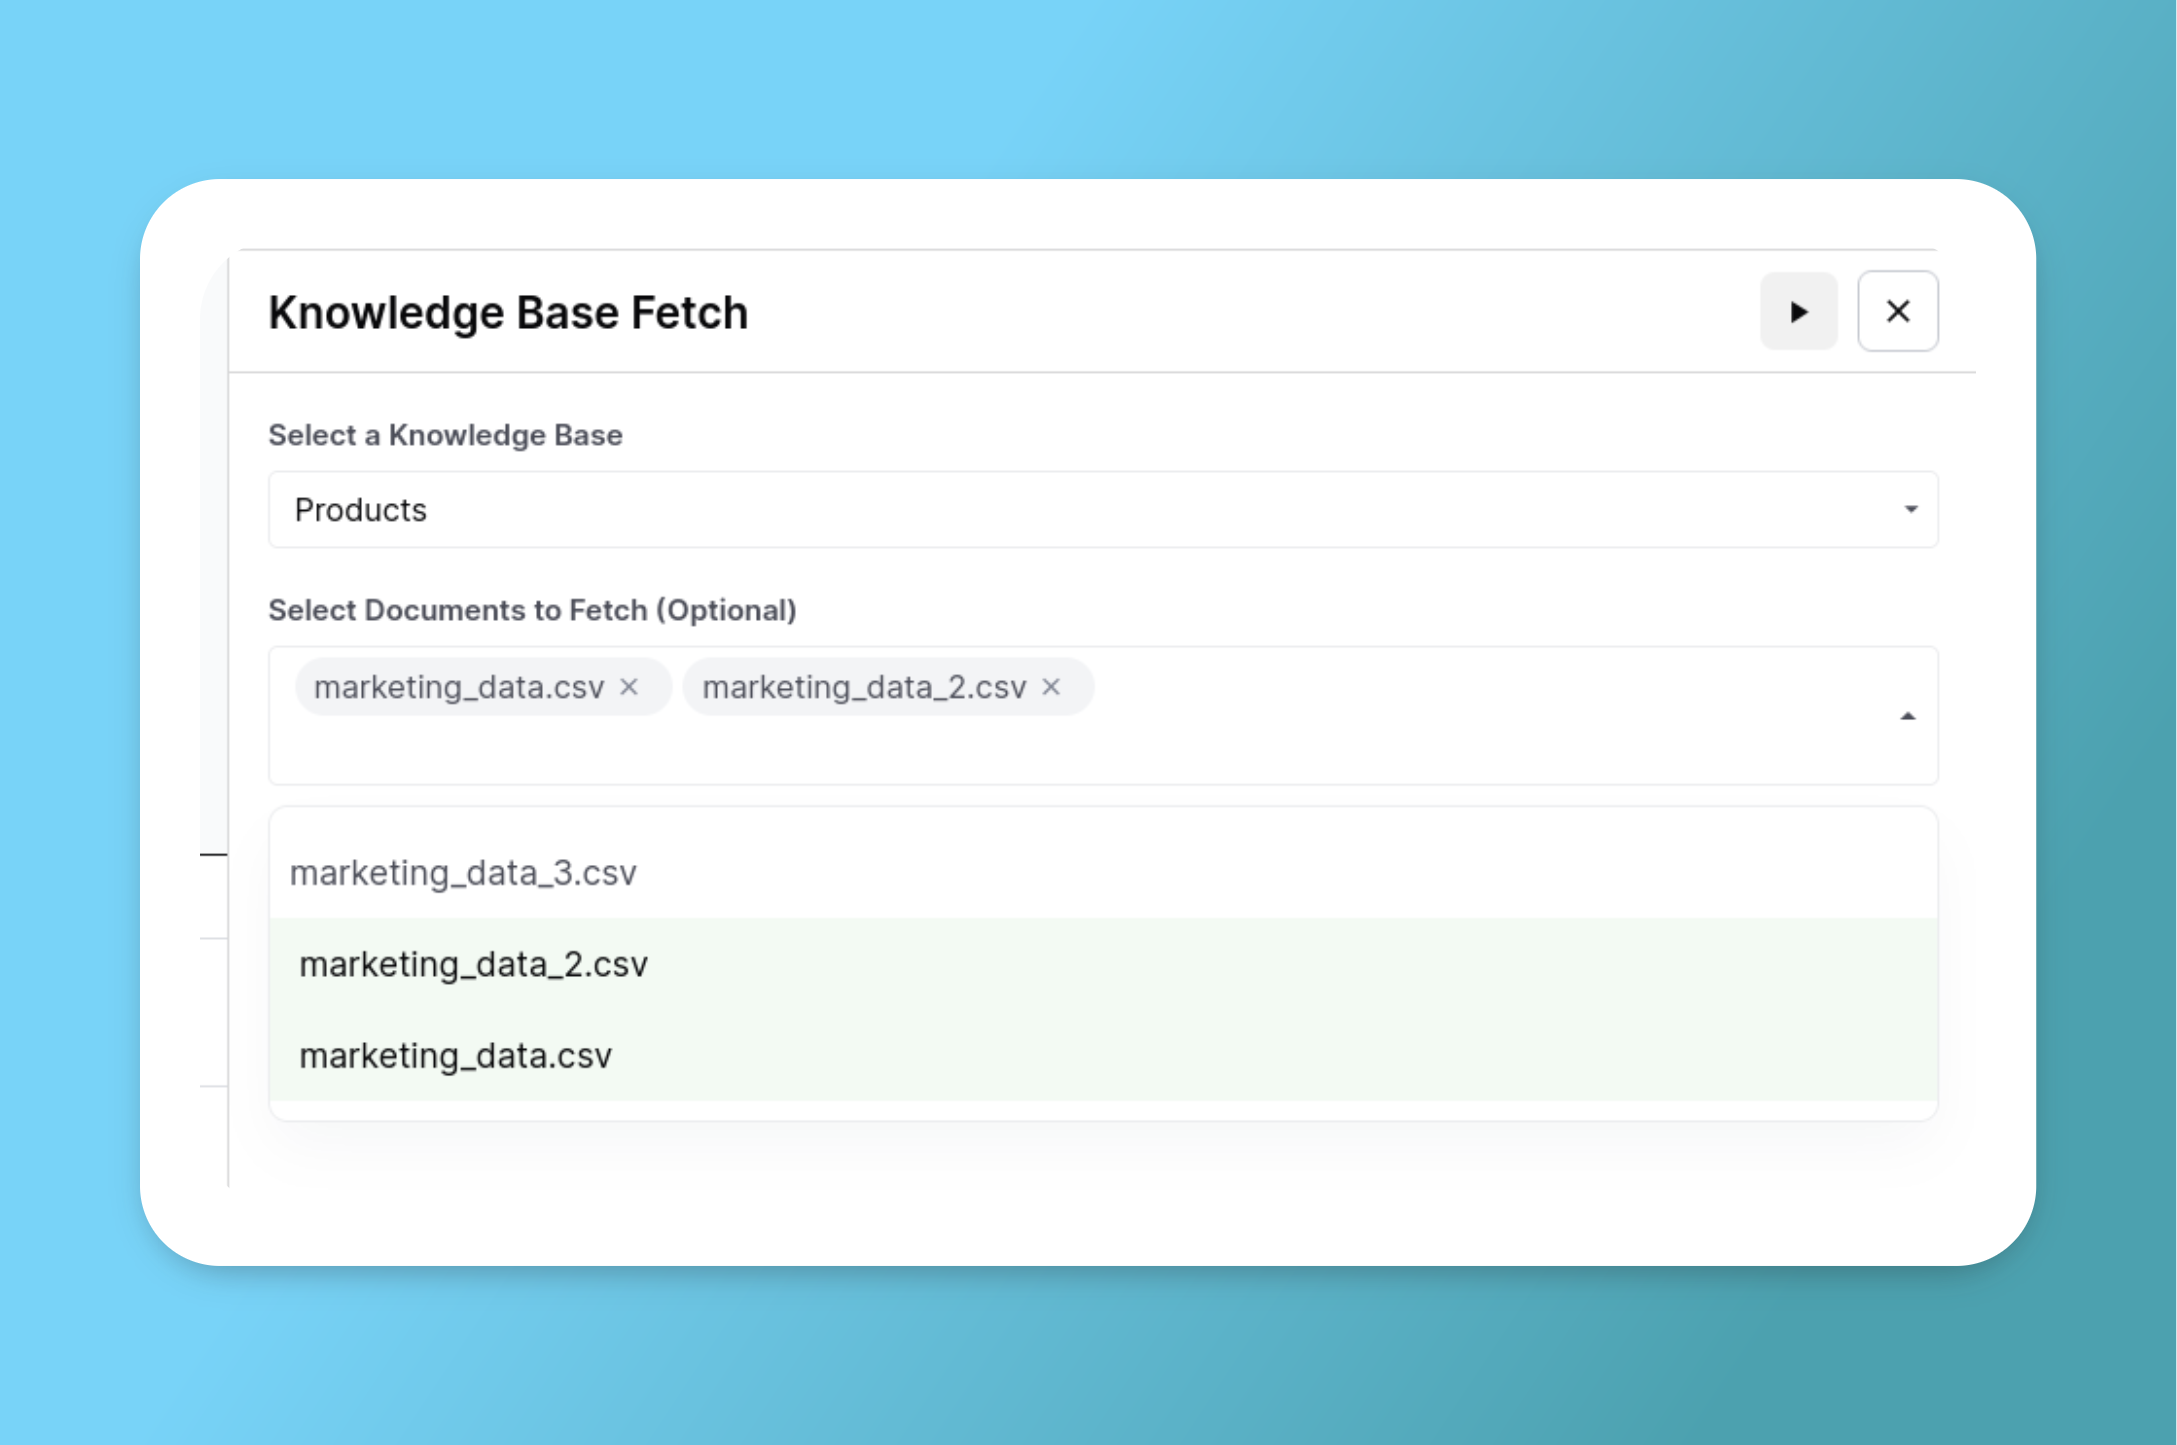
### Sélectionnez des fichiers spécifiques (facultatif)
Vous pouvez éventuellement sélectionner plusieurs documents que vous souhaitez lire dans une liste :
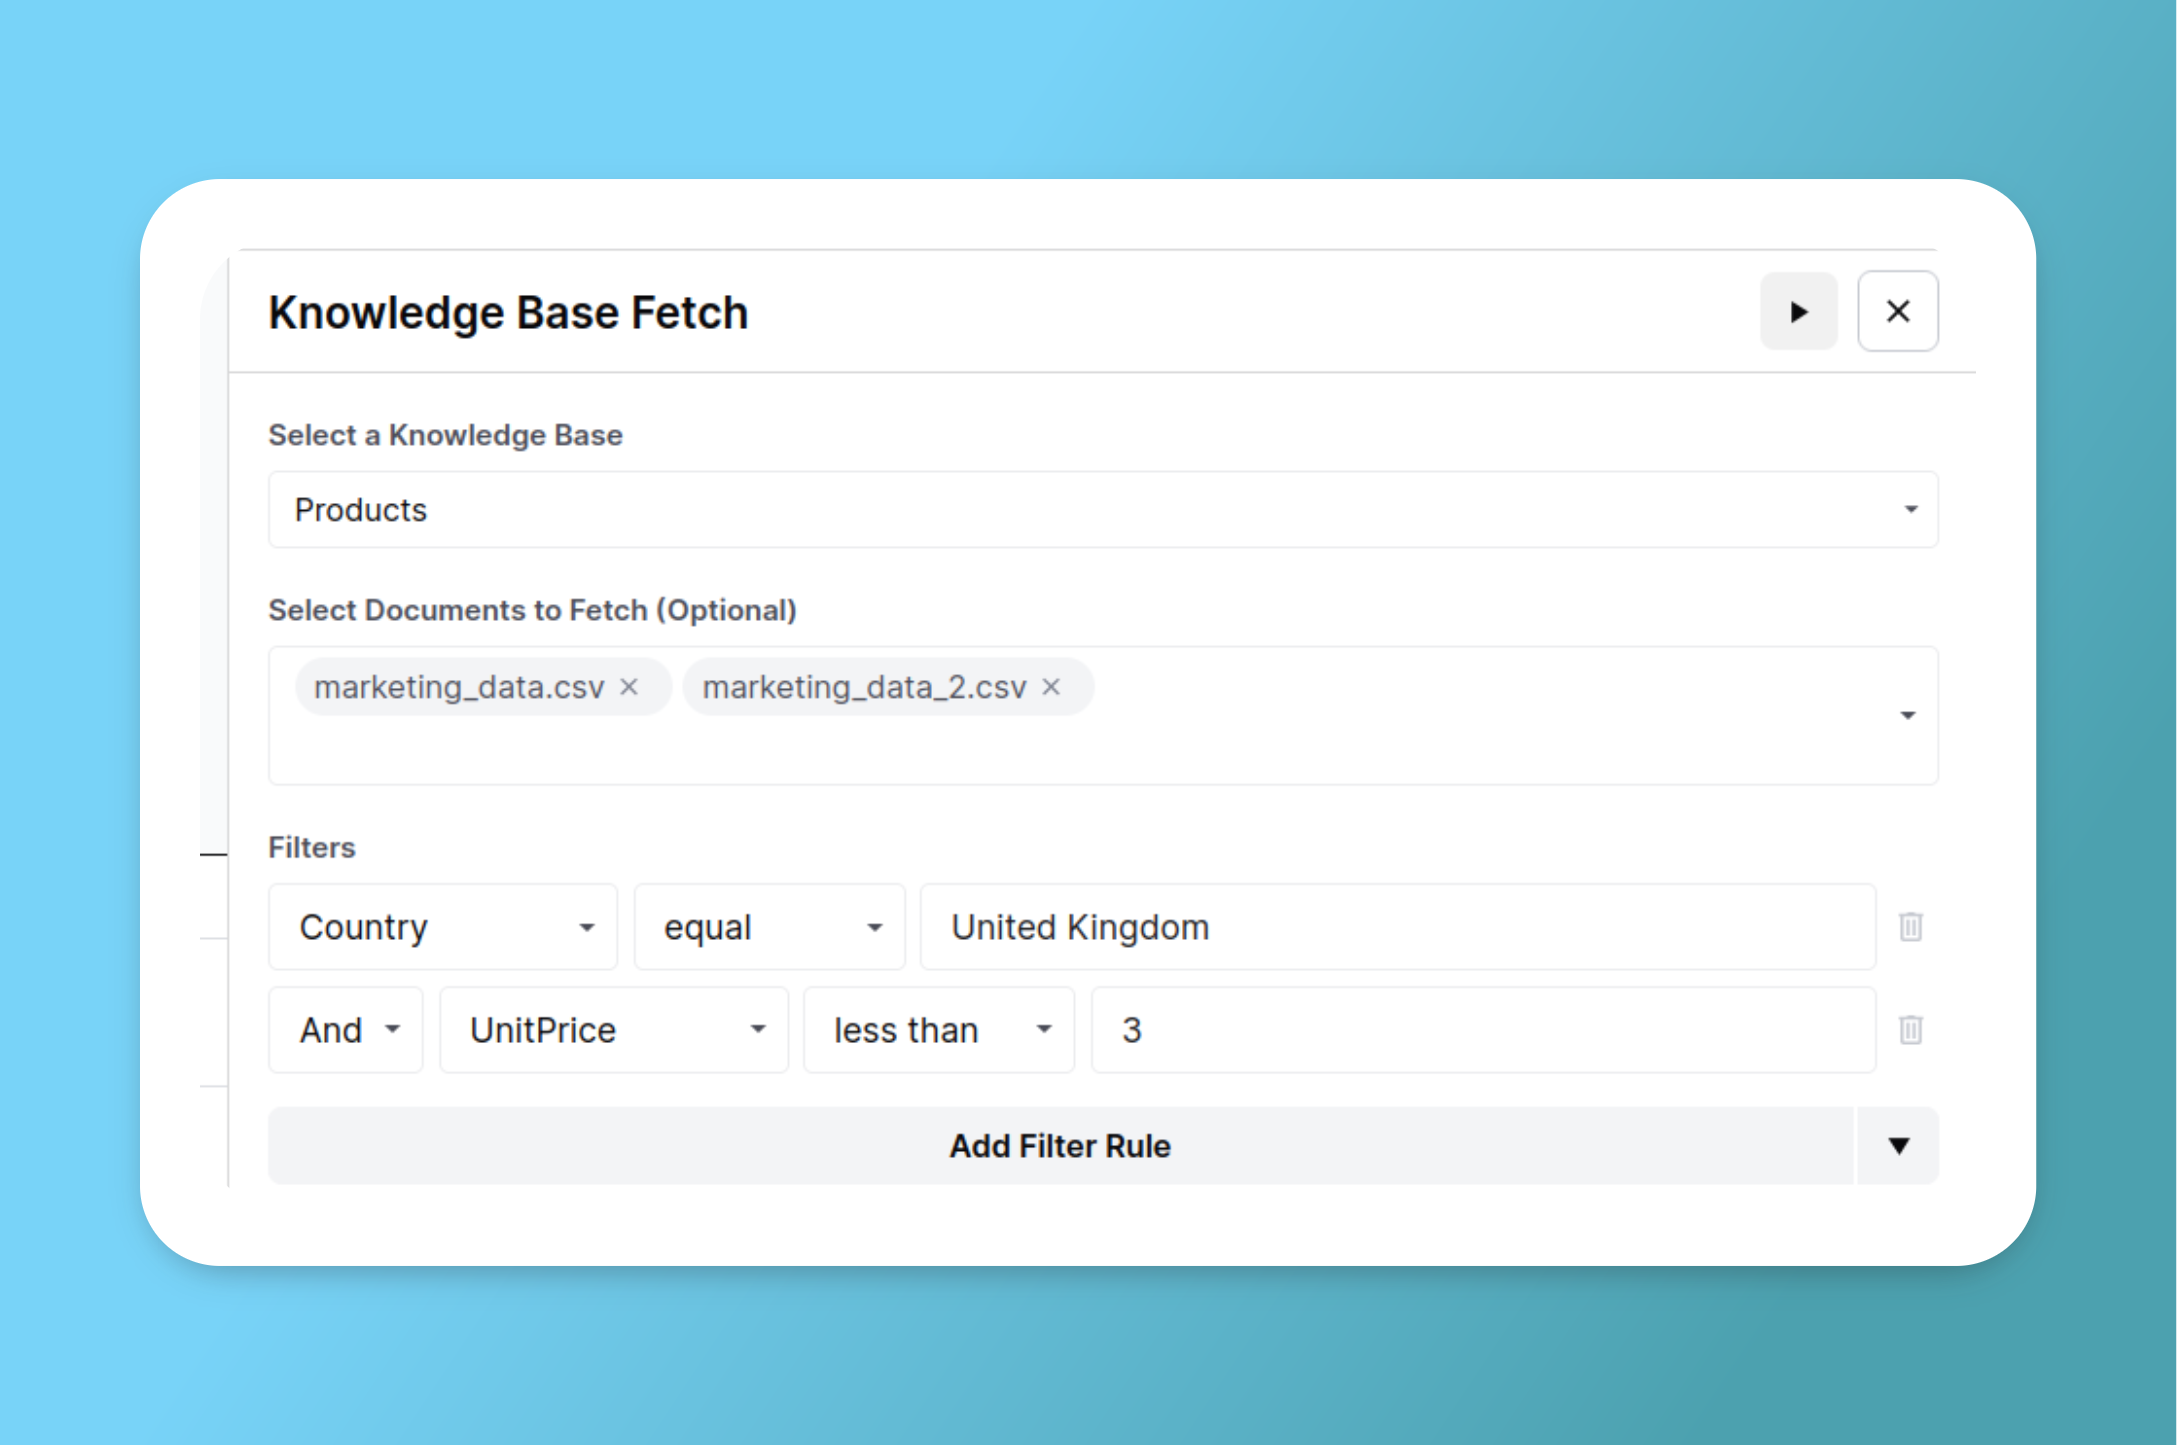
### Ajouter des filtres (facultatif)
Vous pouvez ajouter des filtres pour affiner les résultats en fonction des champs de métadonnées. Cela inclut :
* **Métadonnées standard** héritées de la source (par exemple, nom du fichier, URL source)
* **Métadonnées personnalisées** que vous avez ajoutées pour étiqueter les fichiers (par exemple, pays, produit, public)
* **Colonnes CSV/feuille** lorsque la base de connaissances contient des données structurées
**Exemple : filtrage par métadonnées personnalisées**
Si vous avez des études de cas clients étiquetées avec un `country` champ de métadonnées personnalisé, vous pouvez filtrer pour récupérer uniquement les études de cas d'une région spécifique :
{% hint style="success" %}
**Filtrage dynamique**
Utilisez les entrées du workflow pour rendre les filtres dynamiques. Par exemple, définissez le filtre sur `country` est égal à `{{input.region}}` et le workflow récupérera les fichiers correspondant à la région transmise à l'exécution.
{% endhint %}
Pour que le filtrage soit efficace, nous vous recommandons de consulter [Métadonnées des bases de connaissances](/docs/fr/contexte/memory-stores/memory-stores-metadata.md) pour apprendre à ajouter des balises de métadonnées personnalisées à vos fichiers de base de connaissances.
## Résultat de l'étape de lecture de la base de connaissances
L'étape de lecture de la base de connaissances renverra une liste de documents avec leurs enregistrements respectifs. Dans notre exemple précédent de produits filtrés, la sortie ressemblera à ceci :
```json
[
{
"document_name": "marketing_data.csv",
"records": [
{
"__text": "WHITE HANGING HEART T-LIGHT HOLDER\n\n-----\n\nRoyaume-Uni",
"InvoiceNo": 536365,
"StockCode": "85123A",
"Description": "WHITE HANGING HEART T-LIGHT HOLDER",
"Quantity": 6,
"InvoiceDate": "12/1/2010 8:26",
"UnitPrice": 2.55,
"CustomerID": 17850,
"Country": "Royaume-Uni"
},
...
]
},
{
"document_name": "marketing_data_2.csv",
"records": [
{
"__text": "CREAM CUPID HEARTS COAT HANGER\n\n-----\n\nRoyaume-Uni",
"InvoiceNo": 536365,
"StockCode": "84406B",
"Description": "CREAM CUPID HEARTS COAT HANGER",
"Quantity": 8,
"InvoiceDate": "12/1/2010 8:26",
"UnitPrice": 2.75,
"CustomerID": 17850,
"Country": "Royaume-Uni"
},
...
]
}
]
```
Vous pouvez remarquer que :
* Seuls les documents sélectionnés dans la liste déroulante sont renvoyés.
* Chaque document comporte une liste d'enregistrements qui lui est associée. Comme ces documents sont des CSV, chaque enregistrement représente une ligne différente.
* Seuls les enregistrements correspondant aux filtres sélectionnés sont renvoyés (Royaume-Uni et UnitPrice < 3).
* Il existe un champ spécial "\_\_text" qui montre quel texte interrogeable a été sélectionné lors du téléchargement du CSV. Comme dans ce cas, seules les colonnes "Description" et "Country" ont été sélectionnées comme interrogeables, ce sont celles qui sont intégrées dans le champ "\_\_text".
Voici un exemple de sortie pour la récupération d'un document PDF :
```json
[
{
"document_name": "US_Congress-2023-SB546-Enrolled.pdf",
"records": [
{
"__text": "S. 546 \n\nCent dix-huitième Congrès des États-Unis d'Amérique\n\nÀ LA DEUXIÈME SESSION\n\nCommencé et tenu dans la ville de Washington le mercredi, troisième jour de janvier deux mille vingt-quatre\n\nUne loi\n\nAfin de modifier la loi Omnibus de 1968 sur le contrôle de la criminalité et la sécurité des rues afin d'autoriser les organismes d'application de la loi à utiliser les subventions COPS pour des activités de recrutement, et à d'autres fins...",
"__languages": [
"eng"
],
}
]
}
]
```
## Utiliser la sortie de l'étape pour effectuer du RAG
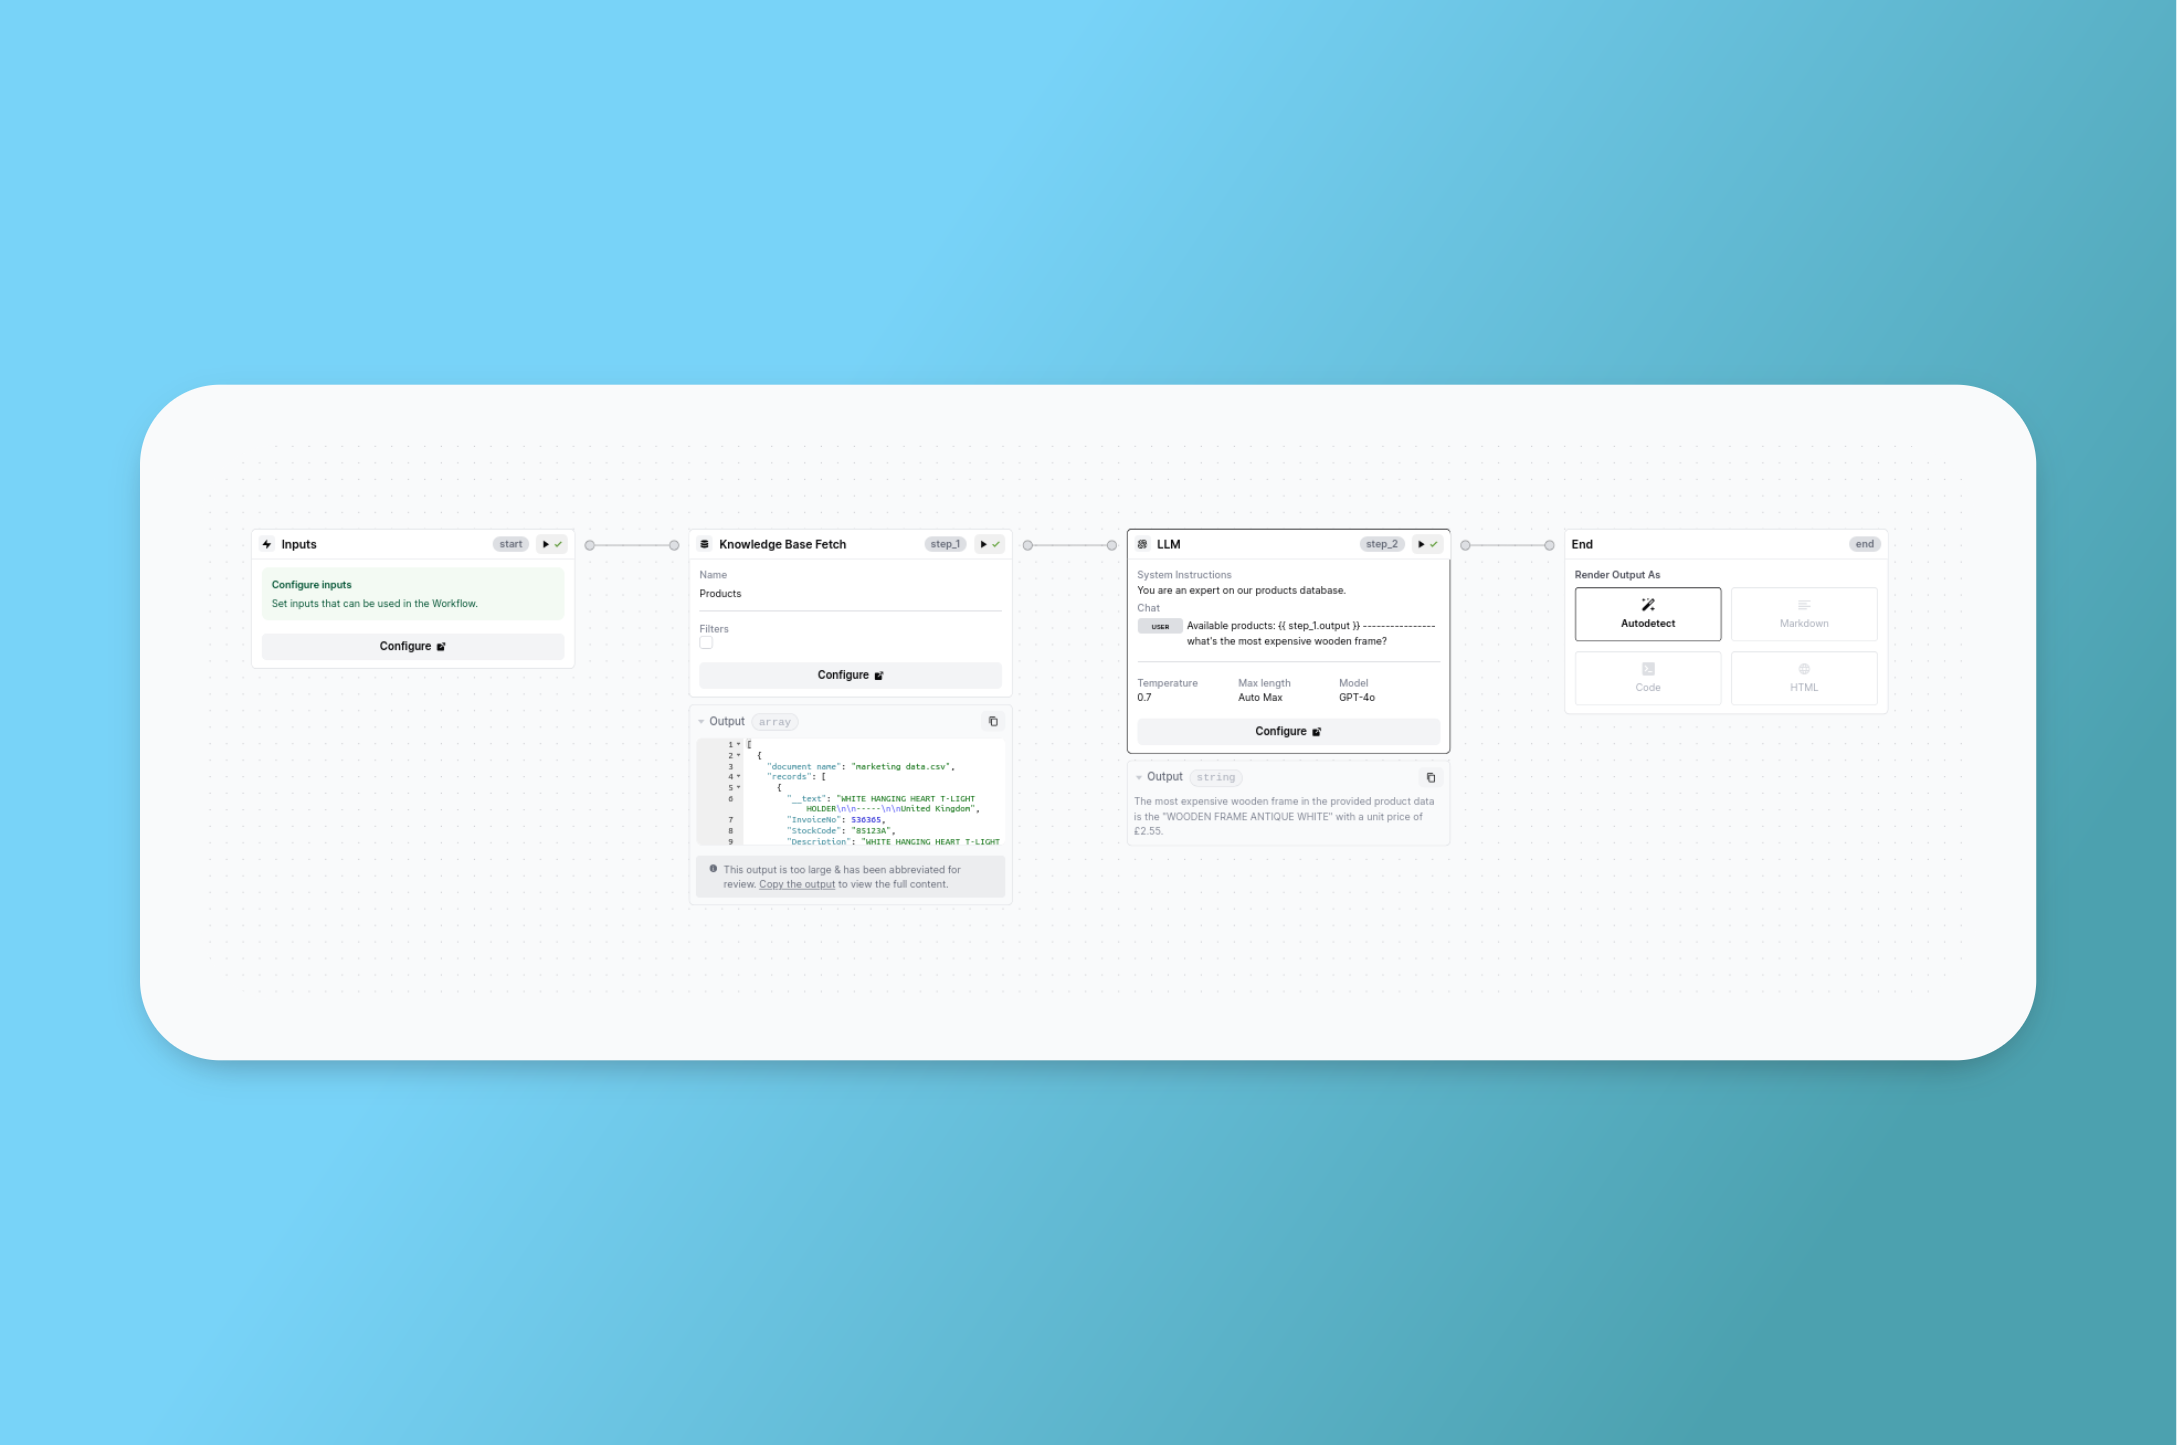
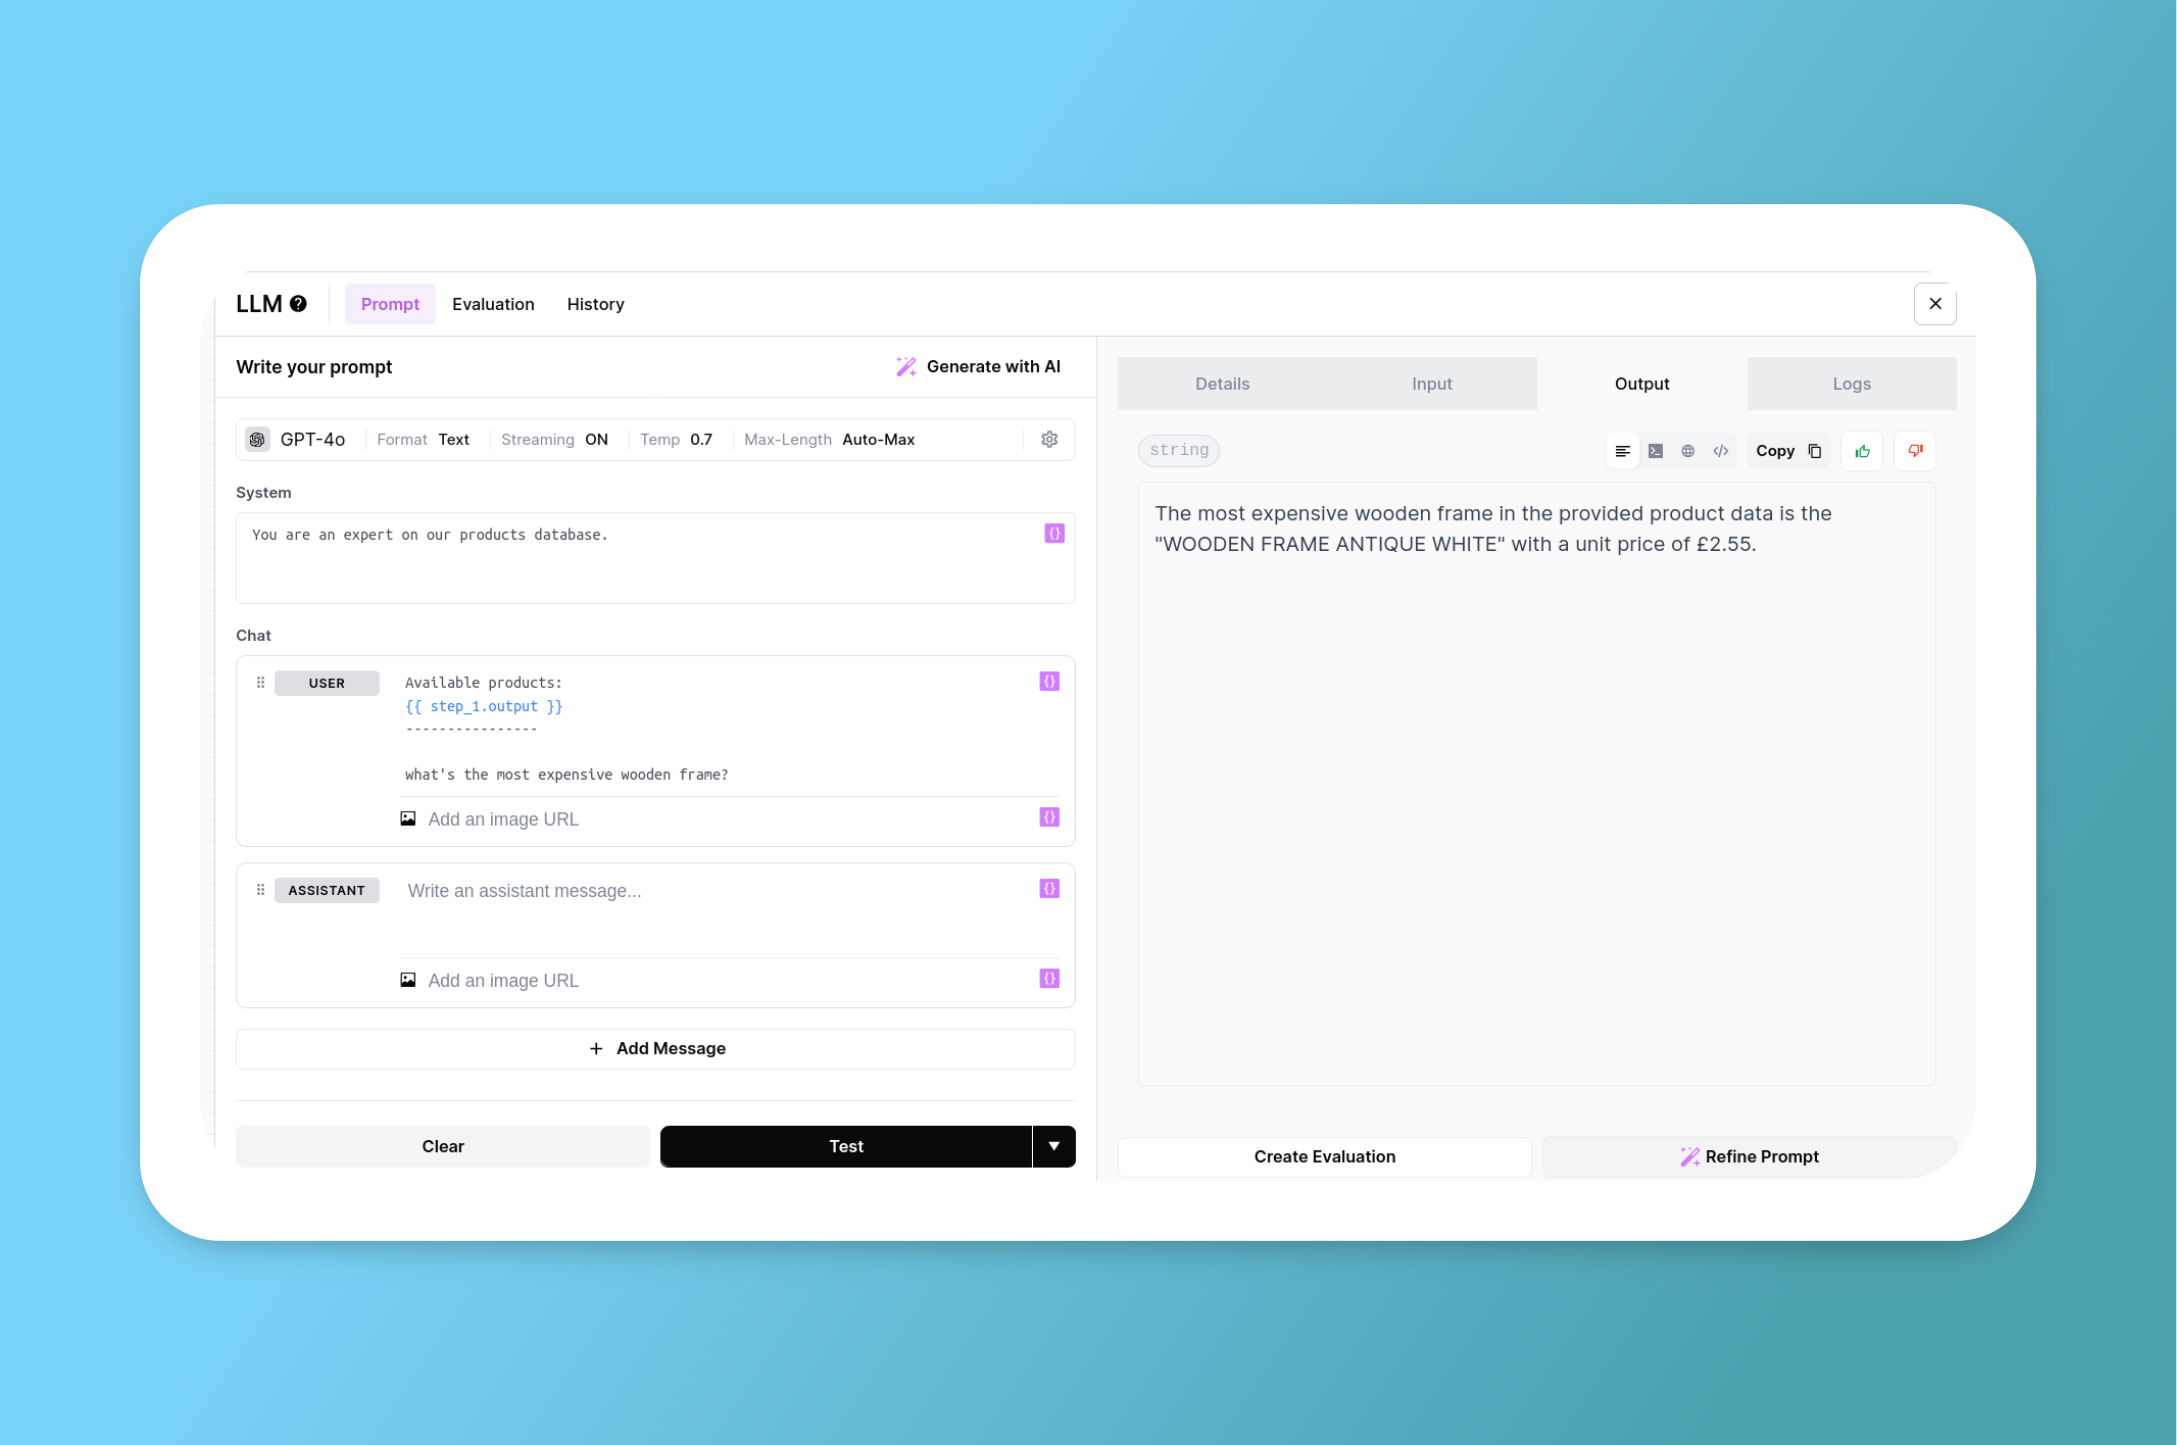
Nous pouvons transmettre la sortie de l'étape de récupération de la base de connaissances à une étape LLM pour effectuer une génération augmentée par récupération.
En reprenant notre exemple de produits, nous pouvons récupérer la liste complète des produits et la transmettre à une étape LLM comme ceci :
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.airops.com/docs/fr/actions/workflow-concepts/workflow-steps/memory-steps/knowledge-base-read.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.