> For the complete documentation index, see [llms.txt](https://docs.airops.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.airops.com/docs/fr/actions/workflow-concepts/workflow-steps/ai-steps/llm/choosing-a-model.md).
# Guide de sélection des modèles
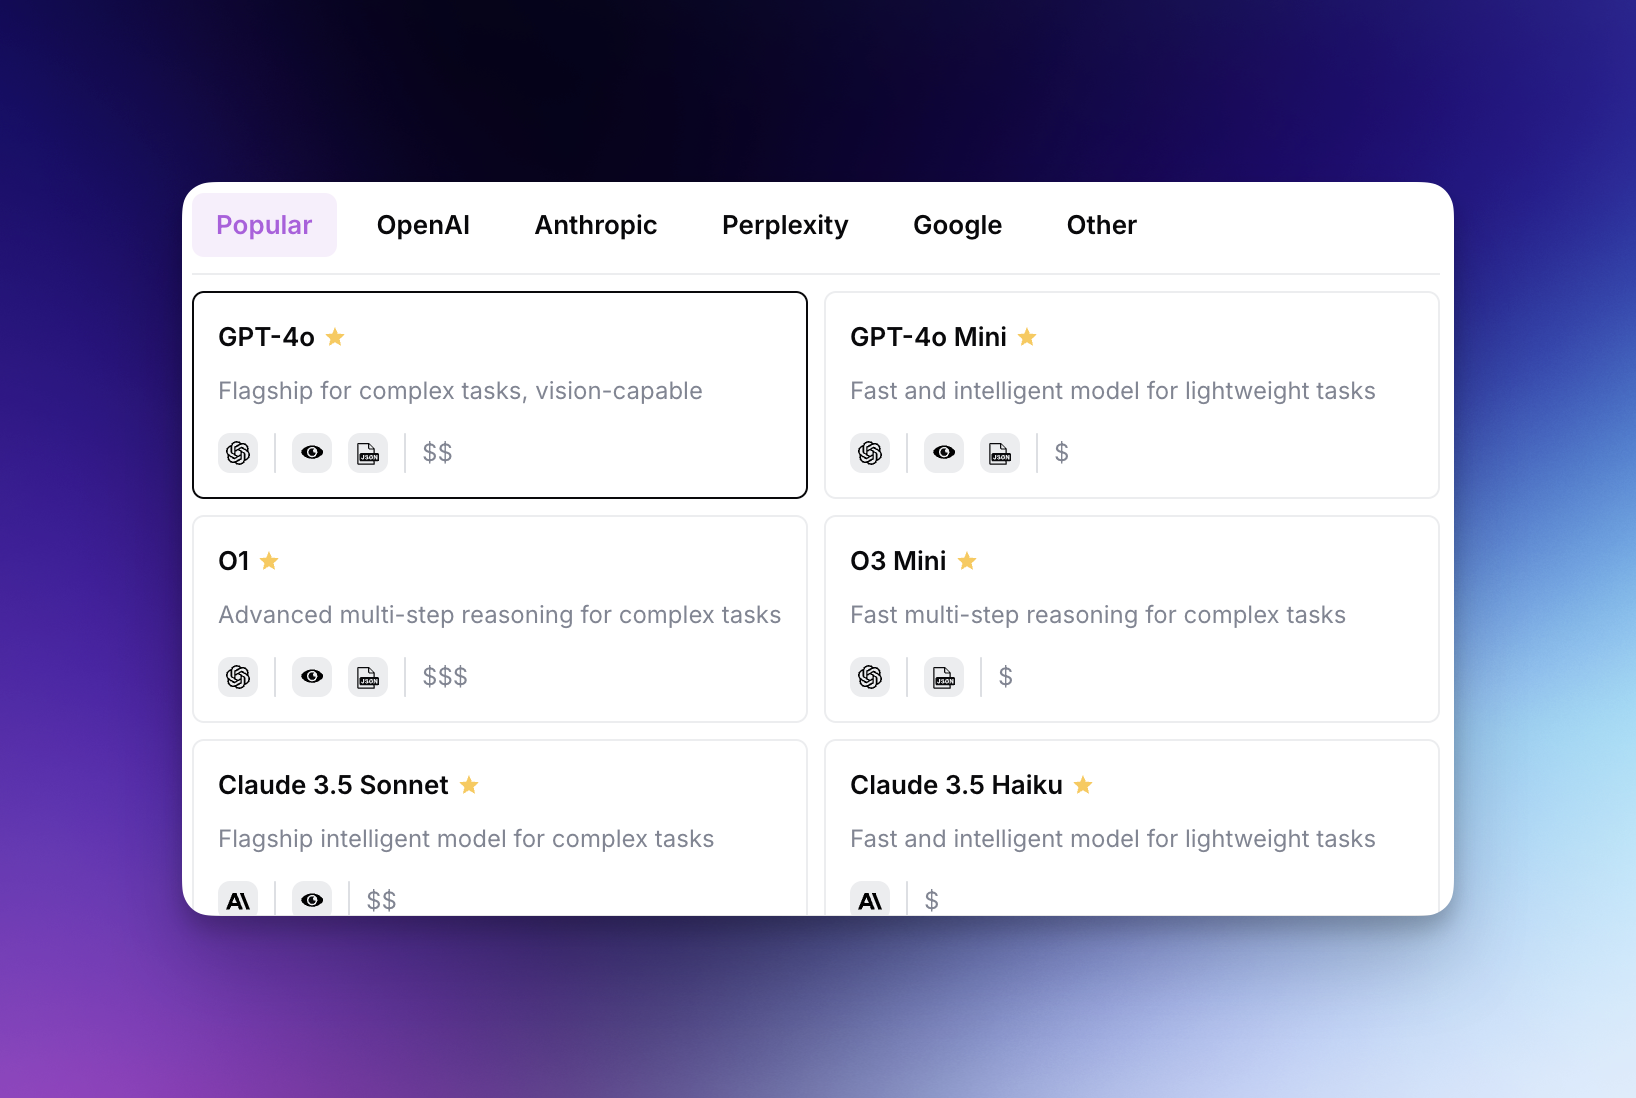
Comparez les modèles pris en charge et choisissez-en un pour une étape Prompt LLM
## Choisissez un modèle
Le modèle que vous sélectionnez influe sur la qualité des résultats, la vitesse, le coût et les fonctionnalités disponibles dans une [étape Prompt LLM](/docs/fr/actions/workflow-concepts/workflow-steps/ai-steps/llm.md). Utilisez le sélecteur de modèles comme source de vérité pour connaître la disponibilité dans votre espace de travail.
### Ce qu'il faut prendre en compte
Comparez ces facteurs avant de sélectionner un modèle :
1. **Fenêtre de contexte :** Vérifiez la quantité d'entrée que le modèle peut traiter. Un token correspond approximativement à quatre caractères en anglais.
2. **Complexité de la tâche :** Utilisez des modèles de raisonnement plus puissants pour la planification, l'analyse et la logique en plusieurs étapes.
3. **Accès au Web :** Vérifiez que le modèle prend en charge la recherche web lorsque la tâche nécessite des informations actuelles.
4. **Coût :** Comparez la catégorie de coût du modèle dans le sélecteur, en particulier pour les Workflows à fort volume.
5. **Vitesse :** Équilibrez le temps de réponse avec la profondeur de raisonnement requise par la tâche.
## Modèles AirOps courants
Les modèles suivants couvrent des cas d'utilisation courants dans les nouveaux Workflows. Une coche signifie que la fonctionnalité est disponible dans l'étape Prompt LLM d'AirOps.
| Modèle | Fournisseur | Description | Fenêtre de contexte | Vision | Mode JSON | Accès au Web |
| ------------------------ | ----------- | --------------------------------------------------------------------------- | ------------------- | ------ | --------- | ------------ |
| GPT-6 Astra | OpenAI | Raisonnement complexe et travail agentique | 1 M | ✓ | ✓ | ✓ |
| GPT-6.1 Sol | OpenAI | Par défaut pour les nouvelles étapes Prompt LLM | 1 M | ✓ | ✓ | ✓ |
| GPT-6 Sol | OpenAI | Raisonnement puissant pour le codage et le travail agentique | 1 M | ✓ | ✓ | ✓ |
| GPT-6 Luna | OpenAI | Modèle efficace pour un travail ciblé à fort volume | 1 M | ✓ | ✓ | ✓ |
| GPT-5.6 Sol | OpenAI | Modèle phare GPT-5.6 pour le raisonnement complexe et le codage | 1 M | ✓ | ✓ | ✓ |
| GPT-5.6 Terra | OpenAI | Modèle GPT-5.6 équilibré offrant de bonnes performances à moindre coût | 1 M | ✓ | ✓ | ✓ |
| GPT-5.6 Luna | OpenAI | Modèle GPT-5.6 économique pour les charges de travail à fort volume | 1 M | ✓ | ✓ | ✓ |
| GPT-5.5 | OpenAI | Ancien modèle phare pour les tâches de raisonnement complexes | 1 M | ✓ | ✓ | ✓ |
| GPT-5.4 | OpenAI | Modèle avancé pour un usage professionnel | 1 M | ✓ | ✓ | ✓ |
| GPT-5.4 Mini | OpenAI | Modèle GPT-5.4 plus rapide pour des tâches bien définies | 400 K | ✓ | ✓ | ✓ |
| GPT-5.2 | OpenAI | Modèle phare avec un raisonnement amélioré sur long contexte | 400 K | ✓ | ✓ | ✓ |
| GPT-5 | OpenAI | Modèle pour les tâches complexes | 200 K | ✓ | ✓ | ✓ |
| O3 Pro | OpenAI | Modèle avancé pour le raisonnement complexe | 200 K | ✓ | ✓ | - |
| O3 | OpenAI | Modèle de raisonnement avec recherche web | 200 K | ✓ | ✓ | ✓ |
| Claude Opus 5.5 | Anthropic | Raisonnement complexe et travail agentique | 1 M | ✓ | - | ✓ |
| Claude Opus 5 | Anthropic | Pour le codage agentique complexe et le travail en entreprise | 1 M | ✓ | - | ✓ |
| Claude Fable 5.1 | Anthropic | Raisonnement exigeant et travail agentique à long horizon | 1 M | ✓ | - | ✓ |
| Claude Fable 5 | Anthropic | Raisonnement exigeant et travail agentique à long horizon | 1 M | ✓ | - | ✓ |
| Claude Sonnet 5.5 | Anthropic | Modèle rapide pour le codage et les tâches quotidiennes | 1 M | ✓ | - | ✓ |
| Claude Sonnet 5 | Anthropic | Raisonnement hybride pour des réponses rapides ou une réflexion approfondie | 1 M | ✓ | - | ✓ |
| Claude Opus 4.8 | Anthropic | Ancien modèle phare pour les tâches complexes en plusieurs étapes | 1 M | ✓ | - | ✓ |
| Claude Opus 4.7 | Anthropic | Raisonnement complexe, codage et travail sur long contexte | 1 M | ✓ | - | ✓ |
| Claude Opus 4.6 | Anthropic | Raisonnement complexe et codage | 200 K | ✓ | - | ✓ |
| Claude Sonnet 4.6 | Anthropic | Option Sonnet actuelle pour les tâches complexes | 200 K | ✓ | - | ✓ |
| Claude Haiku 5.5 | Anthropic | Classification rapide, extraction et tâches légères | 1 M | ✓ | - | ✓ |
| Claude Haiku 4.5 | Anthropic | Modèle rapide pour les tâches légères | 200 K | ✓ | - | ✓ |
| Gemini 3.8 Flash | Google | Raisonnement et génération avec ancrage Google Search | 1 M | - | ✓ | ✓ |
| Gemini 3.5 Flash | Google | Modèle rapide avec ancrage Google Search | 1 M | - | ✓ | ✓ |
| Gemini 3.1 Pro Preview | Google | Raisonnement avancé avec ancrage Google Search | 1 M | - | ✓ | ✓ |
| Aperçu de Gemini 3 Flash | Google | Modèle rapide pour les tâches légères | 1 M | - | ✓ | ✓ |
| Gemini 3.1 Flash Lite | Google | Modèle économique pour les tâches légères | 1 M | - | ✓ | ✓ |
| Perplexity Sonar | Perplexity | Modèle équilibré pour la recherche web en ligne | 128 K | - | - | ✓ |
## Modèles OpenAI
### GPT-6 Astra
Sélectionnez **GPT-6 Astra** pour le raisonnement complexe et les tâches agentiques. Il prend en charge l'effort de raisonnement, la verbosité, la vision, la sortie JSON et la recherche web dans l'étape Prompt LLM. Les contrôles de température ne sont pas disponibles.
### GPT-6.1 Sol
Les nouvelles étapes Prompt LLM utilisent par défaut **GPT-6.1 Sol** avec **Moyenne** l'effort de raisonnement. Vous pouvez choisir **Faible**, **Moyenne**, ou **Élevée**. L'étape prend en charge la vision, la sortie JSON, la recherche web et les contrôles de verbosité, avec une fenêtre de contexte d'un million de tokens et jusqu'à 128 000 tokens de sortie. Les contrôles de température ne sont pas disponibles. Les sélections de modèles prises en charge existantes restent inchangées.
### GPT-6 Sol et Luna
Utiliser **GPT-6 Sol** pour le codage exigeant, le raisonnement et le travail agentique. **GPT-6 Luna** est une option à moindre coût pour les tâches ciblées à fort volume.
Les deux prennent en charge la vision, la sortie JSON, la recherche web, l'effort de raisonnement et les contrôles de verbosité. Les contrôles de température ne sont pas disponibles. Les étapes existantes conservent leur modèle sélectionné.
### Série GPT-5
Les modèles GPT-5 combinent le raisonnement et la génération à usage général. GPT-5.6 apparaît dans le sélecteur de modèles sous les noms Sol, Terra et Luna. Ces modèles restent disponibles pour les étapes existantes et nouvelles.
Les contrôles de raisonnement varient selon le modèle :
* GPT-5 prend en charge `minimal`, `faible`, `moyen`, et `élevé`.
* GPT-5.1, GPT-5.2, GPT-5.4, GPT-5.5 et GPT-5.6 prennent en charge `aucun`, `faible`, `moyen`, et `élevé`.
### Modèles O3
Utilisez O3 pour un raisonnement complexe en plusieurs étapes. O3 prend en charge `faible`, `moyen`, et `élevé` niveaux de raisonnement. O3 Pro augmente les capacités de raisonnement mais ne prend pas en charge la recherche web dans l'étape Prompt LLM.
## Différences entre les modèles Claude
### Claude Opus 5.5
Sélectionnez **Claude Opus 5.5** pour le raisonnement complexe et le travail agentique. Il prend en charge une fenêtre de contexte d'un million de tokens, la vision et la recherche web. Activez **Activer la réflexion** pour utiliser la réflexion adaptative. Les contrôles de température et Web Fetch ne sont pas disponibles pour ce modèle dans l'étape Prompt LLM.
### Claude Opus 5
Claude Opus 5 gère le codage agentique complexe et le travail en entreprise. Activez **Activer la réflexion** dans l'étape Prompt LLM lorsque la tâche bénéficie d'un raisonnement supplémentaire. Claude Opus 5 prend en charge **Recherche Web**, mais il ne prend pas en charge **Web Fetch**.
### Claude Fable 5.1 et Fable 5
Claude Fable 5.1 prend en charge un raisonnement exigeant et le travail agentique à long horizon, avec une fenêtre de contexte d'un million de tokens, la vision, la réflexion adaptative, la recherche web et Web Fetch. Fable 5 reste disponible pour les Workflows existants.
### Claude Sonnet 5.5
Sélectionnez **Claude Sonnet 5.5** pour le codage et les tâches quotidiennes. Il prend en charge une fenêtre de contexte d'un million de tokens, la vision, la recherche web et Web Fetch. Activez **Activer la réflexion** pour utiliser la réflexion adaptative avec un effort faible, moyen ou élevé. Les contrôles de température ne sont pas disponibles.
### Claude Sonnet 5
Claude Sonnet 5 équilibre des réponses rapides avec un raisonnement plus approfondi et est marqué d'une étoile dans le sélecteur de modèles LLM.
### Claude Opus 4.8 et 4.7
Claude Opus 4.8 et 4.7 prennent en charge les Workflows complexes en plusieurs étapes, le contenu long et les tâches de recherche. Les deux modèles prennent en charge des fenêtres de contexte d'un million de tokens.
### Claude Haiku 5.5
Sélectionnez **Claude Haiku 5.5** dans une étape Prompt LLM pour la classification, l'extraction et les tâches légères. Il prend en charge la vision, la recherche web, une fenêtre de contexte d'un million de tokens et jusqu'à 128 000 tokens de sortie.
Activez **Activer la réflexion** pour la réflexion adaptative avec **Faible**, **Moyenne**, ou **Élevée** effort. Les contrôles de température, Top P, Top K et de niveau de priorité ne sont pas disponibles pour ce modèle.
### Claude Sonnet 4.6 et Haiku 4.5
Utilisez Claude Sonnet 4.6 pour les tâches complexes qui nécessitent un équilibre entre raisonnement et rapidité. Utilisez Claude Haiku 4.5 pour des charges de travail plus légères.
## Modèles Gemini Flash
Gemini 3.8 Flash prend en charge une fenêtre de contexte d'un million de tokens, la sortie JSON et l'ancrage Google Search. La vision et les outils MCP ne sont pas disponibles pour ce modèle dans l'étape Prompt LLM. Gemini 3.8 Flash n'expose pas de contrôles de température.
## Modèles Groq
Sélectionnez **GPT OSS 120B** ou **GPT OSS 20B** pour des modèles à poids ouverts hébergés par Groq. GPT OSS 20B est destiné aux tâches plus légères.
Groq a mis hors service Llama 3.1 8B Instant et Llama 3.3 70B Versatile le 16 août 2026. AirOps remplace les sélections concernées par GPT OSS 20B et GPT OSS 120B, respectivement. Examinez et testez le remplacement avant d'exécuter en masse un Workflow concerné.
## Disponibilité des modèles
AirOps masque les modèles obsolètes du sélecteur pour les nouveaux Workflows. Si un Workflow existant utilise un modèle obsolète, le modèle sélectionné reste visible afin que vous puissiez examiner la modification. AirOps peut mettre automatiquement à jour la sélection vers un modèle pris en charge lorsque le Workflow se charge. Si un remplacement a lui aussi été rendu obsolète, AirOps suit la chaîne de remplacement jusqu'à un modèle pris en charge.
Examinez le modèle sélectionné et testez le Workflow après une mise à jour automatique. Le comportement du modèle, le coût et les paramètres pris en charge peuvent changer d'une version à l'autre.
### Remplacements de modèles planifiés
Le calendrier de remplacement configuré par AirOps comprend :
| Modèle obsolète | Remplacement | Suppression planifiée |
| --------------------- | --------------------- | --------------------- |
| GPT-5.4 Nano | GPT-6 Luna | 1er avril 2027 |
| GPT-5.1 | GPT-6 Sol | 1er avril 2027 |
| Claude Sonnet 4.5 | Claude Sonnet 5.5 | 30 novembre 2026 |
| Gemini 3.7 Flash | Gemini 3.8 Flash | 28 janvier 2027 |
| Gemini 2.5 Flash Lite | Gemini 3.1 Flash Lite | 20 octobre 2026 |
| Gemini 2.5 Flash | Gemini 3.8 Flash | 20 octobre 2026 |
| Gemini 2.5 Pro | Gemini 3.1 Pro | 20 octobre 2026 |
La date de suppression configurée pour Claude Opus 4.1 était le 5 août 2026 ; son remplacement est Claude Opus 4.8. Testez les Workflows concernés avec le modèle de remplacement avant de les exécuter en masse.
## Capacités de recherche web
Plusieurs modèles prennent en charge la recherche web, ce qui leur permet d'accéder à des informations actuelles pendant la génération :
**OpenAI :** GPT-6 Astra, GPT-6.1 Sol, GPT-6 Sol, GPT-6 Luna, GPT-5, GPT-5.2, GPT-5.4, GPT-5.4 Mini, GPT-5.5, GPT-5.6 Sol, GPT-5.6 Terra, GPT-5.6 Luna et O3 prennent en charge la recherche web lorsqu'elle est activée dans l'étape Prompt LLM.
**Anthropic :** Les modèles Claude actuels prennent en charge la recherche web. La disponibilité de Web Fetch dépend du modèle sélectionné. Claude Opus 5.5 et Opus 5 prennent en charge **Recherche Web**, mais pas **Web Fetch**.
**Google :** Les modèles Gemini actuels prennent en charge la recherche web via l'ancrage Google Search.
**Perplexity :** Les modèles Sonar incluent un accès au Web pour la recherche en ligne.
## Combien cela coûtera-t-il à exécuter ?
Le coût d'exécution d'un modèle dépend du nombre de tokens d'entrée et de sortie.
### Approximation des tokens
**Tokens d'entrée :** pour approximer le nombre total de tokens d'entrée, copiez-collez vos prompts système, utilisateur et assistant dans [le tokenizer OpenAI](https://platform.openai.com/tokenizer)
**Tokens de sortie :** pour approximer le nombre total de tokens de sortie, copiez-collez votre sortie dans [le tokenizer OpenAI](https://platform.openai.com/tokenizer)
### Approximation du coût
**OpenAI :** divisez les tokens d'entrée et de sortie par 1000, puis multipliez par leurs coûts respectifs [selon la tarification OpenAI](https://openai.com/pricing)\*
**Anthropic :** divisez les tokens d'entrée et de sortie par 1 000 000, puis multipliez par leurs coûts respectifs [selon la tarification Anthropic](https://www-cdn.anthropic.com/files/4zrzovbb/website/31021aea87c30ccaecbd2e966e49a03834bfd1d2.pdf)\*
{% hint style="info" %}
\*Voici le coût si vous [apportez votre propre clé API](/docs/fr/votre-espace-de-travail/settings/byo-key.md). Si vous choisissez d'utiliser des modèles hébergés par AirOps, vous serez [facturé pour les tâches en fonction de votre utilisation](https://airopshq.notion.site/AirOps-Task-Pricing-by-Hosted-Service-fd825db1300545cb8c3b5de8bc16529e).
{% endhint %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.airops.com/docs/fr/actions/workflow-concepts/workflow-steps/ai-steps/llm/choosing-a-model.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.