> For the complete documentation index, see [llms.txt](https://docs.airops.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.airops.com/docs/es/acciones/workflow-concepts/workflow-steps/web-research/web-page-scrape.md).
# Extracción de páginas web
Extrae texto, markdown o HTML de un sitio web
El paso "Web Page Scrape" te permite automatizar una extracción de texto/markdown/HTML desde una URL específica. Puedes combinar esto con un paso de iteración para extraer datos de varios sitios web y analizar la salida por separado.
## Configuración del paso "Web Page Scrape"
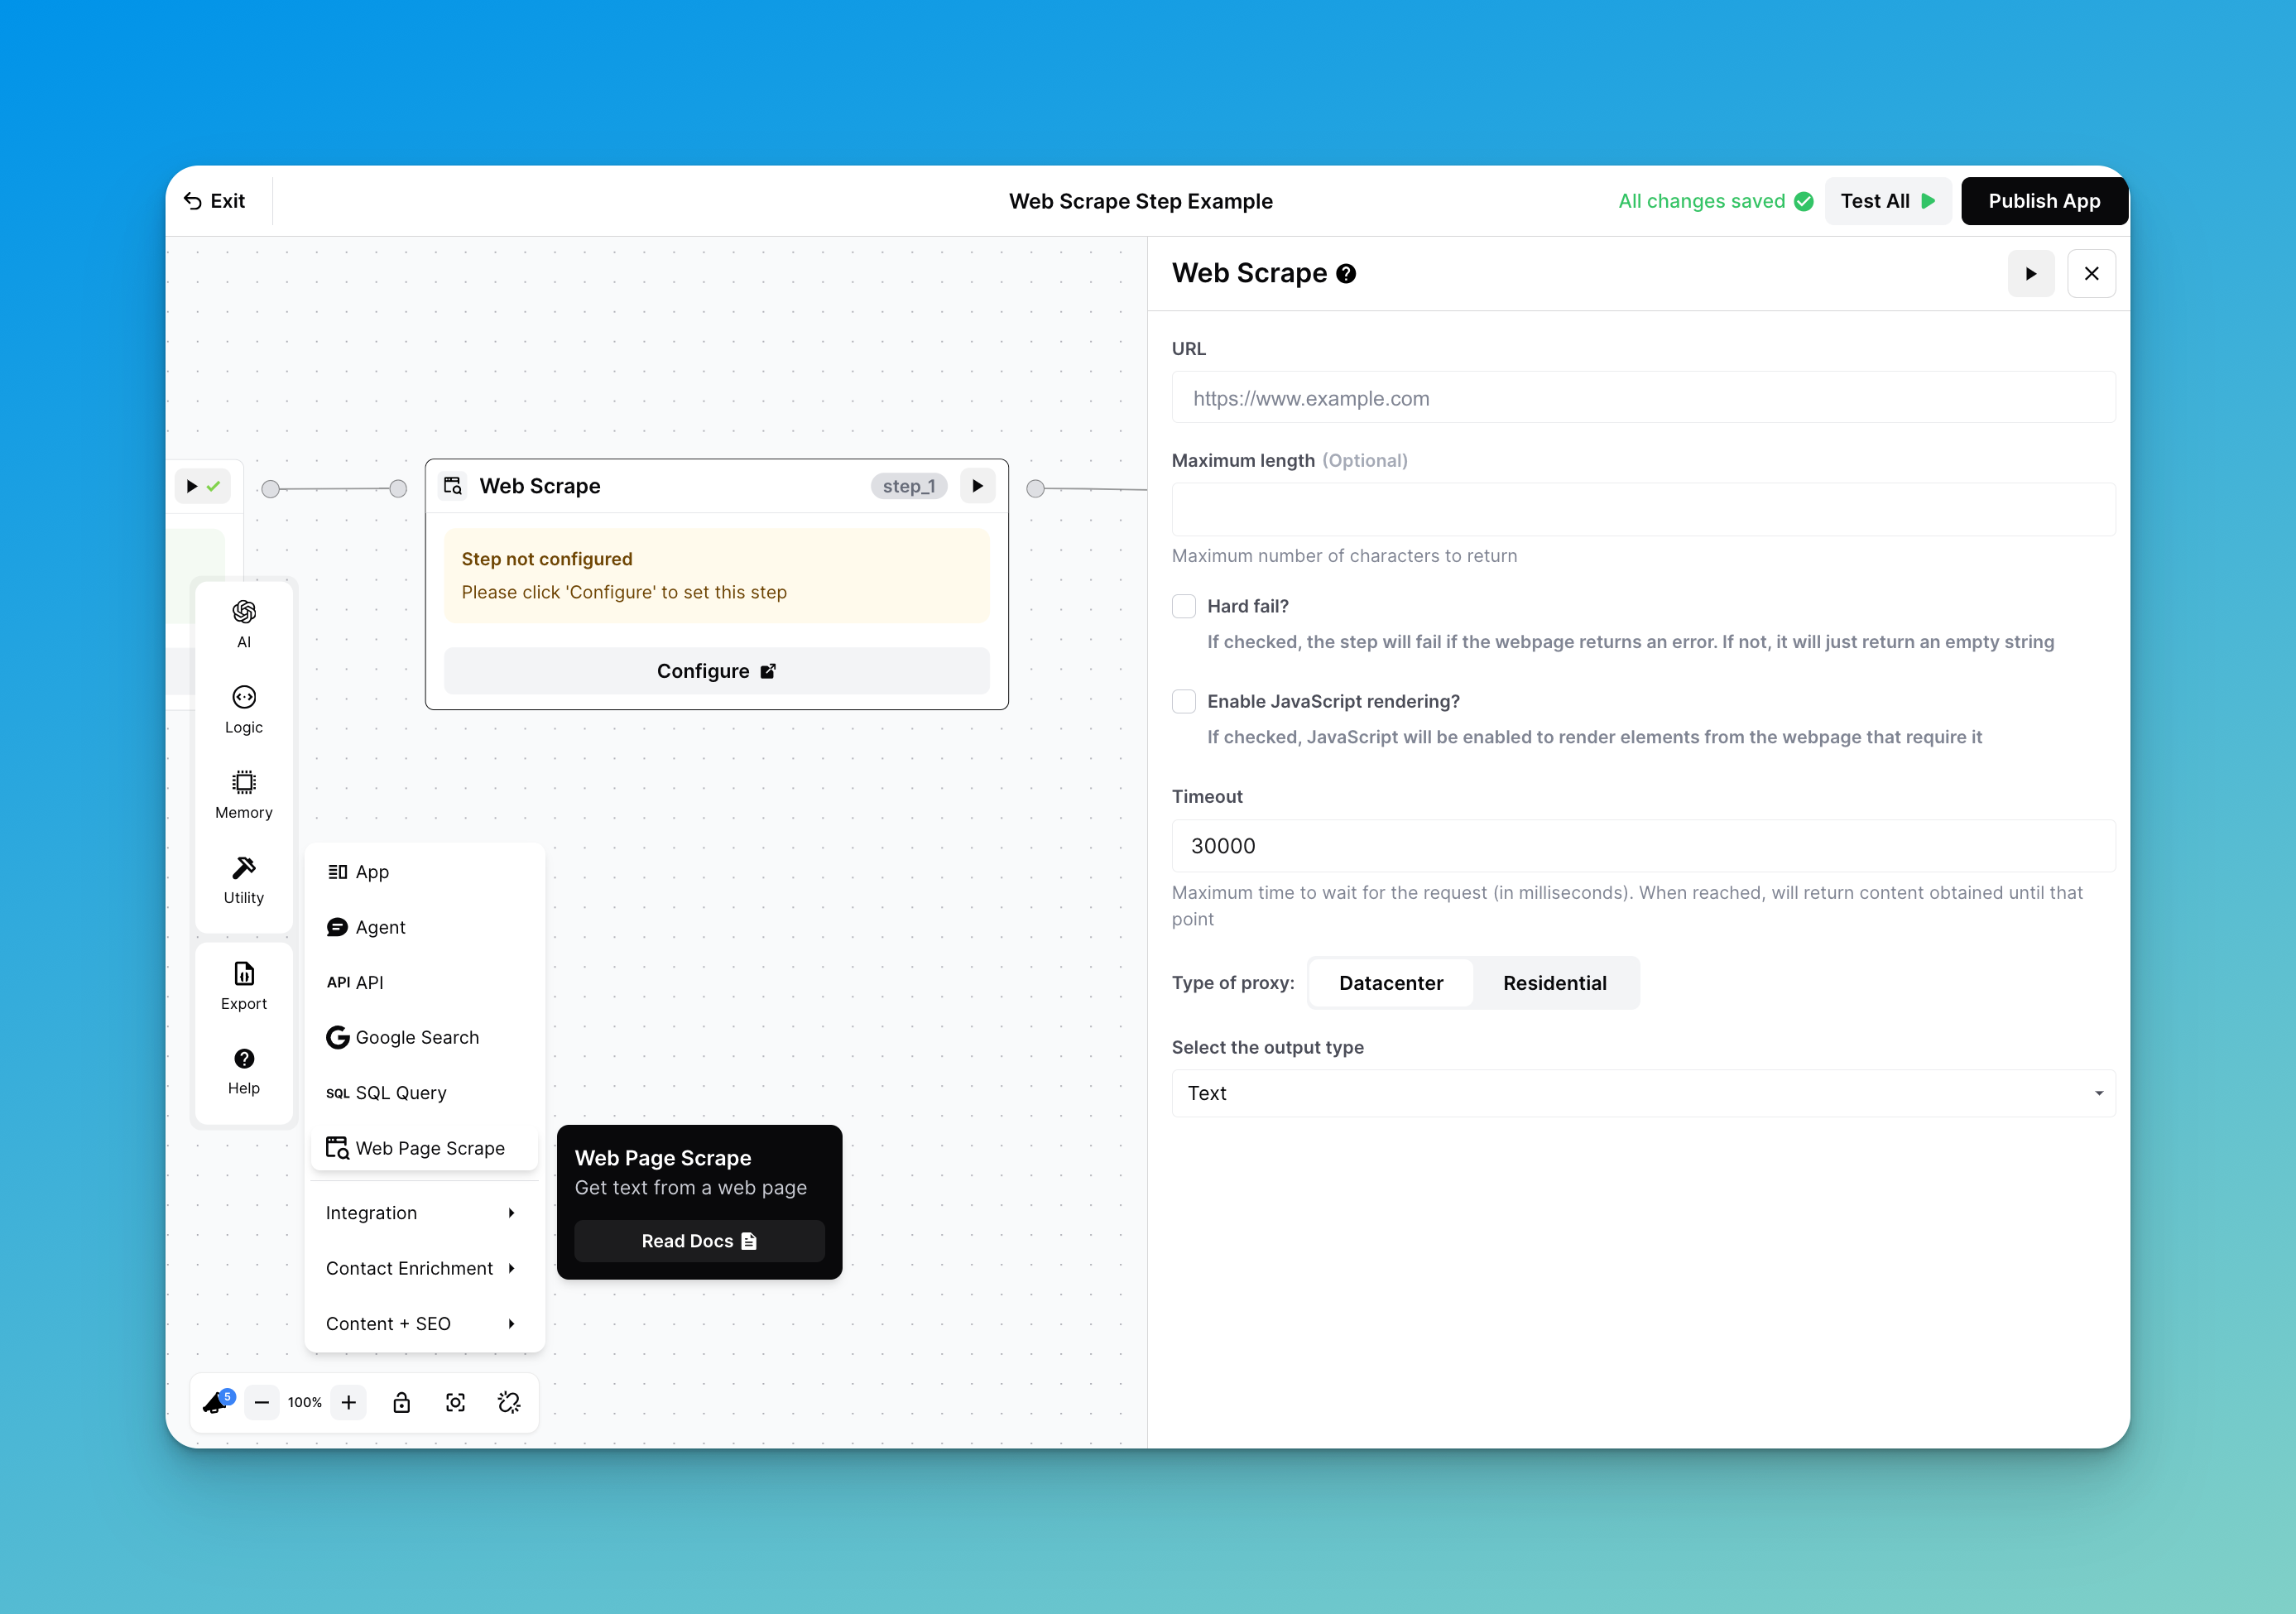
Configurar el paso requiere establecer los parámetros mostrados a continuación:
Configura tus parámetros de Web Page Scrape
### URL
Añade la URL específica de la que quieres que el paso extraiga datos.
### Longitud máxima
Opcionalmente, puedes limitar el número de caracteres devueltos por el paso.
Este parámetro puede ser útil para limitar la cantidad de texto que se envía a un paso LLM posterior, que tiene una ventana de contexto limitada.
{% hint style="warning" %}
**1 token equivale aproximadamente a 4 caracteres en inglés.** Para estimar el número de caracteres que debes enviar a un paso LLM, multiplica por 4 el número de tokens que quieres enviar.
{% endhint %}
### Cómo continuar si el paso Web Scrape falla
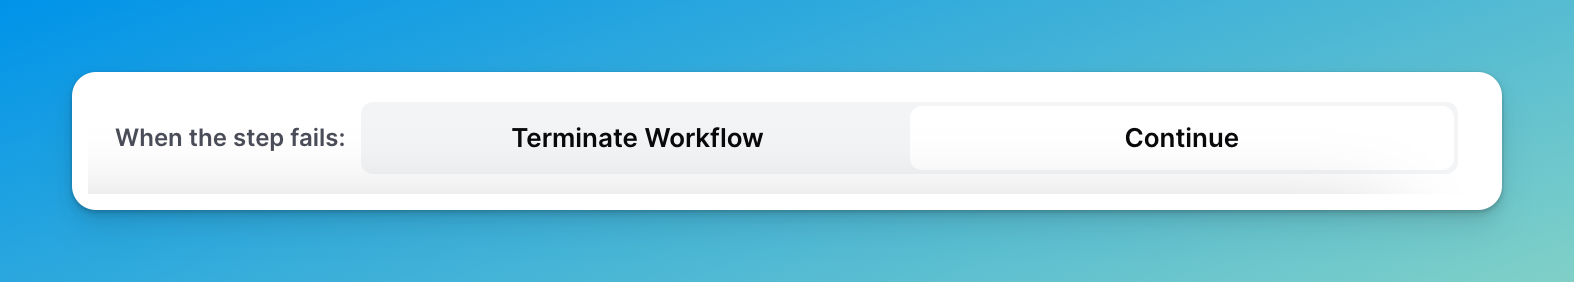
De forma predeterminada, el paso de código terminará el flujo de trabajo si falla. Sin embargo, para continuar el flujo de trabajo si el paso falla, simplemente haz clic en `Continuar` en la parte inferior del paso.
Haz clic en continuar para continuar el flujo de trabajo
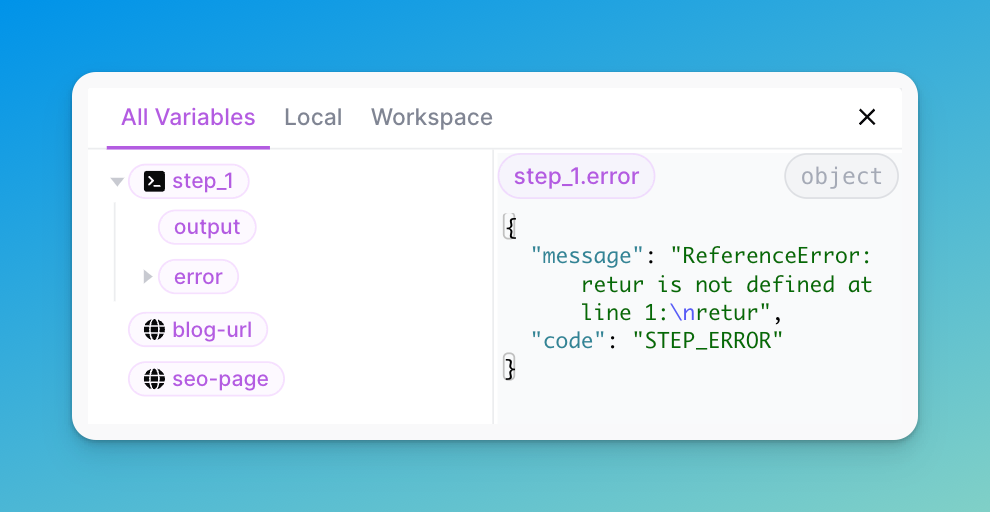
El paso devolverá las siguientes claves:
* `output` : esto será `null`
* `error` :
* `message`: el mensaje devuelto por el paso
* `code` : el código de error que representa el error
### ¿Habilitar renderizado de JavaScript?
De forma predeterminada, el paso Web Page Scrape no renderizará sitios web que usen JavaScript.
Marca esta casilla para habilitar la extracción de sitios web que usan JavaScript y ayudar a renderizar contenido dinámico (ejemplos incluyen Facebook, Airbnb y más).
### Tiempo de espera
El tiempo máximo de espera, en milisegundos, para que regresen los resultados de tu extracción web.
### Tipo de proxy:
Usa la **proxy residencial** para sitios que requieren más fiabilidad y mayores tasas de éxito. Por otro lado, usa el **proxy de centro de datos** cuando la fiabilidad y las tasas de éxito no sean una preocupación.
**Centro de datos:**
* Direcciones IP privadas alojadas en centros de datos
* Ofrecen mayor velocidad, pero son menos fiables en términos de anonimato
* Es más probable que los sitios web y los servicios de Internet las detecten y bloqueen.
#### Residencial
* Una dirección IP real vinculada a una ubicación física
* La extracción web parecerá provenir de una vivienda residencial en una ubicación determinada
* Se considera más legítima y es menos probable que los sitios web la bloqueen
{% hint style="info" %}
Nota: usar un proxy residencial es más caro que usar el de centro de datos, así que conviene valorar esto en relación con tu caso de uso al decidir qué proxy utilizar.
{% endhint %}
#### Encabezados
Usa este campo para pasar encabezados personalizados para la solicitud de extracción web. Asegúrate de que los encabezados estén formateados como JSON válido. Por ejemplo:
```javascript
{
"authorization": "Bearer YOUR_API_KEY",
"Content-Type": "{{ a_variable }}"
}
```
### Tipo de salida
* **Texto:** Sin formato incluido
* **HTML:** Extrae encabezados y formato de un sitio web en HTML
* **Markdown:** Extrae los encabezados de un sitio web en markdown
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.airops.com/docs/es/acciones/workflow-concepts/workflow-steps/web-research/web-page-scrape.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.