> For the complete documentation index, see [llms.txt](https://docs.airops.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.airops.com/docs/es/acciones/workflow-concepts/workflow-steps/memory-steps/knowledge-base-read.md).
# Obtener archivo de la base de conocimientos
Lee datos de tus bases de conocimiento usando filtros.
## ¿Qué es un paso de lectura de Base de Conocimiento?
El paso de lectura de Base de Conocimiento te permite consultar tus Bases de Conocimiento usando filtros para obtener cualquier dato relevante que puedas usar en tus flujos de trabajo. Esto es especialmente útil cuando haces [Generación aumentada por recuperación](https://en.wikipedia.org/wiki/Retrieval-augmented_generation) (RAG).
La principal diferencia entre este paso y el [Búsqueda de la Base de Conocimientos](/docs/es/acciones/workflow-concepts/workflow-steps/memory-steps/memory-search.md) paso es que, mientras en el paso de búsqueda puedes hacer consultas y obtener fragmentos de texto, el paso de lectura te permite aplicar filtros y obtener documentos completos.
Para obtener más información sobre cómo configurar una Base de Conocimiento, consulta nuestra página de documentación [aquí](/docs/es/contexto/memory-stores.md).
## Cómo configurar un paso de lectura de Base de Conocimiento
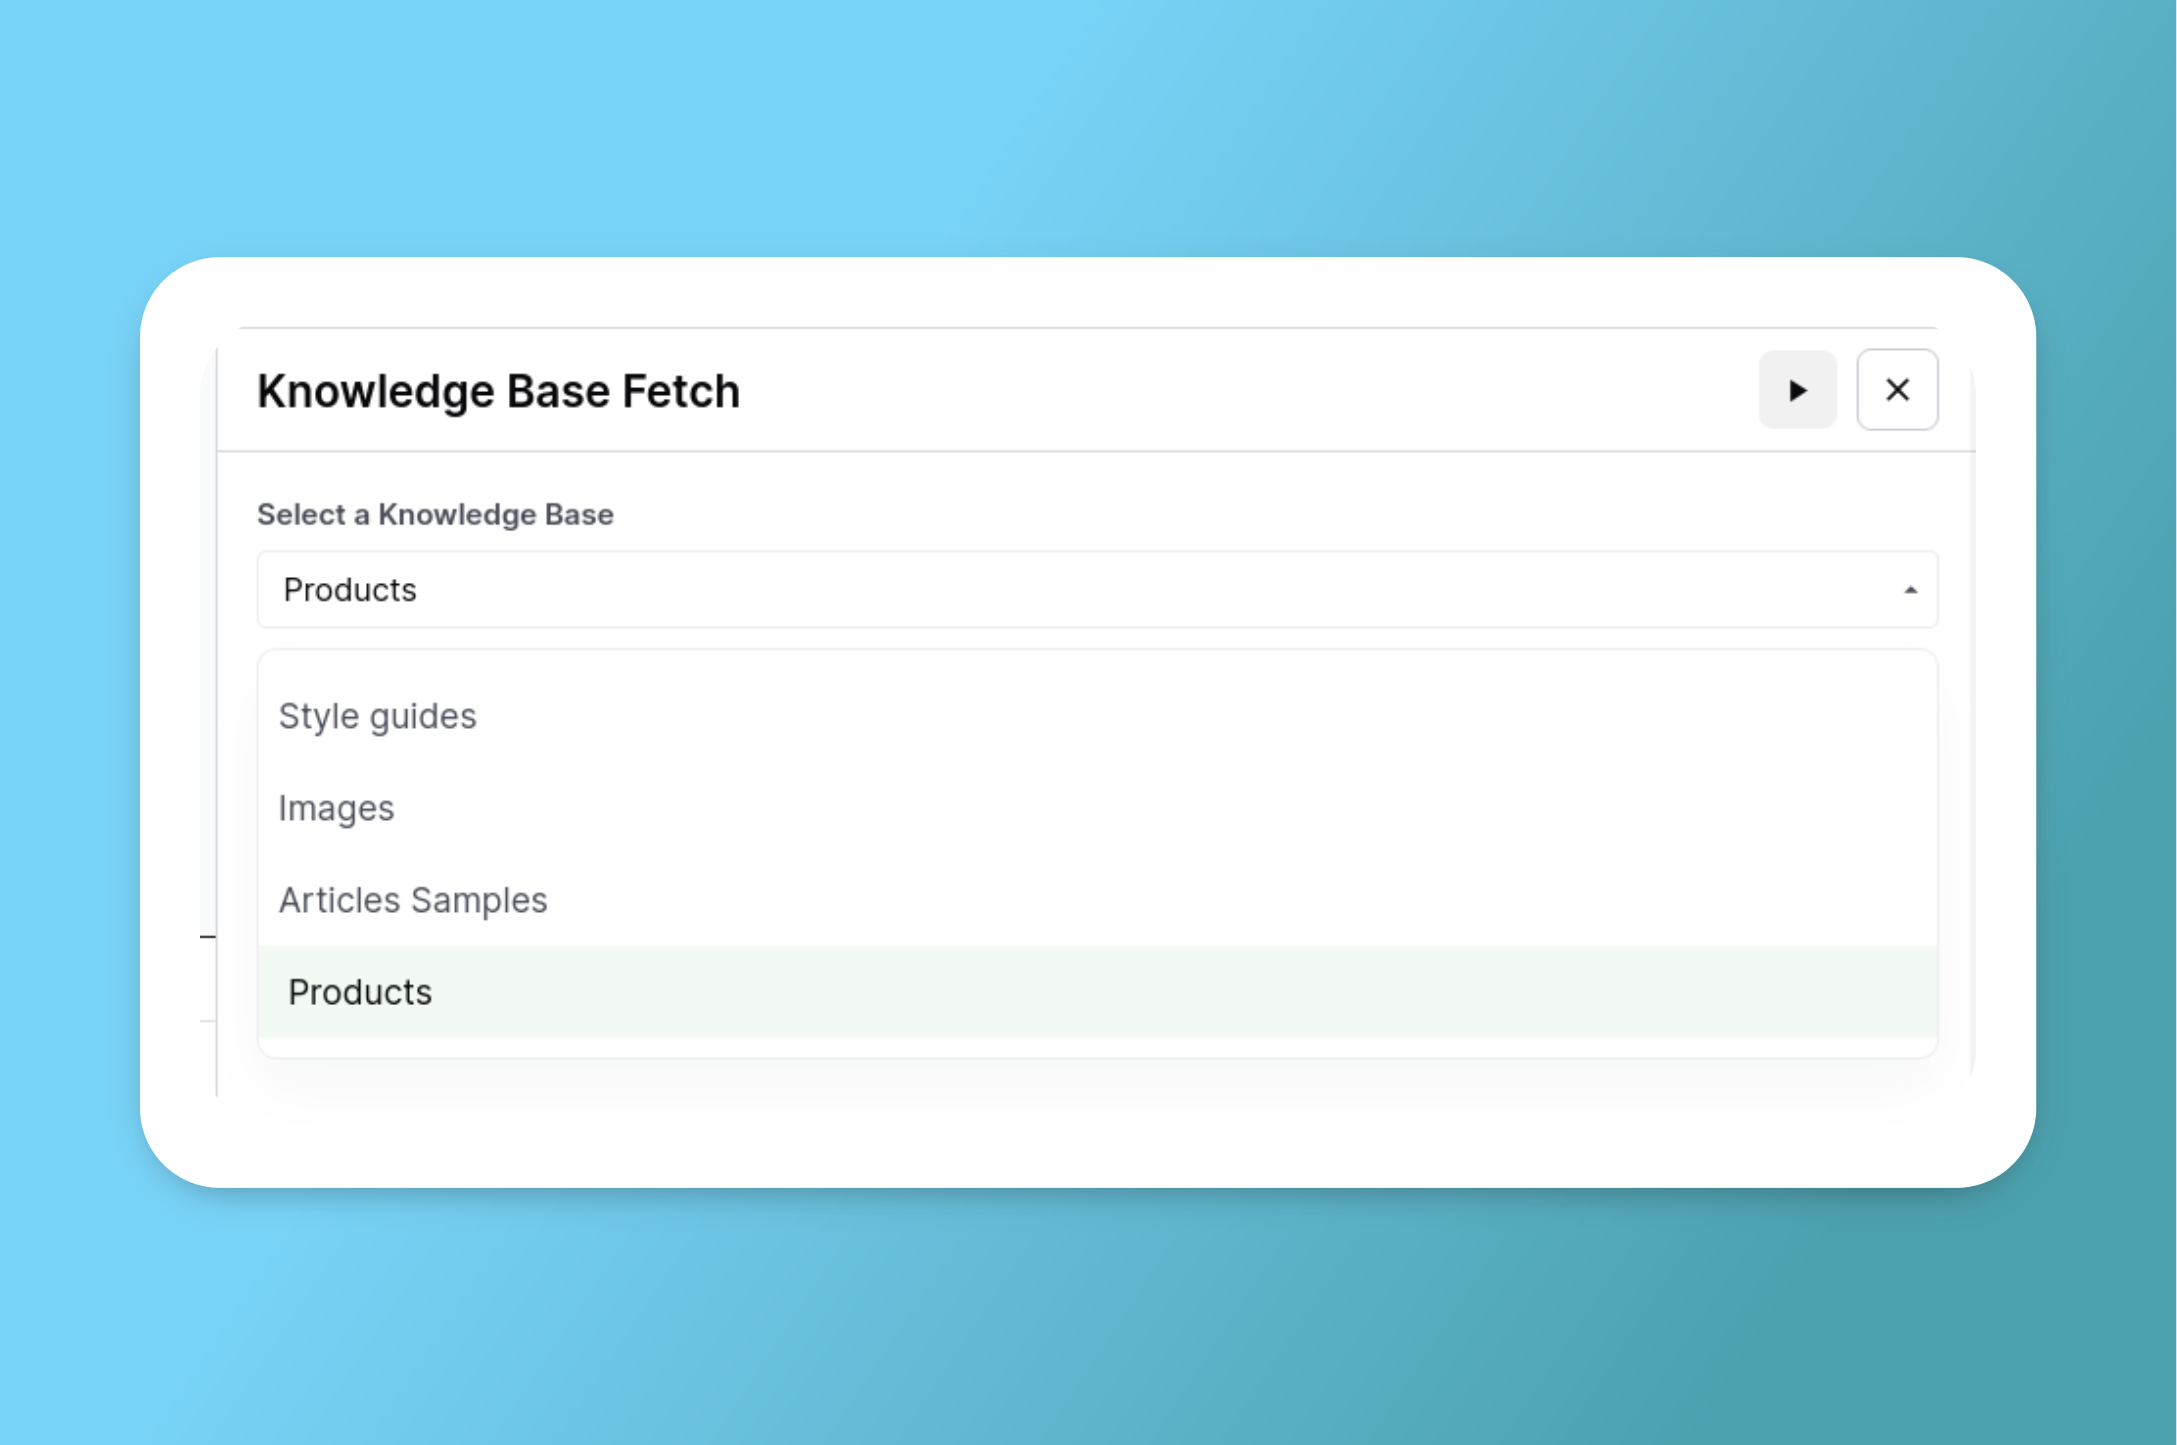
### Selecciona una Base de Conocimiento
Selecciona la Base de Conocimiento que deseas usar del menú desplegable.
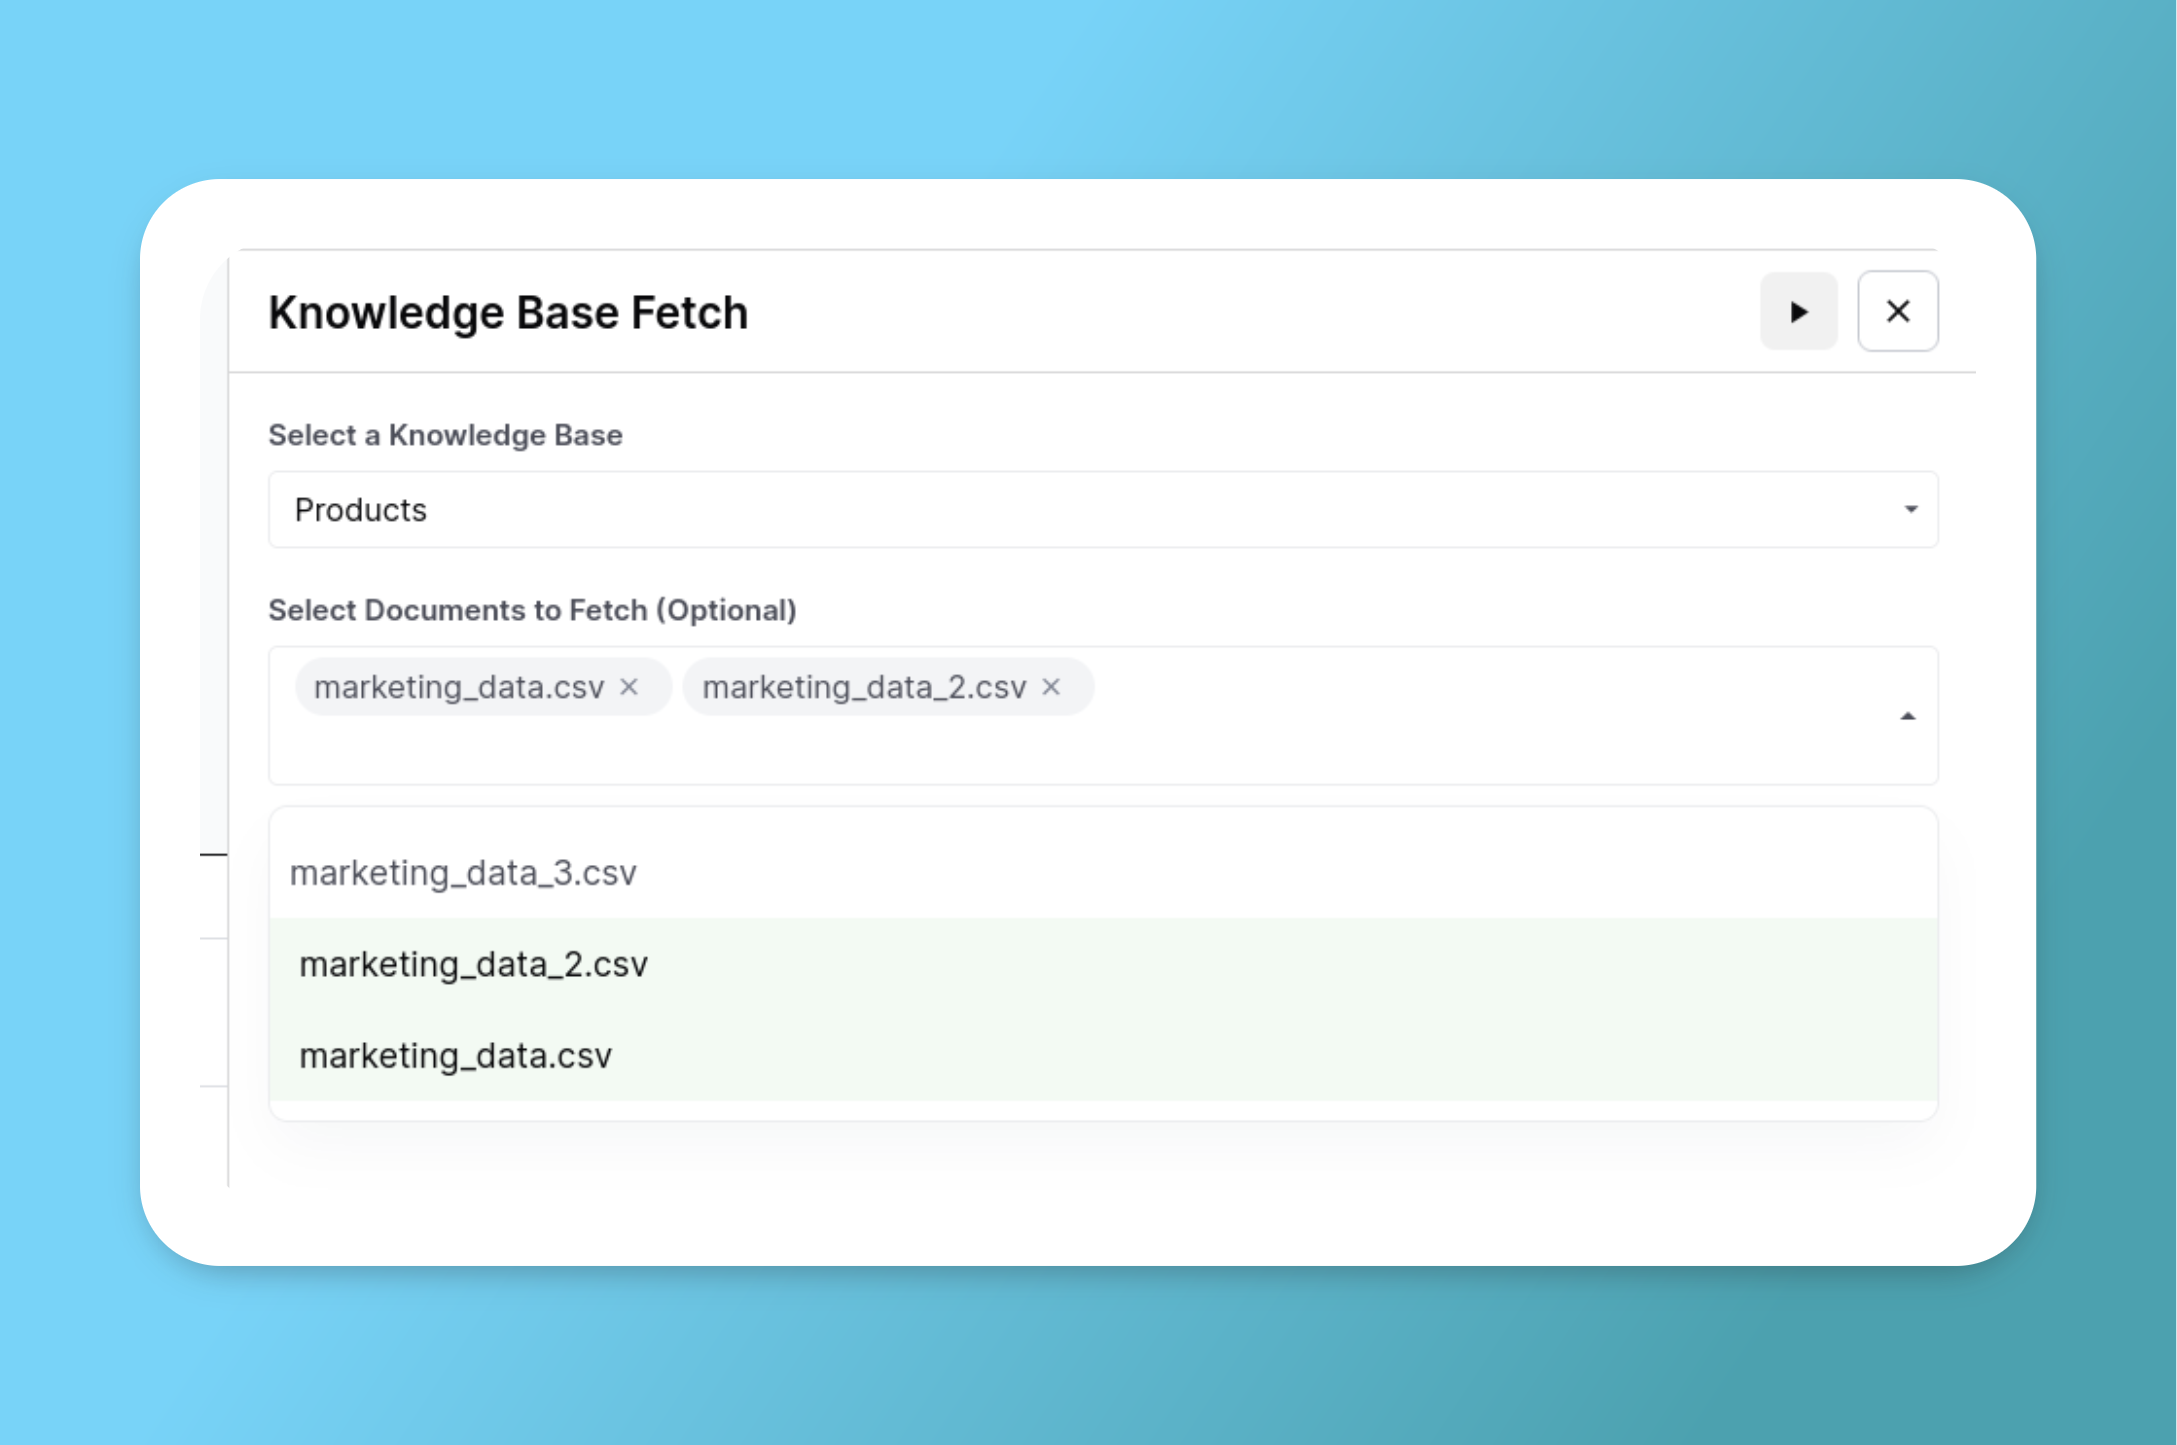
### Seleccionar archivos específicos (opcional)
Opcionalmente, puedes seleccionar varios documentos que deseas leer de una lista:
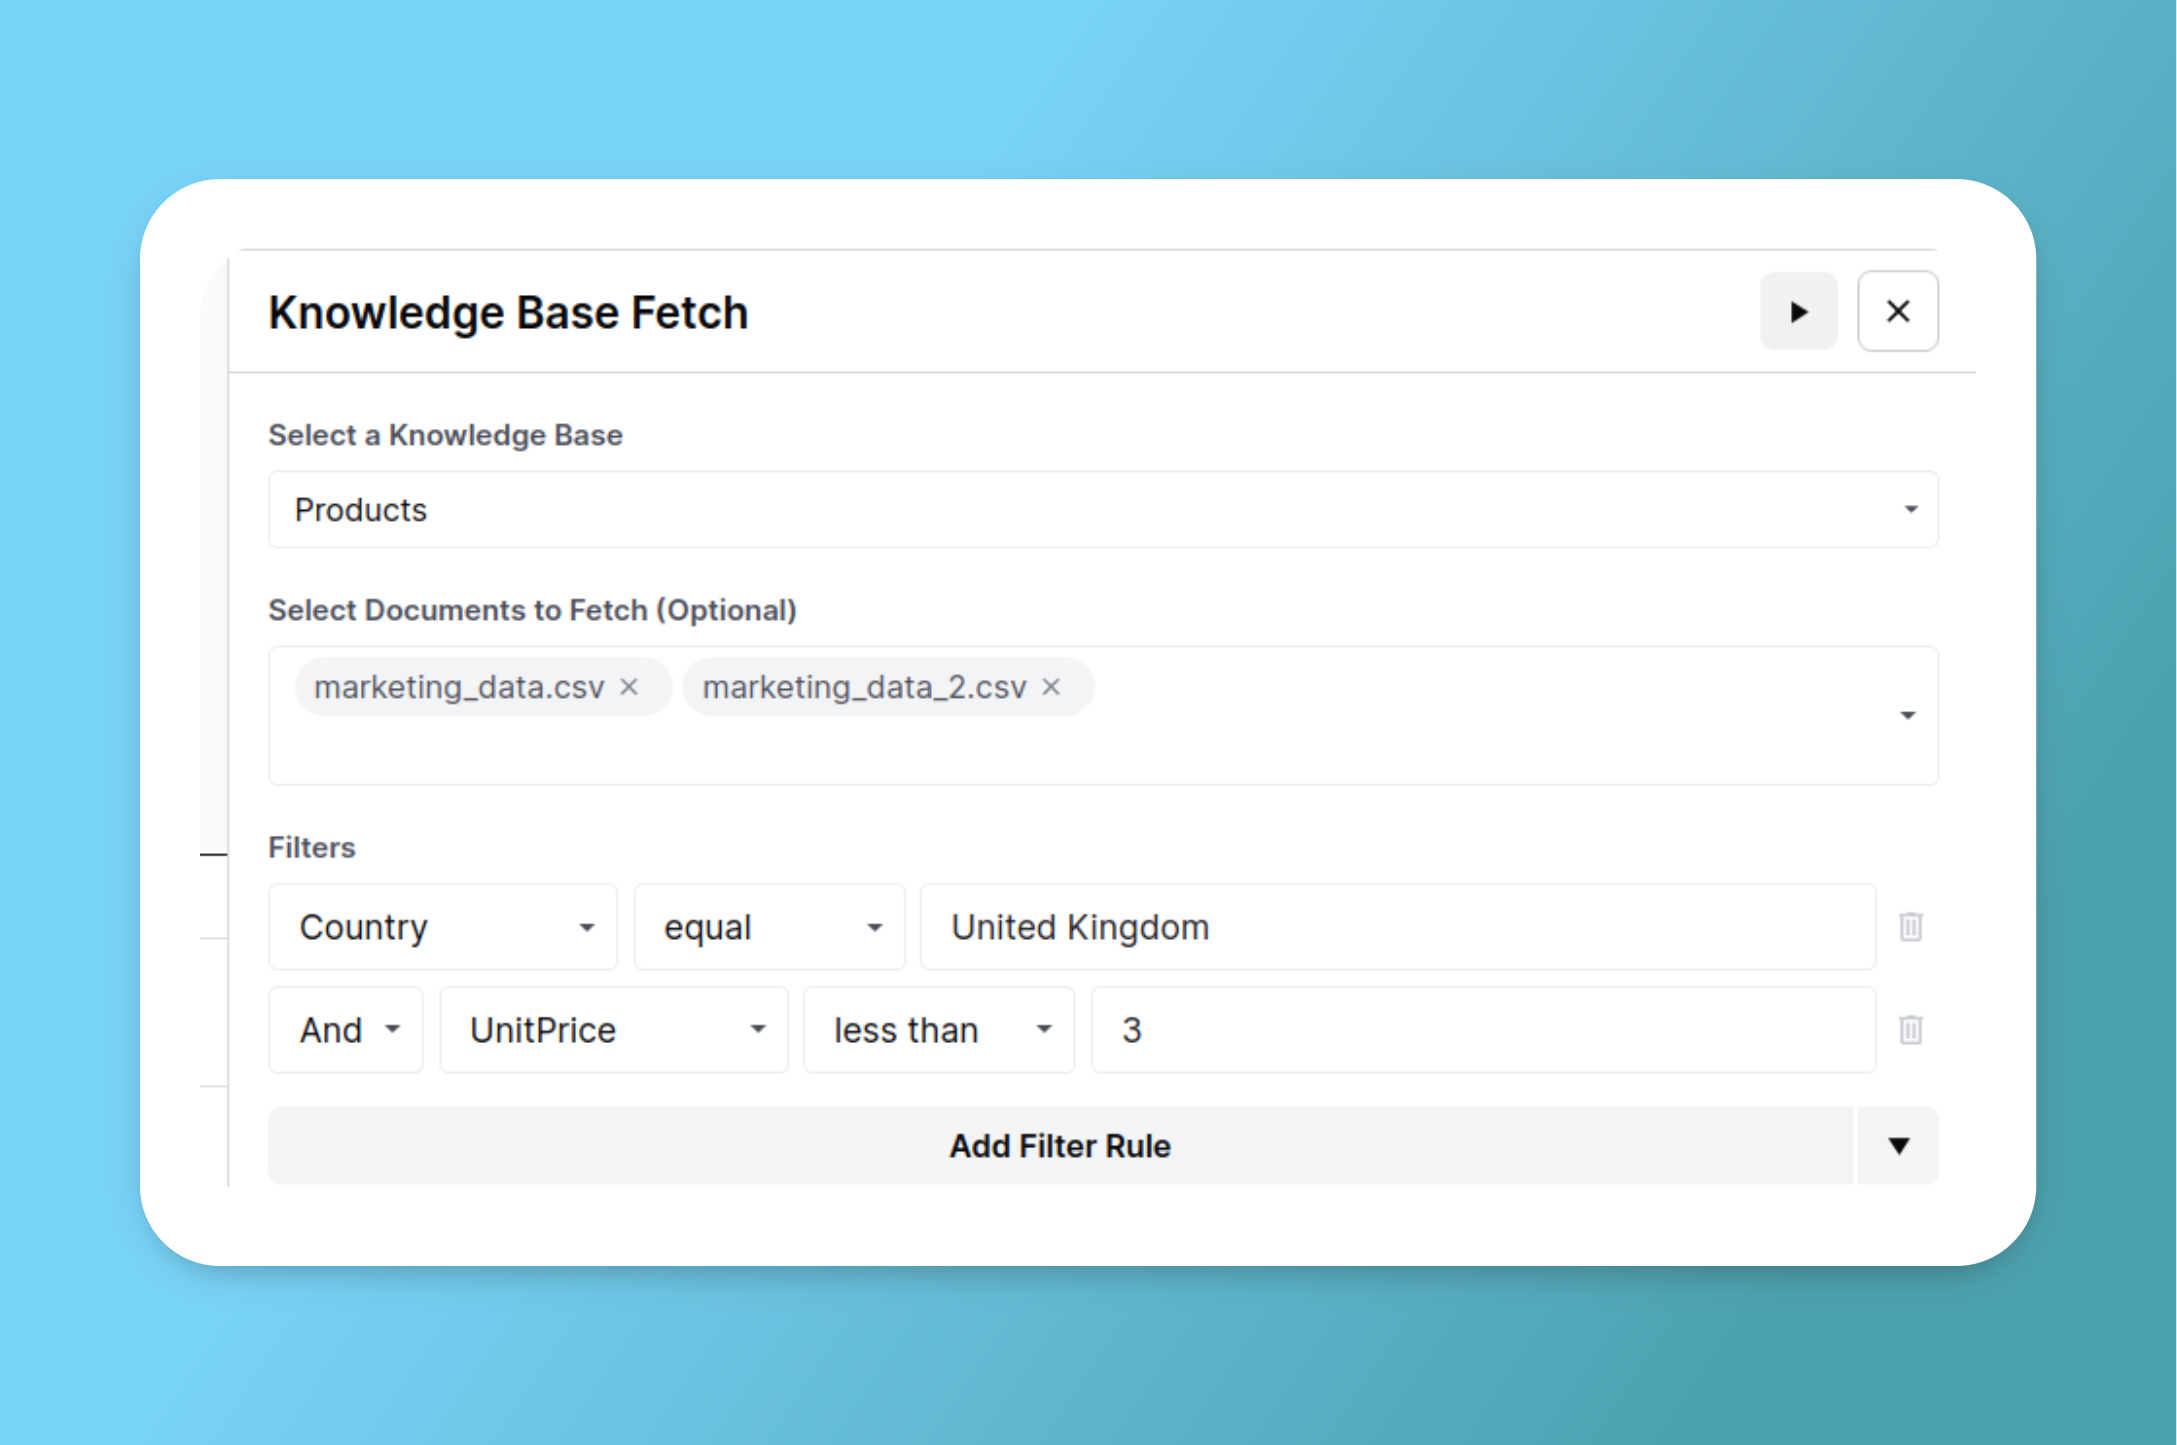
### Agregar filtros (opcional)
Puedes agregar filtros para reducir los resultados según los campos de metadatos. Esto incluye:
* **Metadatos estándar** heredados de la fuente (p. ej., nombre de archivo, URL de origen)
* **Metadatos personalizados** que has agregado para etiquetar archivos (p. ej., país, producto, audiencia)
* **Columnas de CSV/hoja** cuando la Base de Conocimiento contiene datos estructurados
**Ejemplo: Filtrado por metadatos personalizados**
Si tienes estudios de caso de clientes etiquetados con un `country` campo de metadatos personalizado, puedes filtrar para recuperar solo los estudios de caso de una región específica:
{% hint style="success" %}
**Filtrado dinámico**
Usa las entradas del flujo de trabajo para hacer dinámicos los filtros. Por ejemplo, establece el filtro en `country` es igual a `{{input.region}}` y el flujo de trabajo recuperará los archivos que coincidan con la región que se pase en tiempo de ejecución.
{% endhint %}
Para que el filtrado sea efectivo, te recomendamos leer [Metadatos de Bases de Conocimiento](/docs/es/contexto/memory-stores/memory-stores-metadata.md) para aprender cómo agregar etiquetas de metadatos personalizados a los archivos de tu Base de Conocimiento.
## Salida del paso de lectura de Base de Conocimiento
El paso de lectura de Base de Conocimiento generará una lista de documentos con sus respectivos registros. En nuestro ejemplo anterior de productos filtrados, la salida se verá así:
```json
[
{
"document_name": "marketing_data.csv",
"records": [
{
"__text": "PORTAVELAS COLGANTE DE CORAZÓN BLANCO\n\n-----\n\nReino Unido",
"InvoiceNo": 536365,
"StockCode": "85123A",
"Description": "PORTAVELAS COLGANTE DE CORAZÓN BLANCO",
"Quantity": 6,
"InvoiceDate": "12/1/2010 8:26",
"UnitPrice": 2.55,
"CustomerID": 17850,
"Country": "Reino Unido"
},
...
]
},
{
"document_name": "marketing_data_2.csv",
"records": [
{
"__text": "PERCHA DE CORAZONES CUPIDO CREMA\n\n-----\n\nReino Unido",
"InvoiceNo": 536365,
"StockCode": "84406B",
"Description": "PERCHA DE CORAZONES CUPIDO CREMA",
"Quantity": 8,
"InvoiceDate": "12/1/2010 8:26",
"UnitPrice": 2.75,
"CustomerID": 17850,
"Country": "Reino Unido"
},
...
]
}
]
```
Puedes notar que:
* Solo se devuelven los documentos que se seleccionaron del menú desplegable.
* Cada documento tiene adjunta una lista de registros. Como estos documentos son CSV, cada registro representa una fila diferente.
* Solo se devuelven los registros que coinciden con los filtros seleccionados (Reino Unido y UnitPrice < 3).
* Hay un campo especial "\_\_text" que muestra cuál es el texto buscable seleccionado durante la carga del CSV. Como en este caso solo se seleccionaron como buscables las columnas "Description" y "Country", esas son las columnas incrustadas en el campo "\_\_text".
A continuación se muestra un ejemplo de salida al recuperar un documento PDF:
```json
[
{
"document_name": "US_Congress-2023-SB546-Enrolled.pdf",
"records": [
{
"__text": "S. 546 \n\nCentésimo Decimoctavo Congreso de los Estados Unidos de América\n\nEN LA SEGUNDA SESIÓN\n\nComenzada y celebrada en la Ciudad de Washington el miércoles, el tercer día de enero de dos mil veinticuatro\n\nUna Ley\n\nPara enmendar la Ley Omnibus de Control del Crimen y Calles Seguras de 1968 para autorizar a las agencias de seguridad pública a usar subvenciones COPS para actividades de reclutamiento, y para otros fines...",
"__languages": [
"eng"
],
}
]
}
]
```
## Usar la salida del paso para hacer RAG
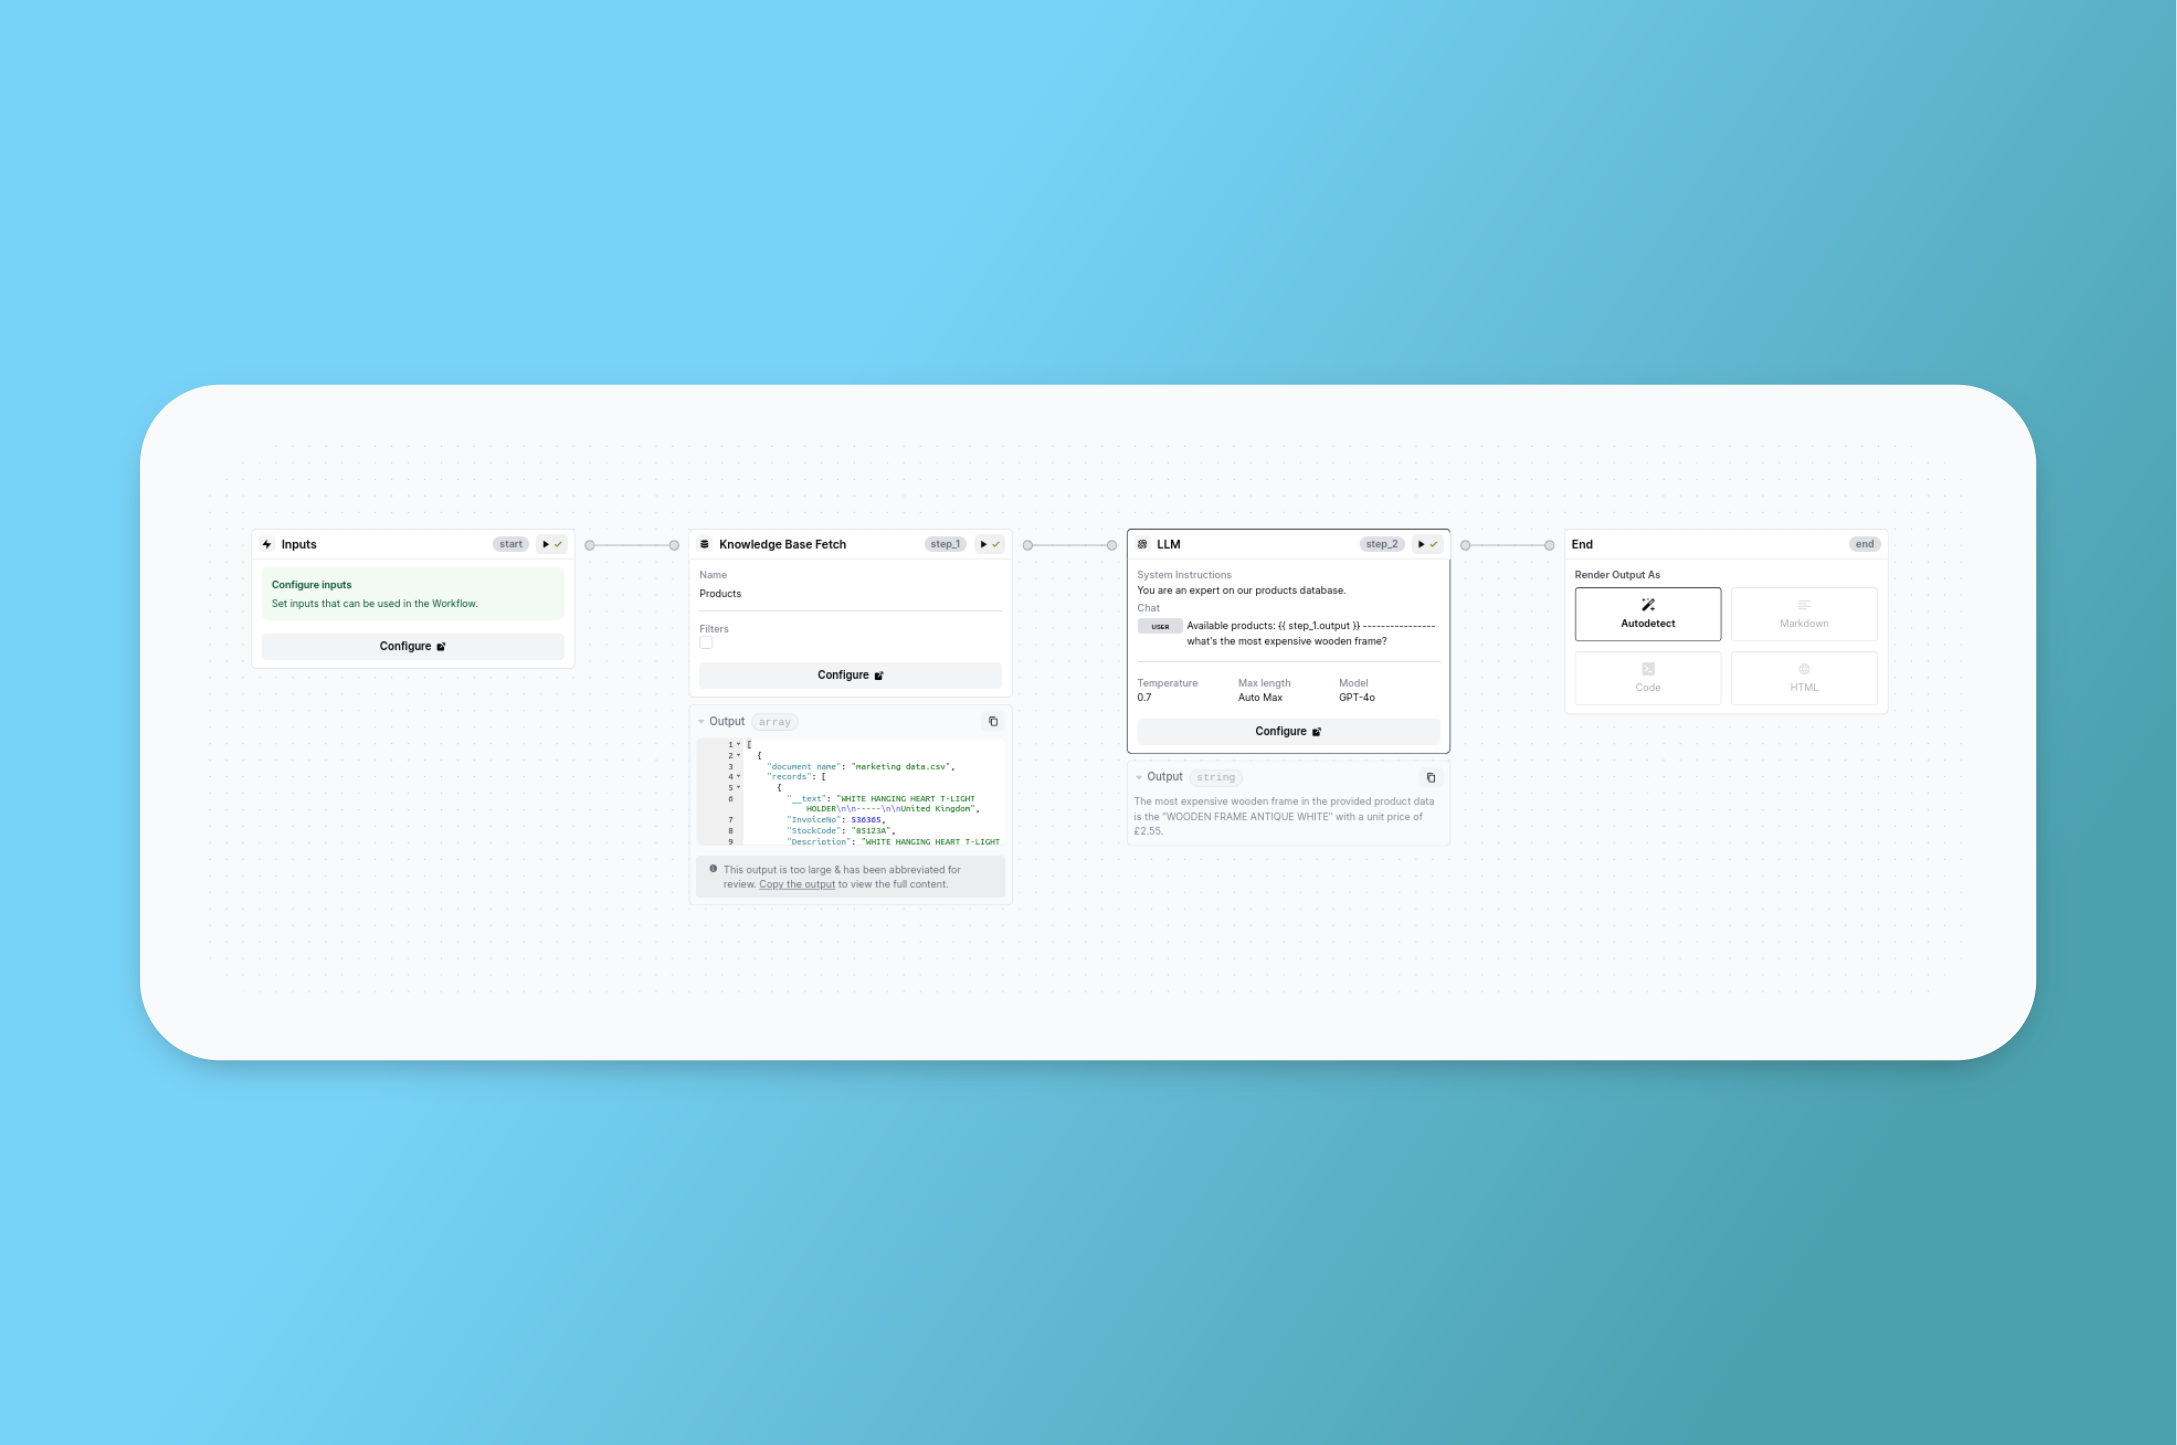
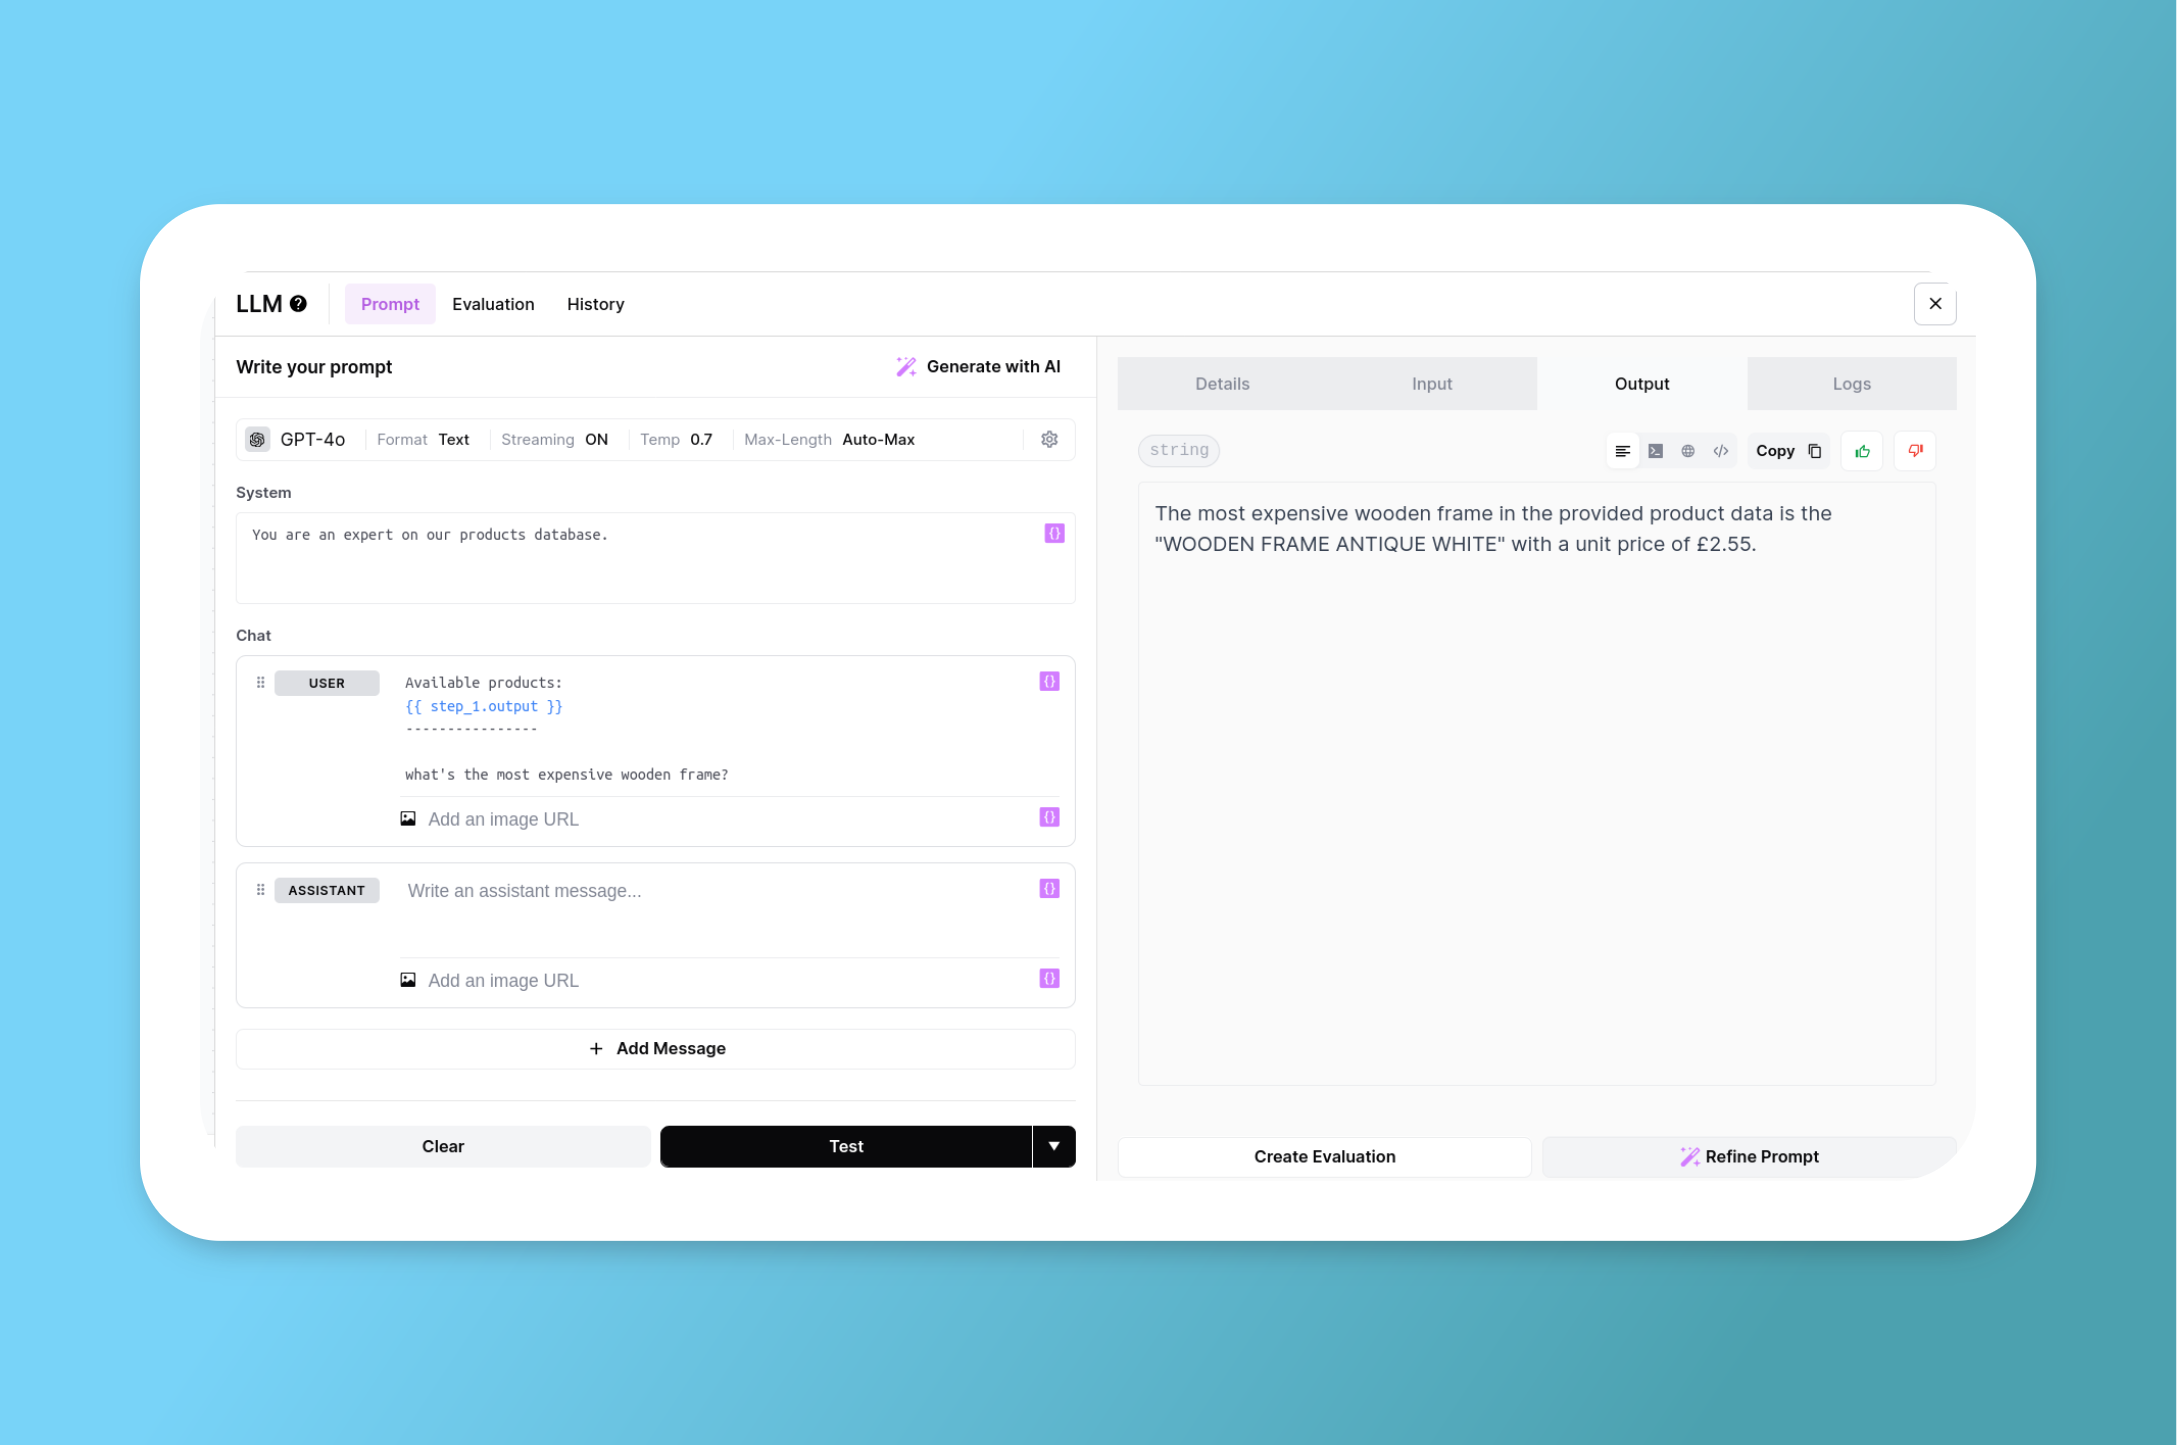
Podemos pasar la salida del paso de obtención de la Base de Conocimiento a un paso LLM para hacer Generación Aumentada por Recuperación.
Siguiendo con nuestro ejemplo de productos, podemos recuperar la lista completa de productos y pasarla a un paso LLM así:
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.airops.com/docs/es/acciones/workflow-concepts/workflow-steps/memory-steps/knowledge-base-read.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.