> For the complete documentation index, see [llms.txt](https://docs.airops.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.airops.com/docs/de/kontext/memory-stores/add-data/web-scrape.md).
# Web auslesen
## Verwendung von Web Scrape in Wissensdatenbanken
Mit Web Scrape können Sie Inhalte direkt von Websites in Ihre Wissensdatenbank importieren, sodass Sie vorhandene Seiten auf Ihrer Website ganz einfach für Anwendungsfälle wie interne Verlinkung nutzen können. Wählen Sie je nach Ihren spezifischen Anforderungen zwischen dem Extrahieren einzelner Seiten oder mehrerer Seiten über eine Sitemap.
## Einzelne Seite
So extrahieren Sie Inhalte von einer einzelnen Webseite:
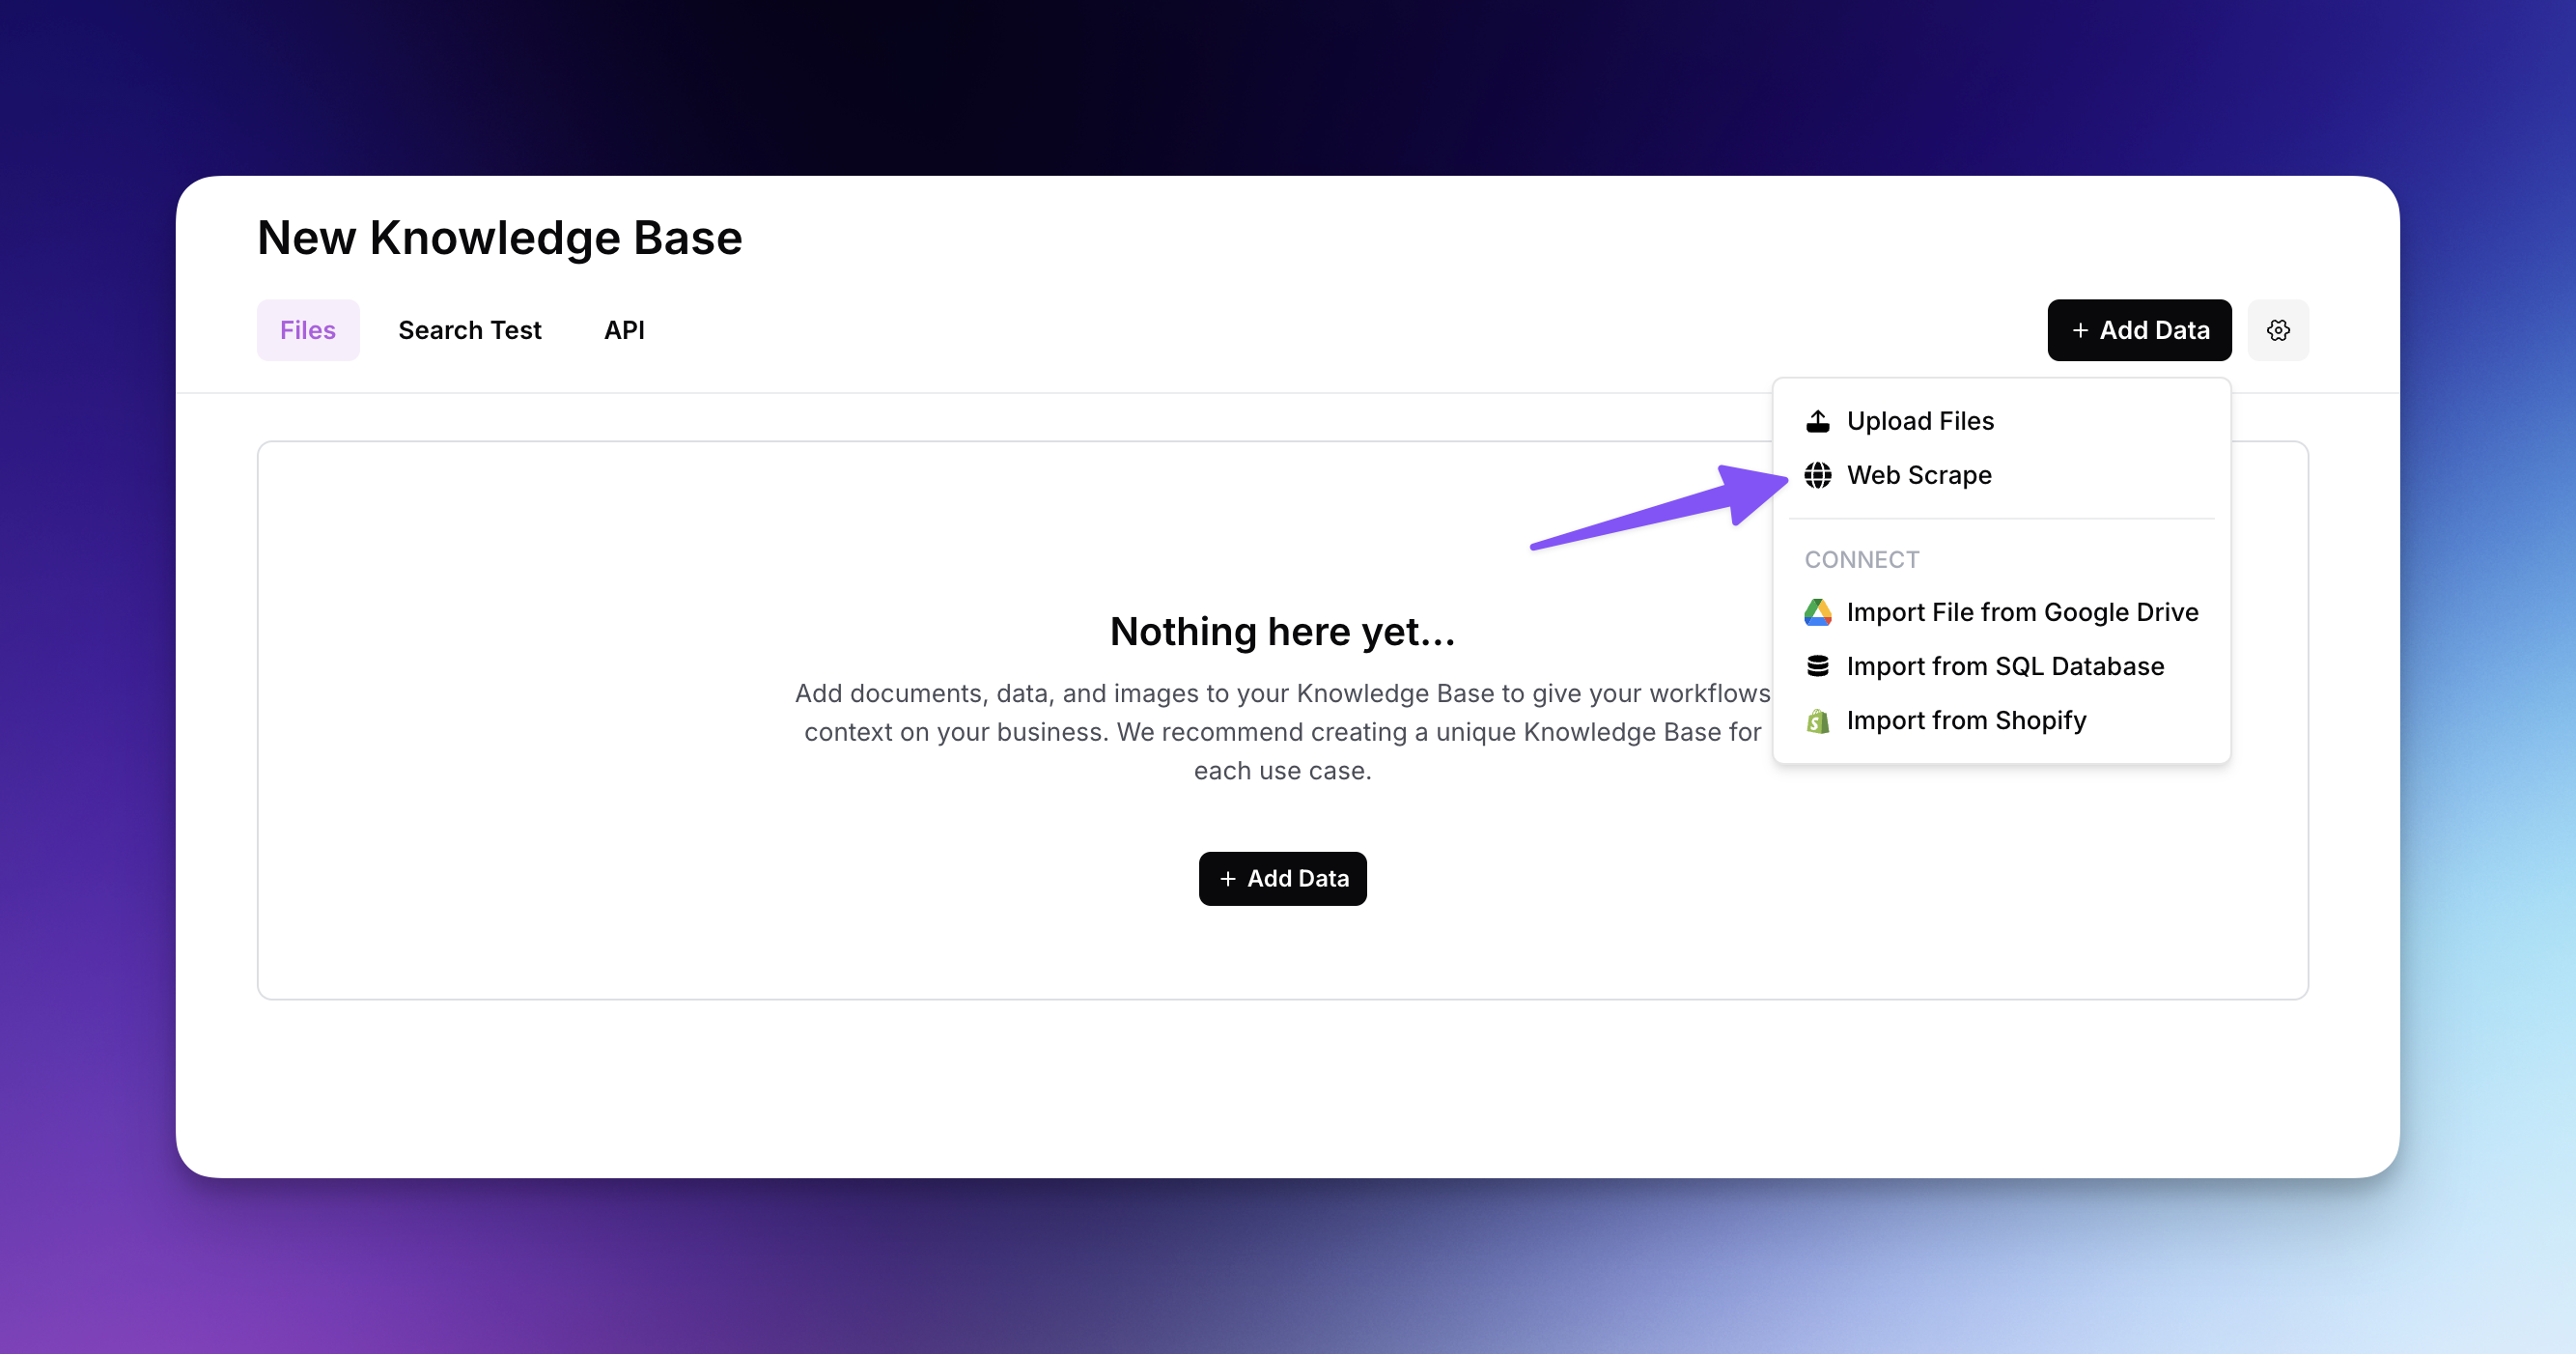
* Klicken Sie auf „Daten hinzufügen“ und wählen Sie „Web Scrape“ aus dem Dropdown-Menü
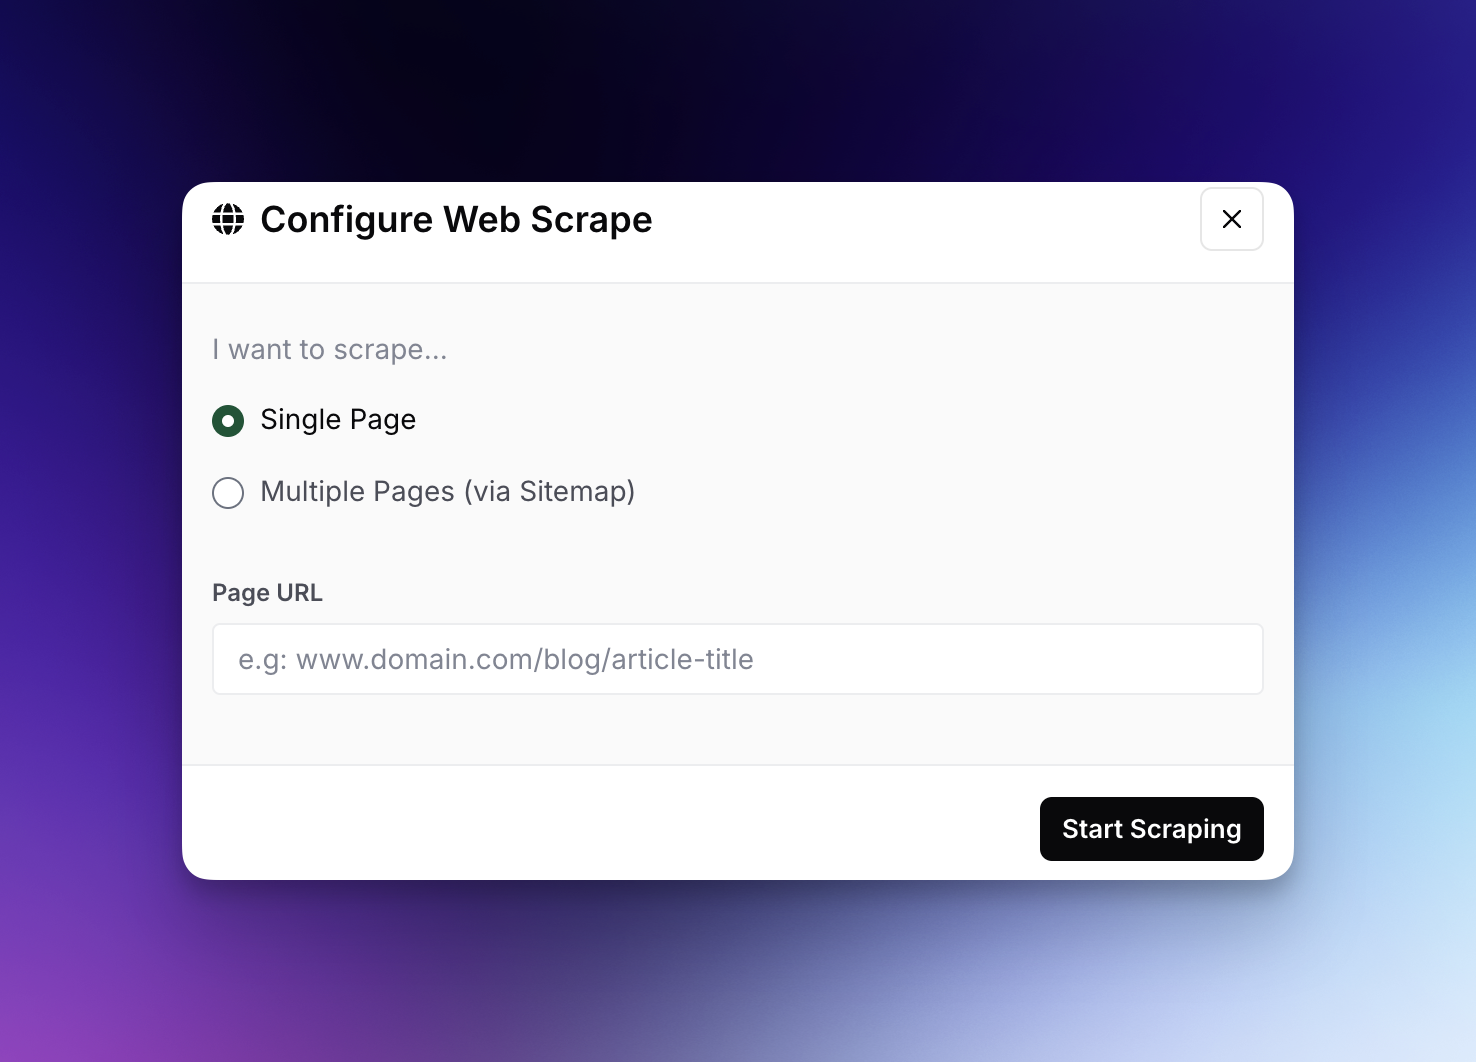
* Wählen Sie die Option „Einzelne Seite“
* Geben Sie die vollständige URL der Webseite ein, die Sie extrahieren möchten (z. B. [www.domain.com/blog/article-title](http://www.domain.com/blog/article-title))
* Klicken Sie auf „Scraping starten“, um den Prozess zu beginnen
* AirOps extrahiert und importiert den Inhalt in Ihre Wissensdatenbank, sodass er durchsuchbar wird
### Mehrere Seiten per Sitemap
So extrahieren Sie Inhalte von mehreren Webseiten mithilfe einer Sitemap:
* Klicken Sie auf „Daten hinzufügen“ und wählen Sie „Web Scrape“ aus dem Dropdown-Menü
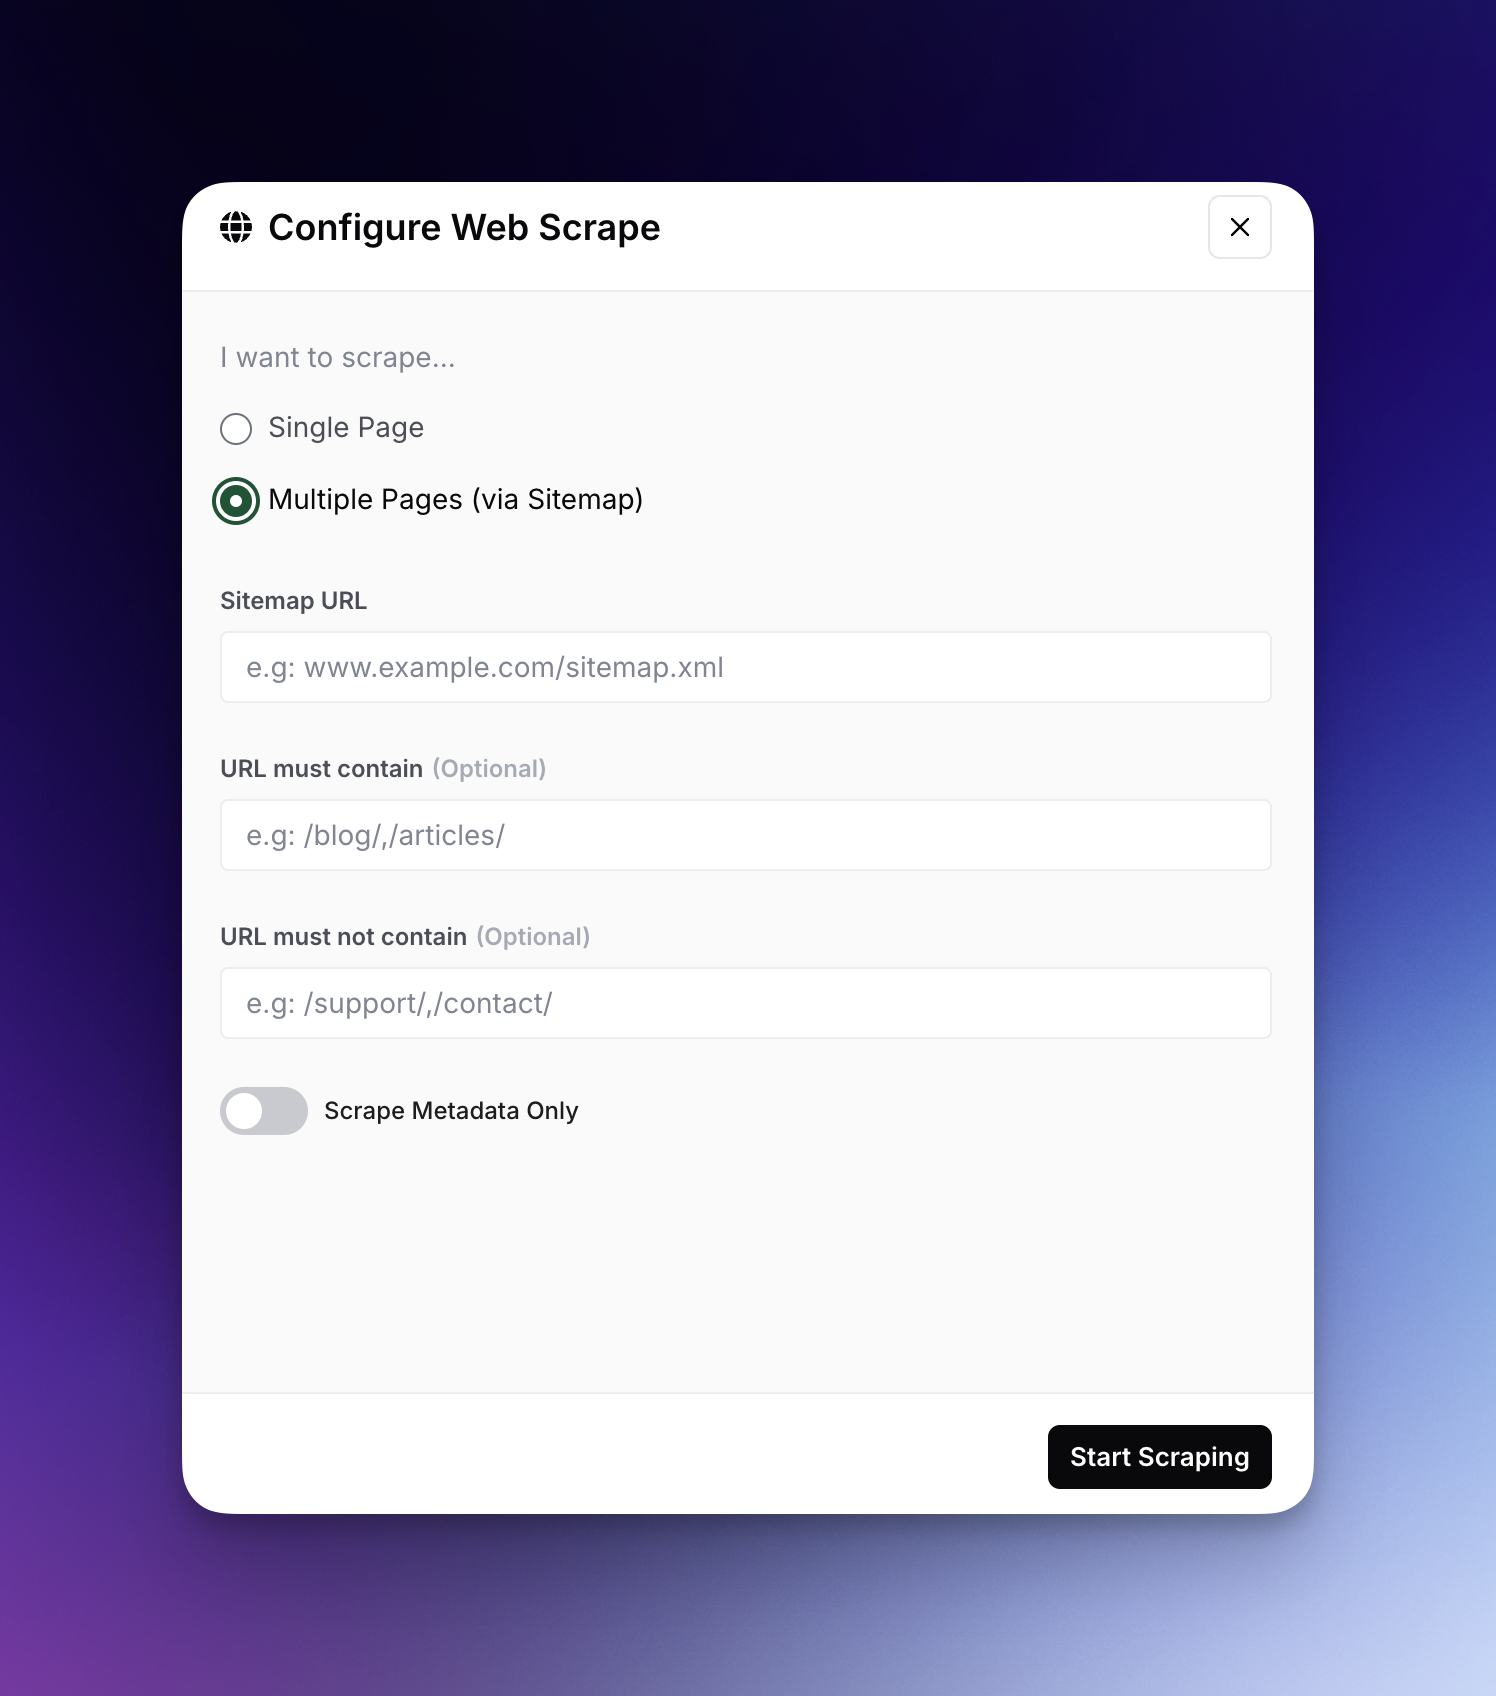
* Wählen Sie die Option „Mehrere Seiten (per Sitemap)“
* Geben Sie die Sitemap-URL ein (typischerweise zu finden unter domain.com/sitemap.xml)
* Optional können Sie URL-Muster angeben, um bestimmte Seiten einzuschließen oder auszuschließen (z. B. „/blog/“ einschließen oder „/support/“ ausschließen)
* Schalten Sie „Nur Metadaten extrahieren“ ein, wenn Sie nur Seitentitel und Beschreibungen statt des vollständigen Inhalts benötigen
* Klicken Sie auf „Scraping starten“, um den Prozess zu beginnen und alle übereinstimmenden Seiten zu importieren
Sobald eine Sitemap zu Ihrer Wissensdatenbank hinzugefügt wurde, können Sie den Inhalt aktuell halten, indem Sie auf das Zahnradsymbol neben „1 geplante Synchronisierung“ klicken und entweder Folgendes auswählen:
* „Daten synchronisieren“, um manuell eine sofortige Synchronisierung auszulösen und die neuesten Inhalte abzurufen
* „Daten-Synchronisierung planen“, um eine automatisierte, wiederkehrende Synchronisierung in Ihrem bevorzugten Rhythmus einzurichten. Sitemap-Connectoren unterstützen **Stunde**, **Tag**, **Woche**und **Monat** Zeitpläne. Wählen Sie Monat für große oder sich langsam ändernde Websites, bei denen wöchentliche erneute Synchronisierungen mehr Aufwand bedeuten, als Sie benötigen.
{% @arcade/embed url="" flowId="sqgFTsbvoWnJJgwiRYIU" %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.airops.com/docs/de/kontext/memory-stores/add-data/web-scrape.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.