> For the complete documentation index, see [llms.txt](https://docs.airops.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.airops.com/docs/de/aktionen/workflow-concepts/workflow-steps/web-research/web-page-scrape.md).
# Webseite auslesen
Text, Markdown oder HTML von einer Website auslesen
Der Schritt „Web Page Scrape“ ermöglicht es Ihnen, einen Text-/Markdown-/HTML-Scrape von einer bestimmten URL zu automatisieren. Sie können dies mit einem Iteration-Schritt kombinieren, um mehrere Websites zu scrapen und die Ausgaben separat zu parsen.
## Konfigurieren des Schritts „Web Page Scrape“
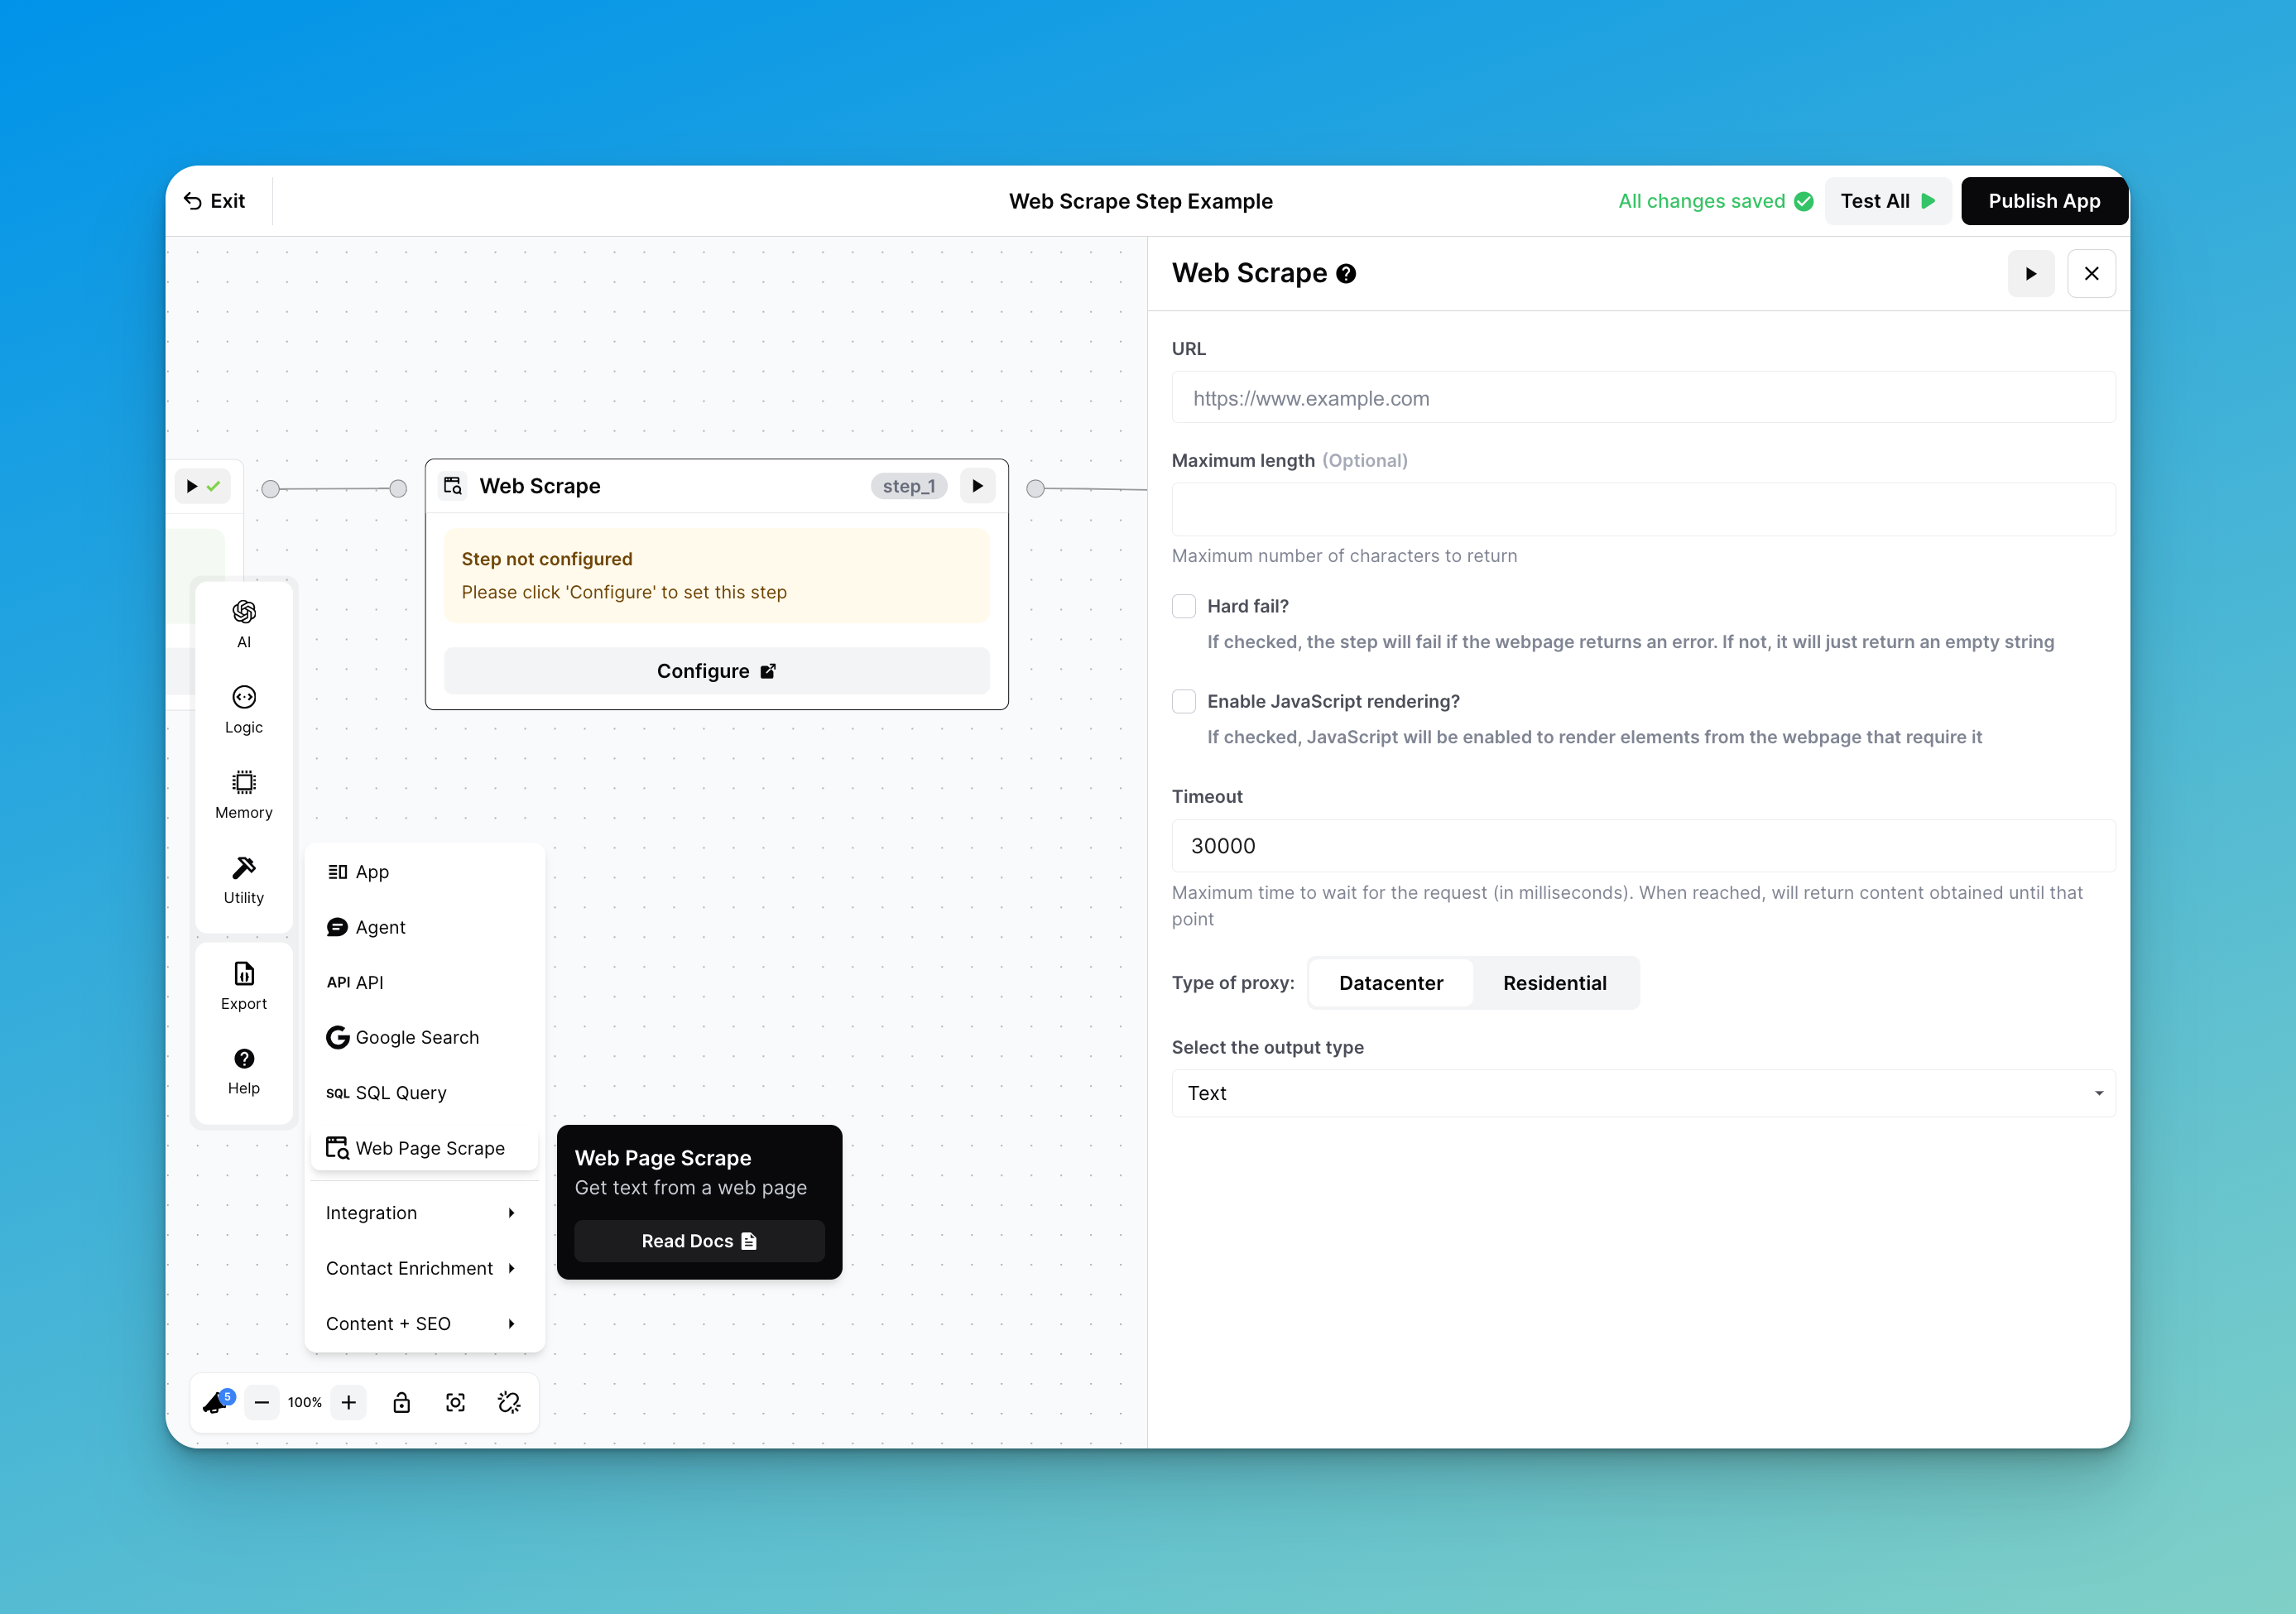
Die Konfiguration des Schritts erfordert die unten gezeigten Parameter:
Konfigurieren Sie Ihre Web-Page-Scrape-Parameter
### URL
Fügen Sie die spezifische URL hinzu, die der Schritt scrapen soll.
### Maximale Länge
Optional können Sie die Anzahl der vom Schritt zurückgegebenen Zeichen begrenzen.
Dieser Parameter kann hilfreich sein, um die Menge an Text zu begrenzen, die an einen nachfolgenden LLM-Schritt übergeben wird, der ein begrenztes Kontextfenster hat.
{% hint style="warning" %}
**1 Token entspricht ungefähr 4 Zeichen im Englischen.** Um die Anzahl der Zeichen abzuschätzen, die Sie an einen LLM-Schritt übergeben sollten, multiplizieren Sie die Anzahl der Token, die Sie übergeben möchten, mit 4.
{% endhint %}
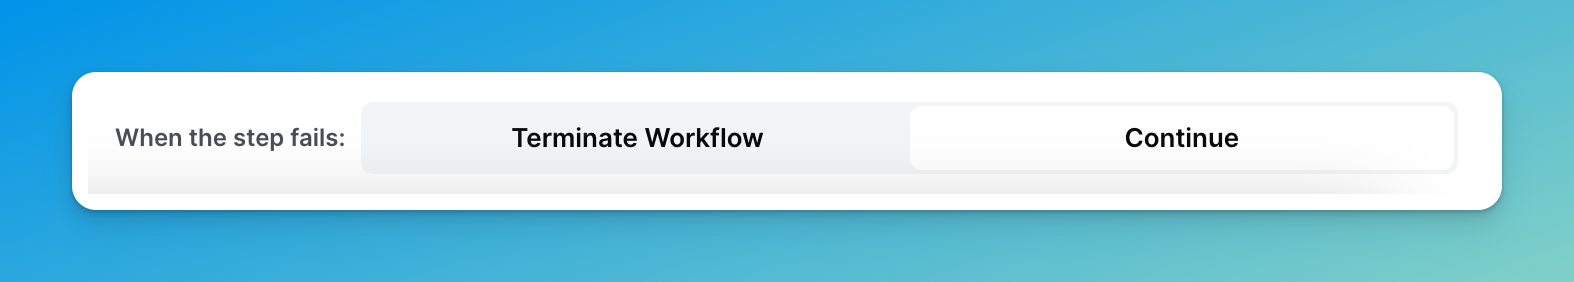
### Wie fortfahren, wenn der Web-Scrape-Schritt fehlschlägt
Standardmäßig beendet der Code-Step den Workflow, wenn er fehlschlägt. Um den Workflow jedoch fortzusetzen, wenn der Schritt fehlschlägt, klicken Sie einfach auf `Weiter` am unteren Rand des Schritts.
Klicken Sie auf Fortfahren, um den Workflow fortzusetzen
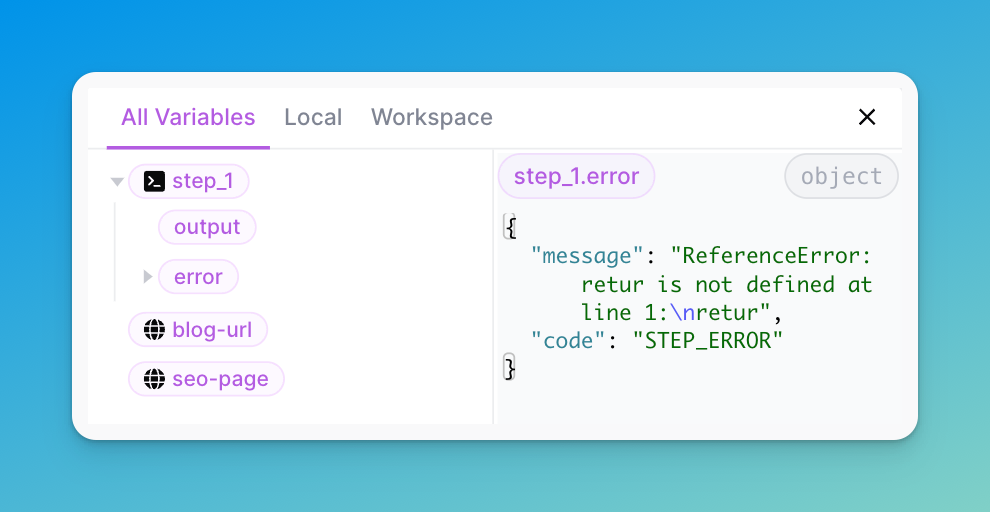
Der Schritt gibt die folgenden Schlüssel zurück:
* `Ausgabe` : dies wird `null`
* `Fehler` :
* `Meldung`: die vom Schritt zurückgegebene Meldung
* `Code` : der den Fehler darstellende Fehlercode
### JavaScript-Rendering aktivieren?
Standardmäßig rendert der Schritt „Web Page Scrape“ keine Websites, die JavaScript verwenden.
Aktivieren Sie dieses Kontrollkästchen, um das Scrapen von Websites zu ermöglichen, die JavaScript verwenden, um dynamische Inhalte zu rendern (Beispiele sind Facebook, Airbnb und mehr).
### Zeitüberschreitung
Die maximale Zeit in Millisekunden, die auf die Rückgabe Ihrer Web-Scrape-Ergebnisse gewartet wird.
### Proxy-Typ:
Verwende die **Residential-Proxy** für Websites, die mehr Zuverlässigkeit und höhere Erfolgsraten erfordern. Verwenden Sie hingegen den **Datacenter-Proxy** wo Zuverlässigkeit und Erfolgsraten keine Rolle spielen.
**Datencenter:**
* Private IP-Adressen, die in Rechenzentren untergebracht sind
* Bieten höhere Geschwindigkeit, sind aber hinsichtlich der Anonymität weniger zuverlässig
* Werden von Websites und Internetdiensten eher erkannt und blockiert.
#### Residential
* Eine echte IP-Adresse, die mit einem physischen Standort verknüpft ist
* Web Scraping wird so erscheinen, als käme es von einem privaten Haushalt an einem bestimmten Standort
* Gilt als legitimer und wird von Websites weniger wahrscheinlich blockiert
{% hint style="info" %}
Hinweis: Die Verwendung eines Residential-Proxys ist teurer als die Verwendung eines Datacenter-Proxys, daher ist es sinnvoll, dies bei der Entscheidung, welchen Proxy Sie verwenden, mit Ihrem Anwendungsfall abzuwägen.
{% endhint %}
#### Header
Verwenden Sie dieses Feld, um benutzerdefinierte Header für die Web-Scrape-Anfrage zu übergeben. Stellen Sie sicher, dass die Header im gültigen JSON-Format vorliegen. Zum Beispiel:
```javascript
{
"authorization": "Bearer YOUR_API_KEY",
"Content-Type": "{{ a_variable }}"
}
```
### Ausgabetyp
* **Text:** Keine Formatierung enthalten
* **HTML:** Header und Formatierung von einer Website in HTML extrahieren
* **Markdown:** Die Header von einer Website in Markdown extrahieren
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.airops.com/docs/de/aktionen/workflow-concepts/workflow-steps/web-research/web-page-scrape.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.