> For the complete documentation index, see [llms.txt](https://docs.airops.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.airops.com/docs/de/aktionen/workflow-concepts/workflow-steps/memory-steps/knowledge-base-read.md).
# Datei aus Wissensdatenbank abrufen
Lesen Sie Daten aus Ihren Wissensdatenbanken mithilfe von Filtern.
## Was ist ein Leseschritt für die Wissensdatenbank?
Der Leseschritt für die Wissensdatenbank ermöglicht es dir, deine Wissensdatenbanken mithilfe von Filtern abzufragen, um relevante Daten für die Verwendung in deinen Workflows zu erhalten. Das ist besonders hilfreich beim [Retrieval-gestützte Generierung](https://en.wikipedia.org/wiki/Retrieval-augmented_generation) (RAG).
Der Hauptunterschied zwischen diesem Schritt und dem [Suche in der Wissensdatenbank](/docs/de/aktionen/workflow-concepts/workflow-steps/memory-steps/memory-search.md) Schritt besteht darin, dass du im Suchschritt Abfragen ausführen und Textausschnitte erhalten kannst, während der Leseschritt es dir ermöglicht, Filter anzuwenden und vollständige Dokumente zu erhalten.
Weitere Informationen zum Einrichten einer Wissensdatenbank findest du auf unserer Dokumentationsseite [hier](/docs/de/kontext/memory-stores.md).
## So konfigurierst du einen Leseschritt für die Wissensdatenbank
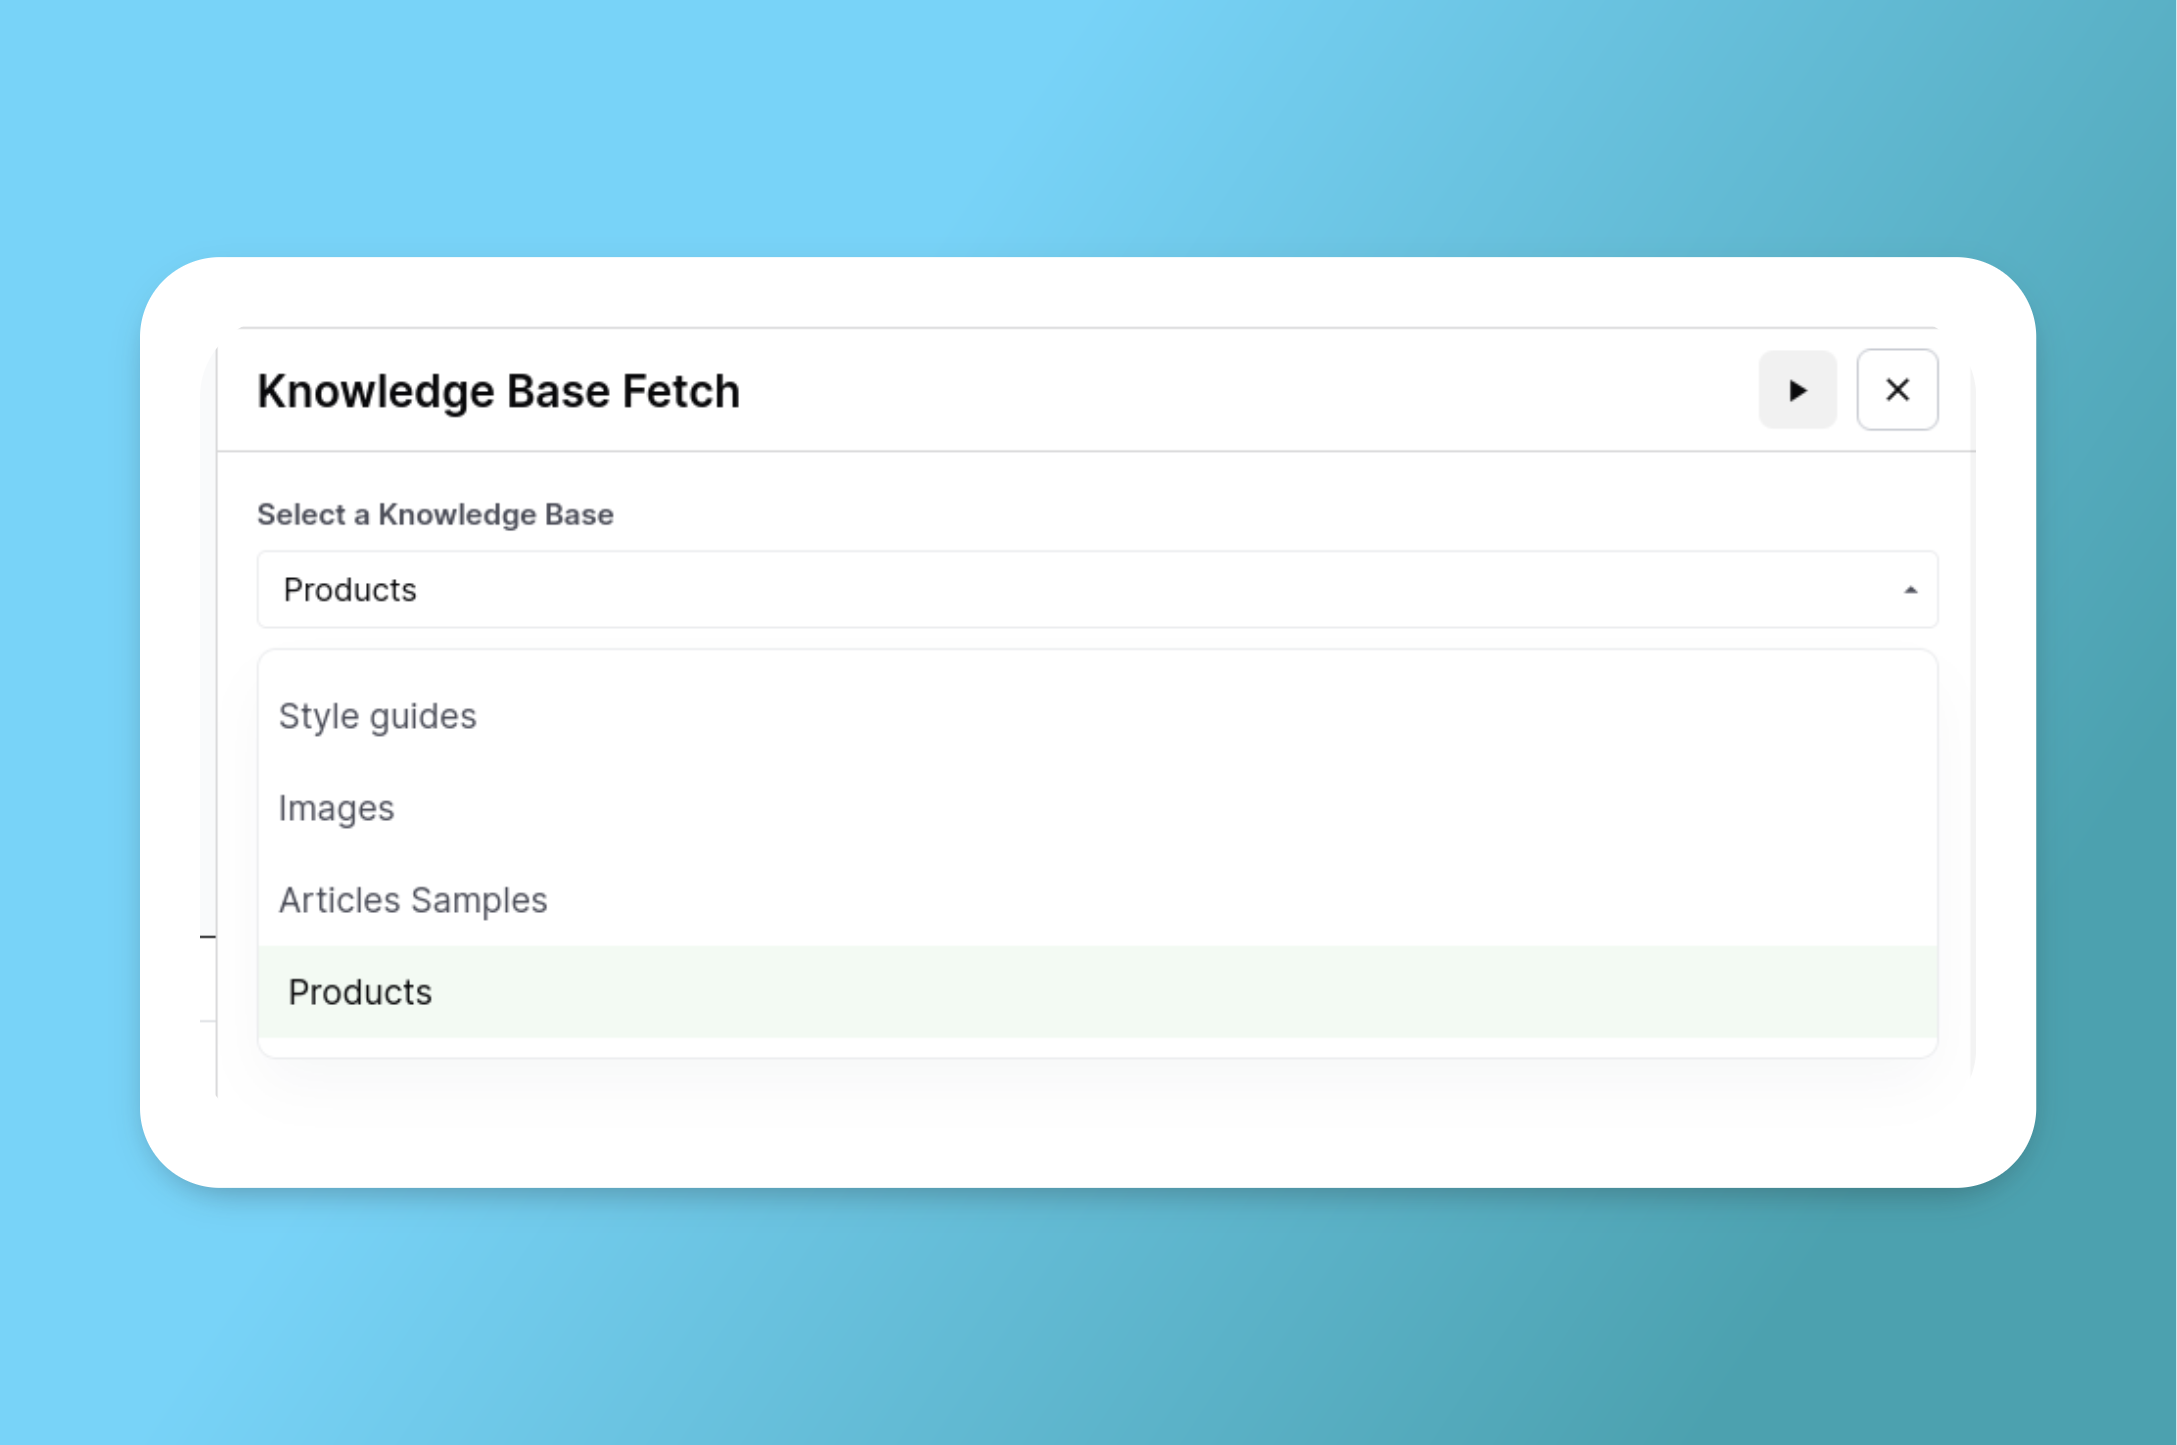
### Wählen Sie eine Knowledge Base aus
Wähle die Wissensdatenbank aus, die du aus dem Dropdown-Menü verwenden möchtest.
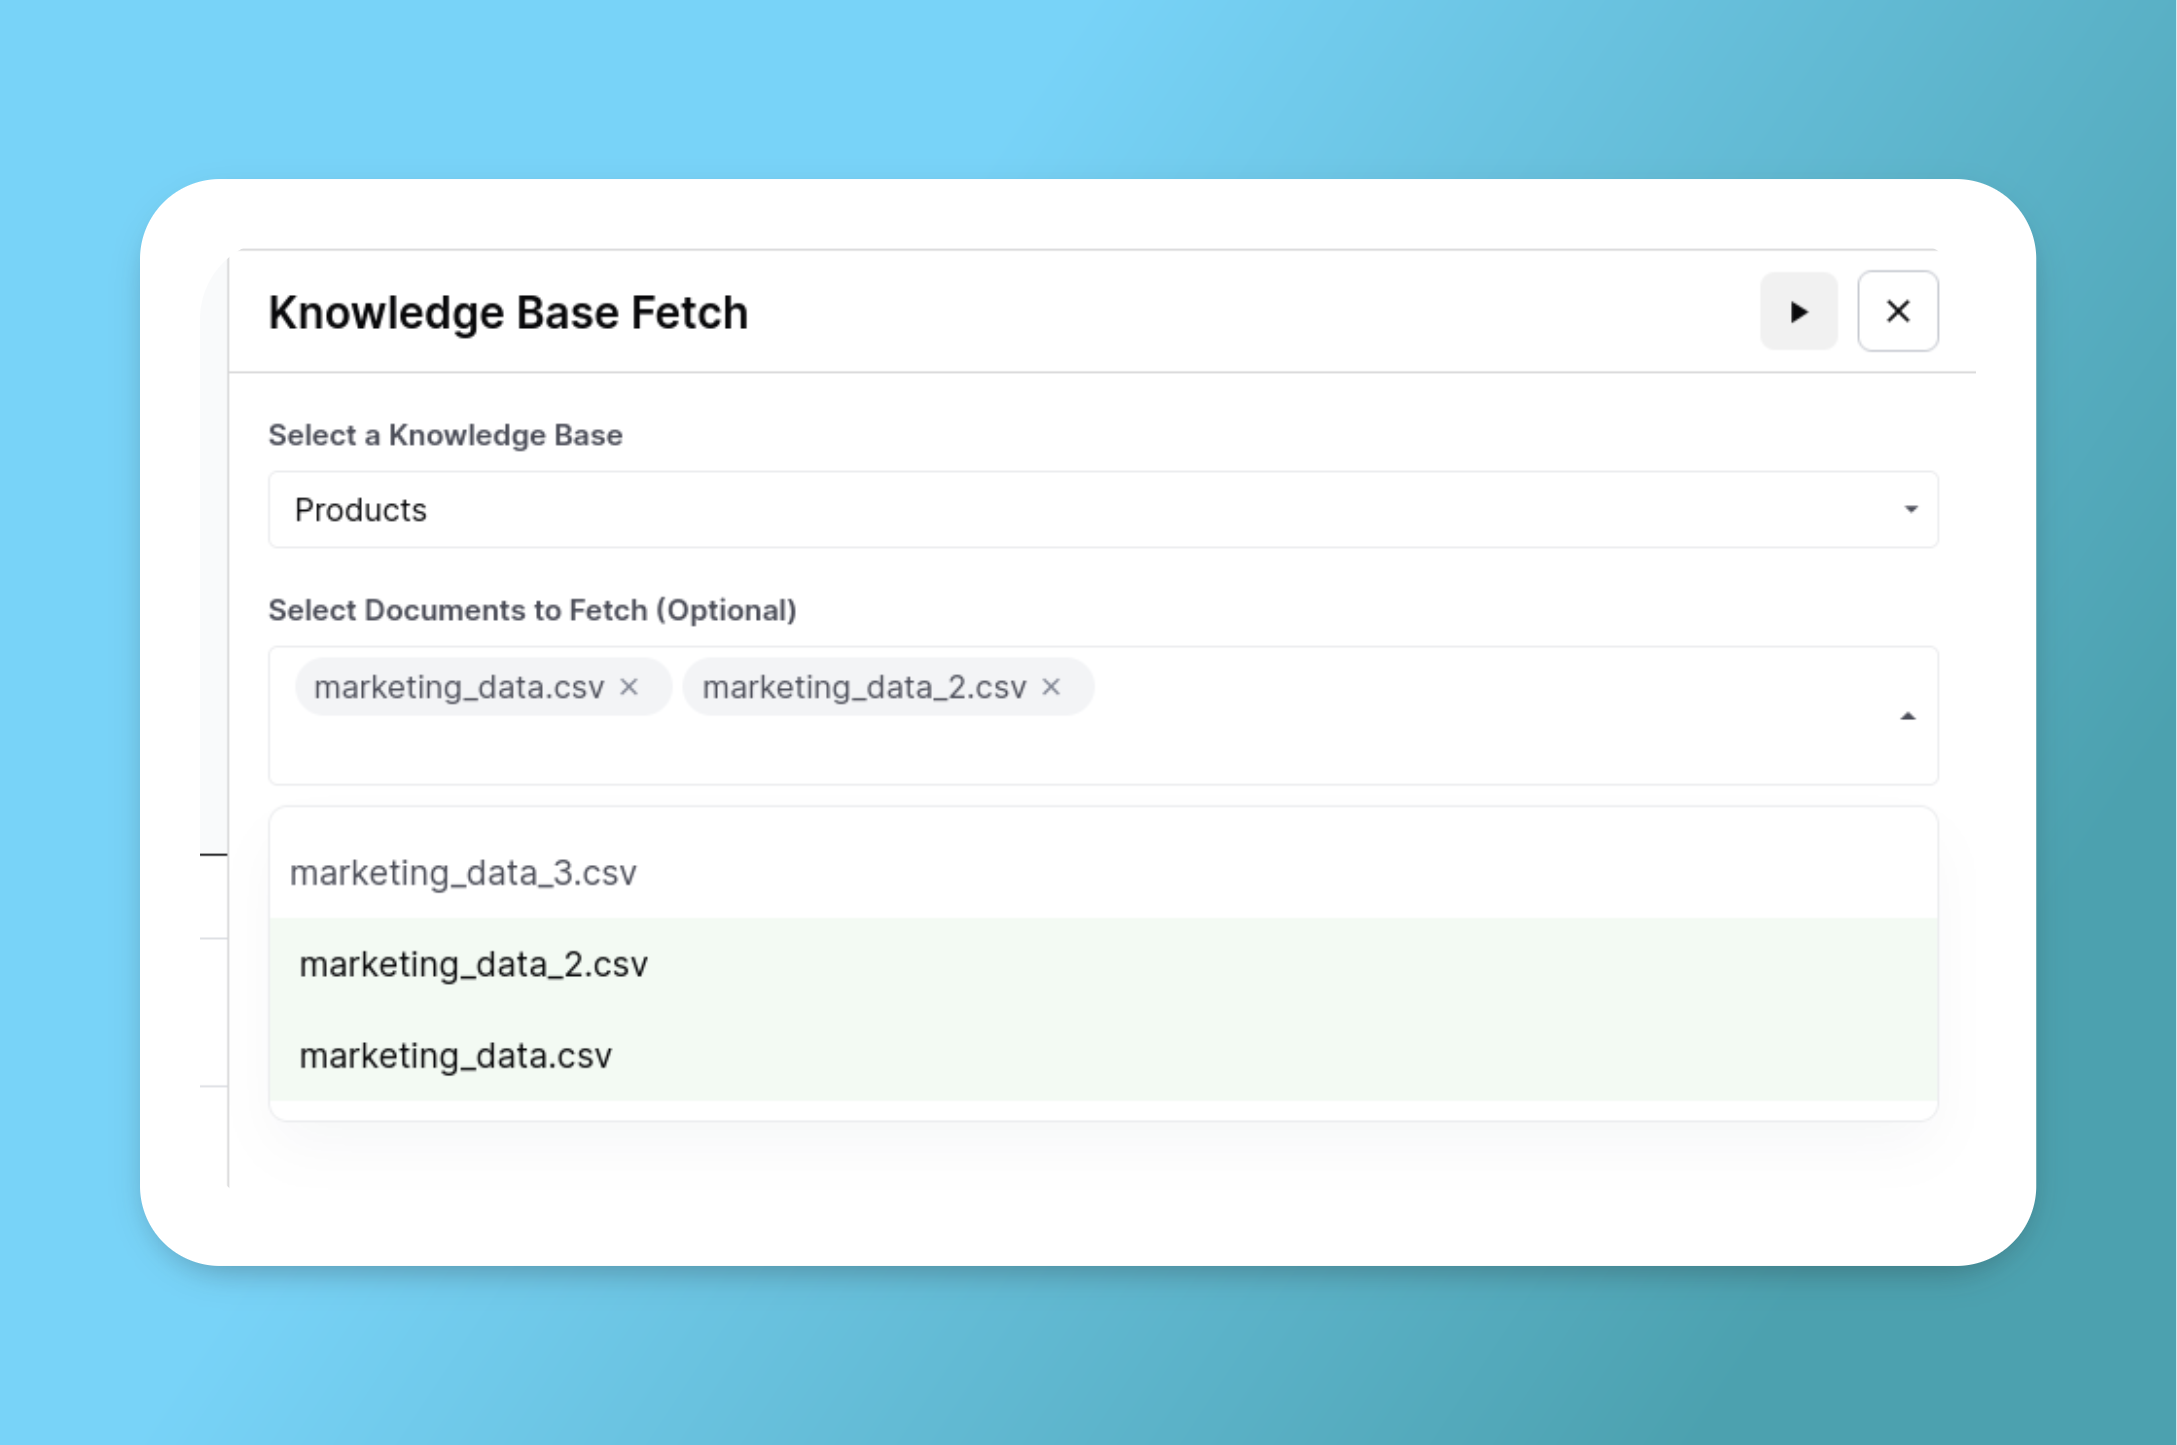
### Bestimmte Dateien auswählen (optional)
Du kannst optional mehrere Dokumente aus einer Liste auswählen, aus denen du lesen möchtest:
### Filter hinzufügen (optional)
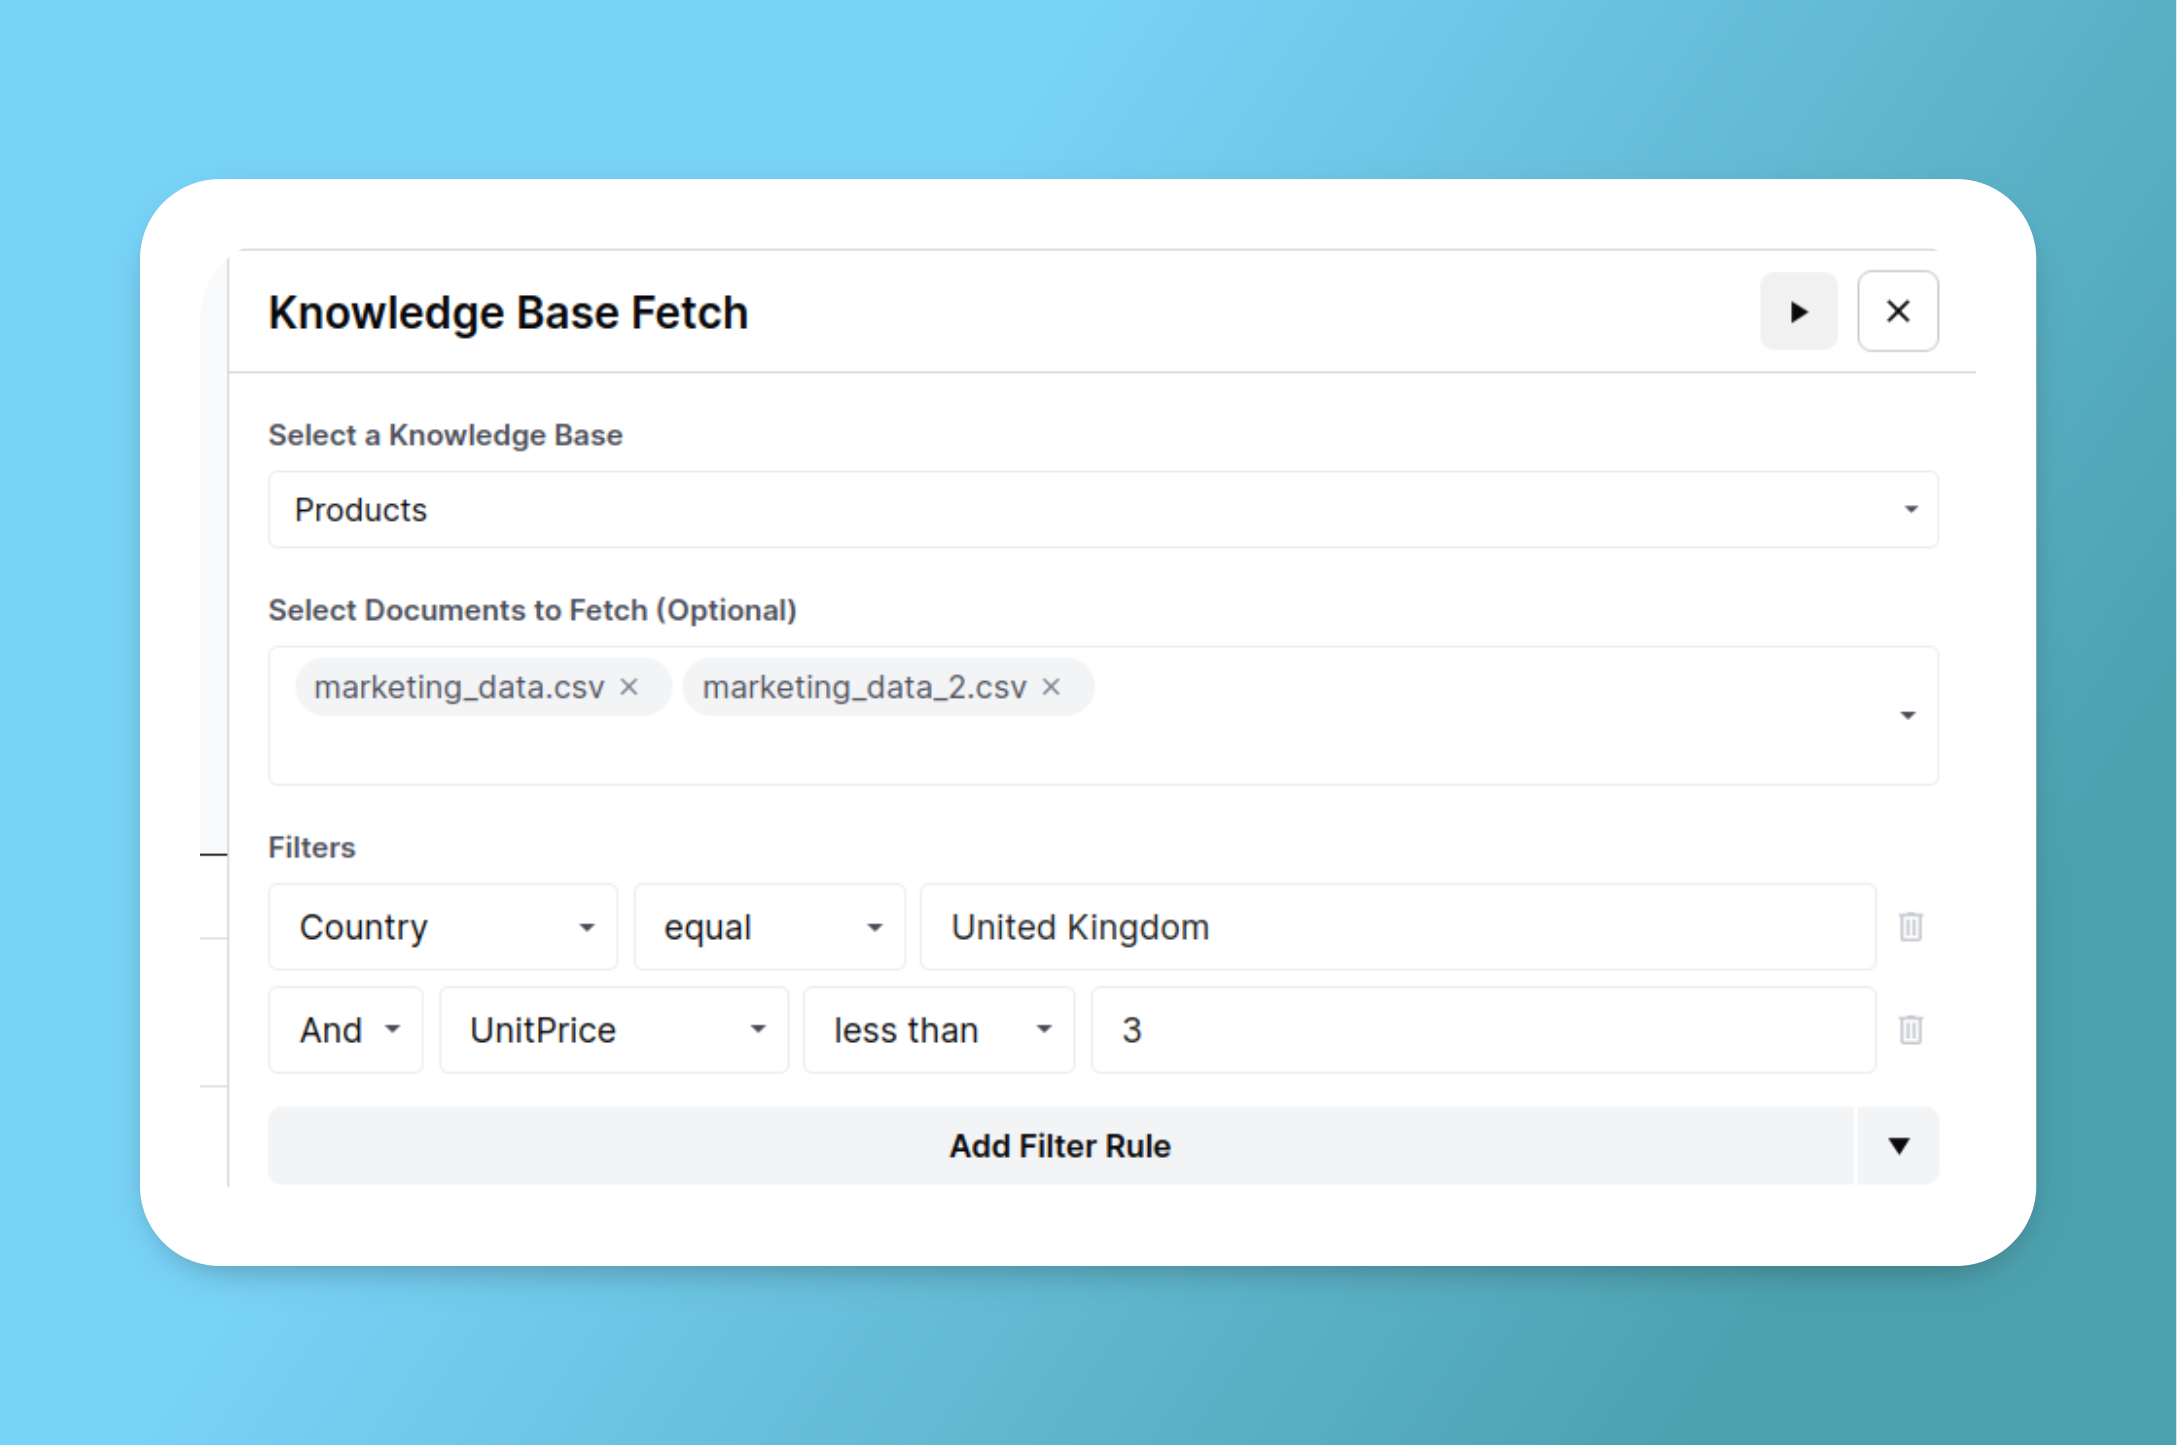
Du kannst Filter hinzufügen, um die Ergebnisse anhand von Metadatenfeldern einzugrenzen. Dazu gehören:
* **Standardmetadaten** vom Ursprung übernommen (z. B. Dateiname, Quell-URL)
* **Benutzerdefinierte Metadaten** die du hinzugefügt hast, um Dateien zu taggen (z. B. Land, Produkt, Zielgruppe)
* **CSV-/Tabellenspalten** wenn die Wissensdatenbank strukturierte Daten enthält
**Beispiel: Filtern nach benutzerdefinierten Metadaten**
Wenn du Kundenfallstudien mit einem `country` benutzerdefinierten Metadatenfeld getaggt hast, kannst du filtern, um nur Fallstudien für eine bestimmte Region abzurufen:
{% hint style="success" %}
**Dynamische Filterung**
Verwende Workflow-Eingaben, um Filter dynamisch zu machen. Setze zum Beispiel den Filter auf `country` gleich `{{input.region}}` und der Workflow ruft Dateien ab, die der zur Laufzeit übergebenen Region entsprechen.
{% endhint %}
Damit die Filterung wirksam ist, empfehlen wir, Folgendes durchzulesen [Metadaten von Wissensdatenbanken](/docs/de/kontext/memory-stores/memory-stores-metadata.md) um zu lernen, wie du benutzerdefinierte Metadaten-Tags zu deinen Wissensdatenbank-Dateien hinzufügst.
## Ausgabe des Leseschritts für die Wissensdatenbank
Der Leseschritt für die Wissensdatenbank gibt eine Liste von Dokumenten mit den jeweiligen Datensätzen aus. In unserem vorherigen Beispiel mit gefilterten Produkten sieht die Ausgabe so aus:
```json
[
{
"document_name": "marketing_data.csv",
"records": [
{
"__text": "WHITE HANGING HEART T-LIGHT HOLDER\n\n-----\n\nVereinigtes Königreich",
"InvoiceNo": 536365,
"StockCode": "85123A",
"Description": "WHITE HANGING HEART T-LIGHT HOLDER",
"Quantity": 6,
"InvoiceDate": "12/1/2010 8:26",
"UnitPrice": 2.55,
"CustomerID": 17850,
"Country": "Vereinigtes Königreich"
},
...
]
},
{
"document_name": "marketing_data_2.csv",
"records": [
{
"__text": "CREAM CUPID HEARTS COAT HANGER\n\n-----\n\nVereinigtes Königreich",
"InvoiceNo": 536365,
"StockCode": "84406B",
"Description": "CREAM CUPID HEARTS COAT HANGER",
"Quantity": 8,
"InvoiceDate": "12/1/2010 8:26",
"UnitPrice": 2.75,
"CustomerID": 17850,
"Country": "Vereinigtes Königreich"
},
...
]
}
]
```
Du kannst erkennen, dass:
* Nur die Dokumente zurückgegeben werden, die aus dem Dropdown-Menü ausgewählt wurden.
* Jedes Dokument hat eine Liste von Datensätzen angehängt. Da es sich bei diesen Dokumenten um CSV-Dateien handelt, stellt jeder Datensatz eine andere Zeile dar.
* Nur die Datensätze werden zurückgegeben, die den ausgewählten Filtern entsprechen (Vereinigtes Königreich und UnitPrice < 3).
* Es gibt ein spezielles Feld "\_\_text", das den durchsuchbaren Text anzeigt, der beim CSV-Upload ausgewählt wurde. Da in diesem Fall nur die Spalten "Description" und "Country" als durchsuchbar ausgewählt wurden, sind diese Spalten im Feld "\_\_text" eingebettet.
Im Folgenden ist ein Beispiel für die Ausgabe beim Abrufen eines PDF-Dokuments:
```json
[
{
"document_name": "US_Congress-2023-SB546-Enrolled.pdf",
"records": [
{
"__text": "S. 546 \n\nEinhundertachtzehnter Kongress der Vereinigten Staaten von Amerika\n\nIN DER ZWEITEN SITZUNG\n\nBegonnen und abgehalten in der Stadt Washington am Mittwoch, dem dritten Januar zweitausendvierundzwanzig\n\nEin Gesetz\n\nZur Änderung des Omnibus Crime Control and Safe Streets Act von 1968, um Strafverfolgungsbehörden zu ermächtigen, COPS-Zuschüsse für Rekrutierungsmaßnahmen und für andere Zwecke zu verwenden...",
"__languages": [
"eng"
],
}
]
}
]
```
## Verwendung der Schritt-Ausgabe, um RAG durchzuführen
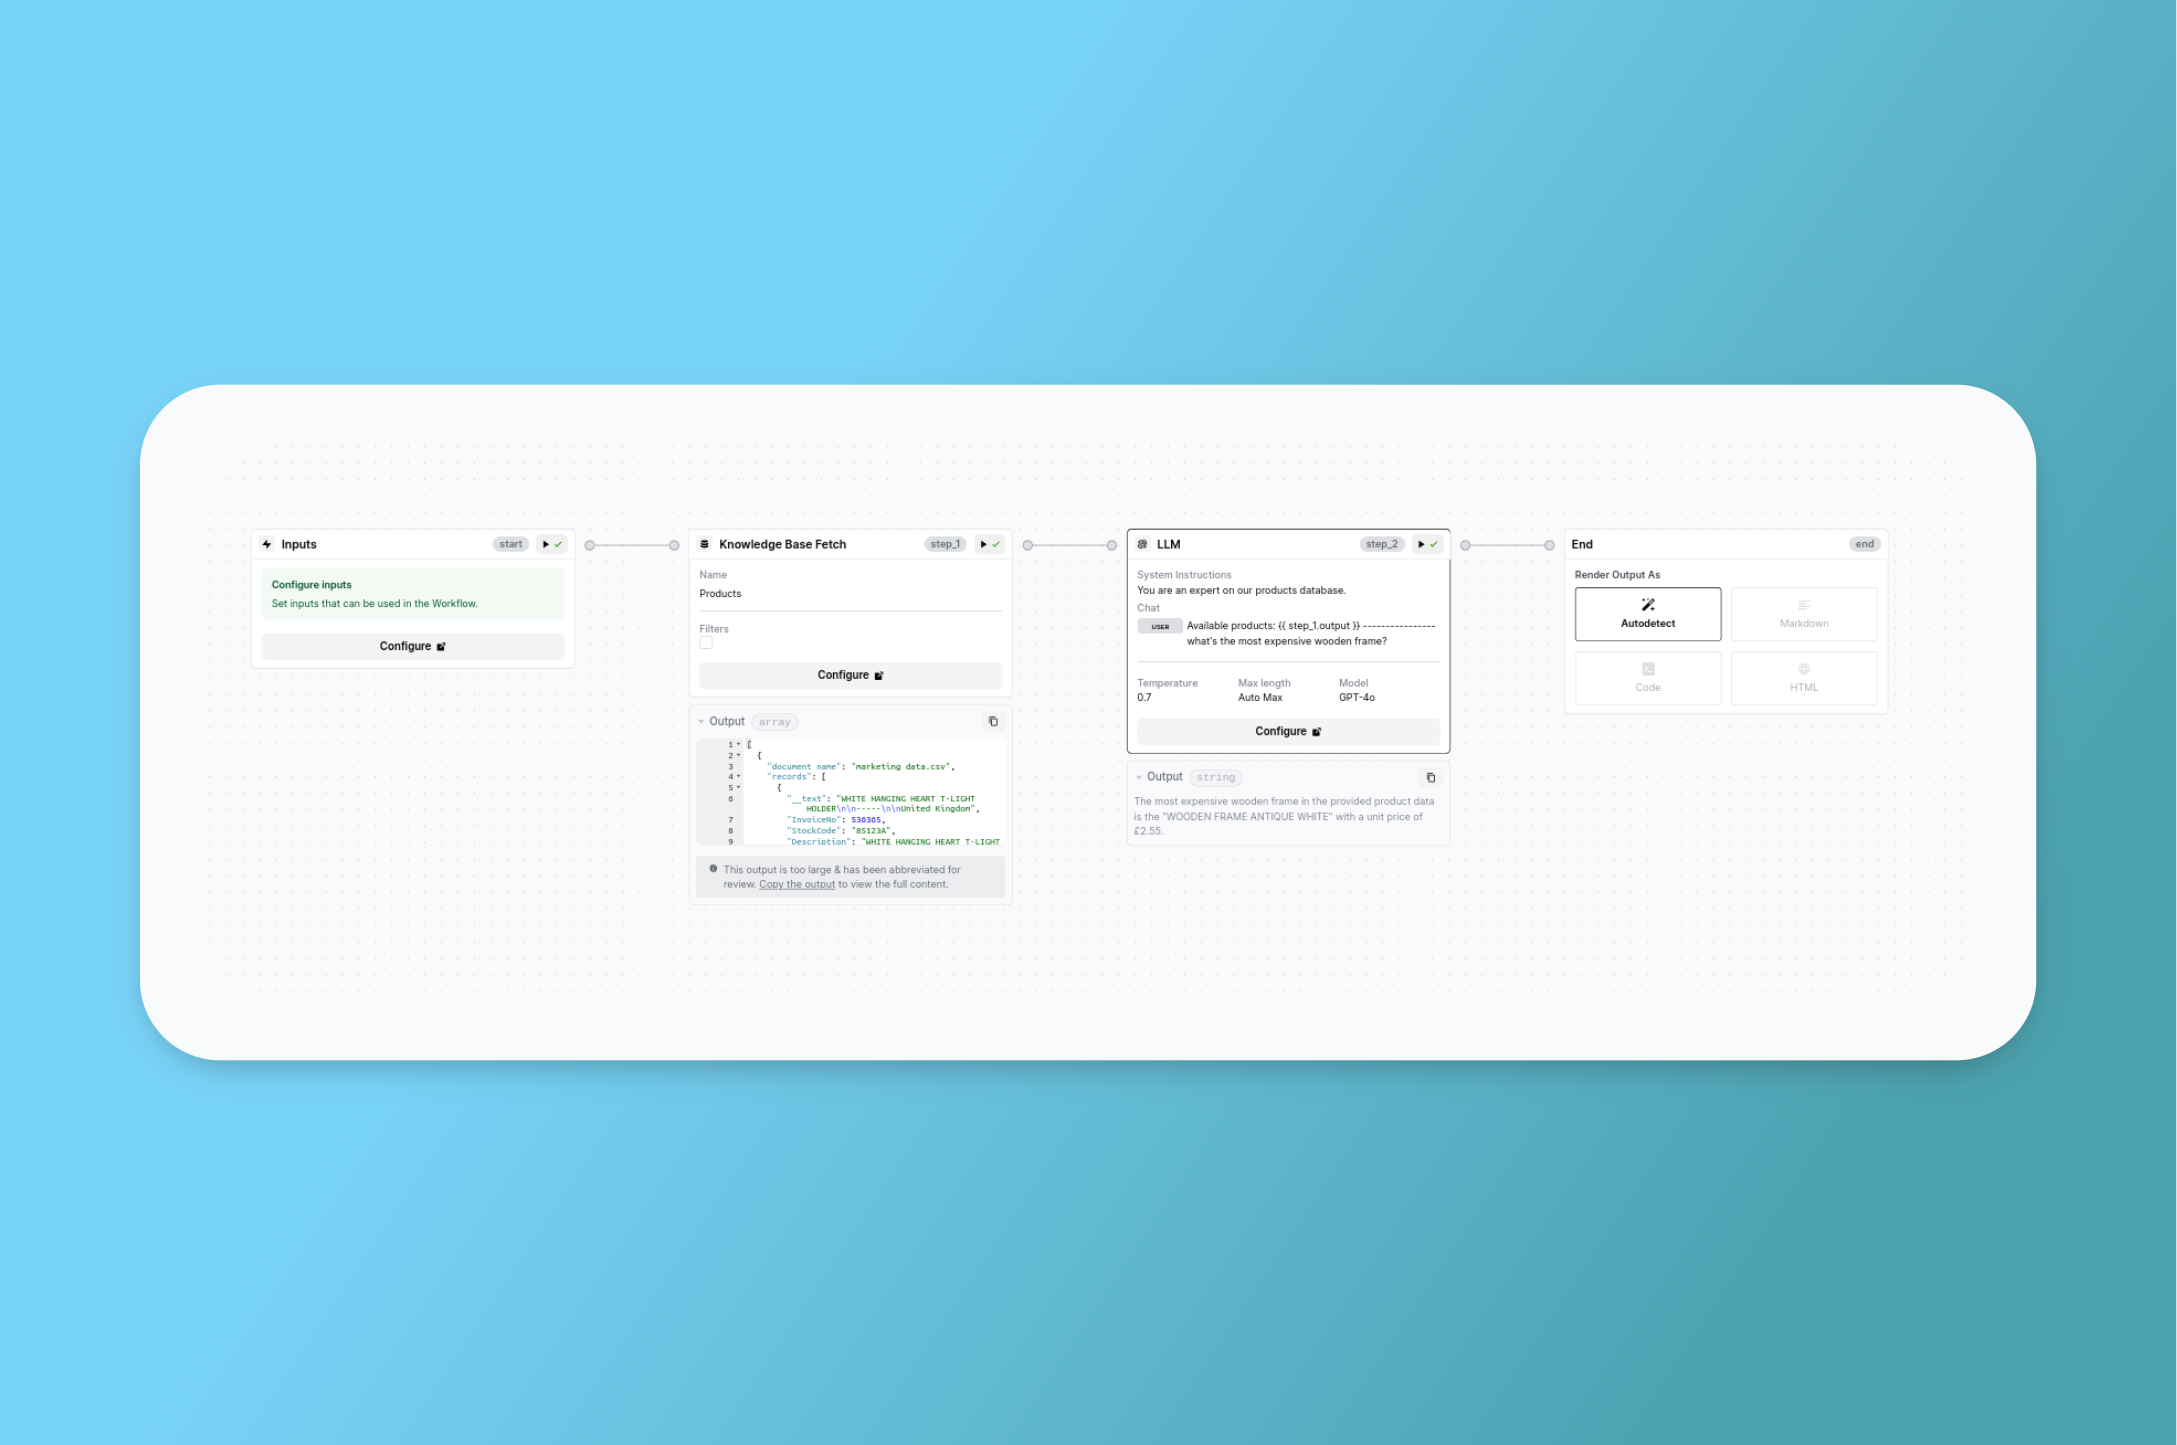
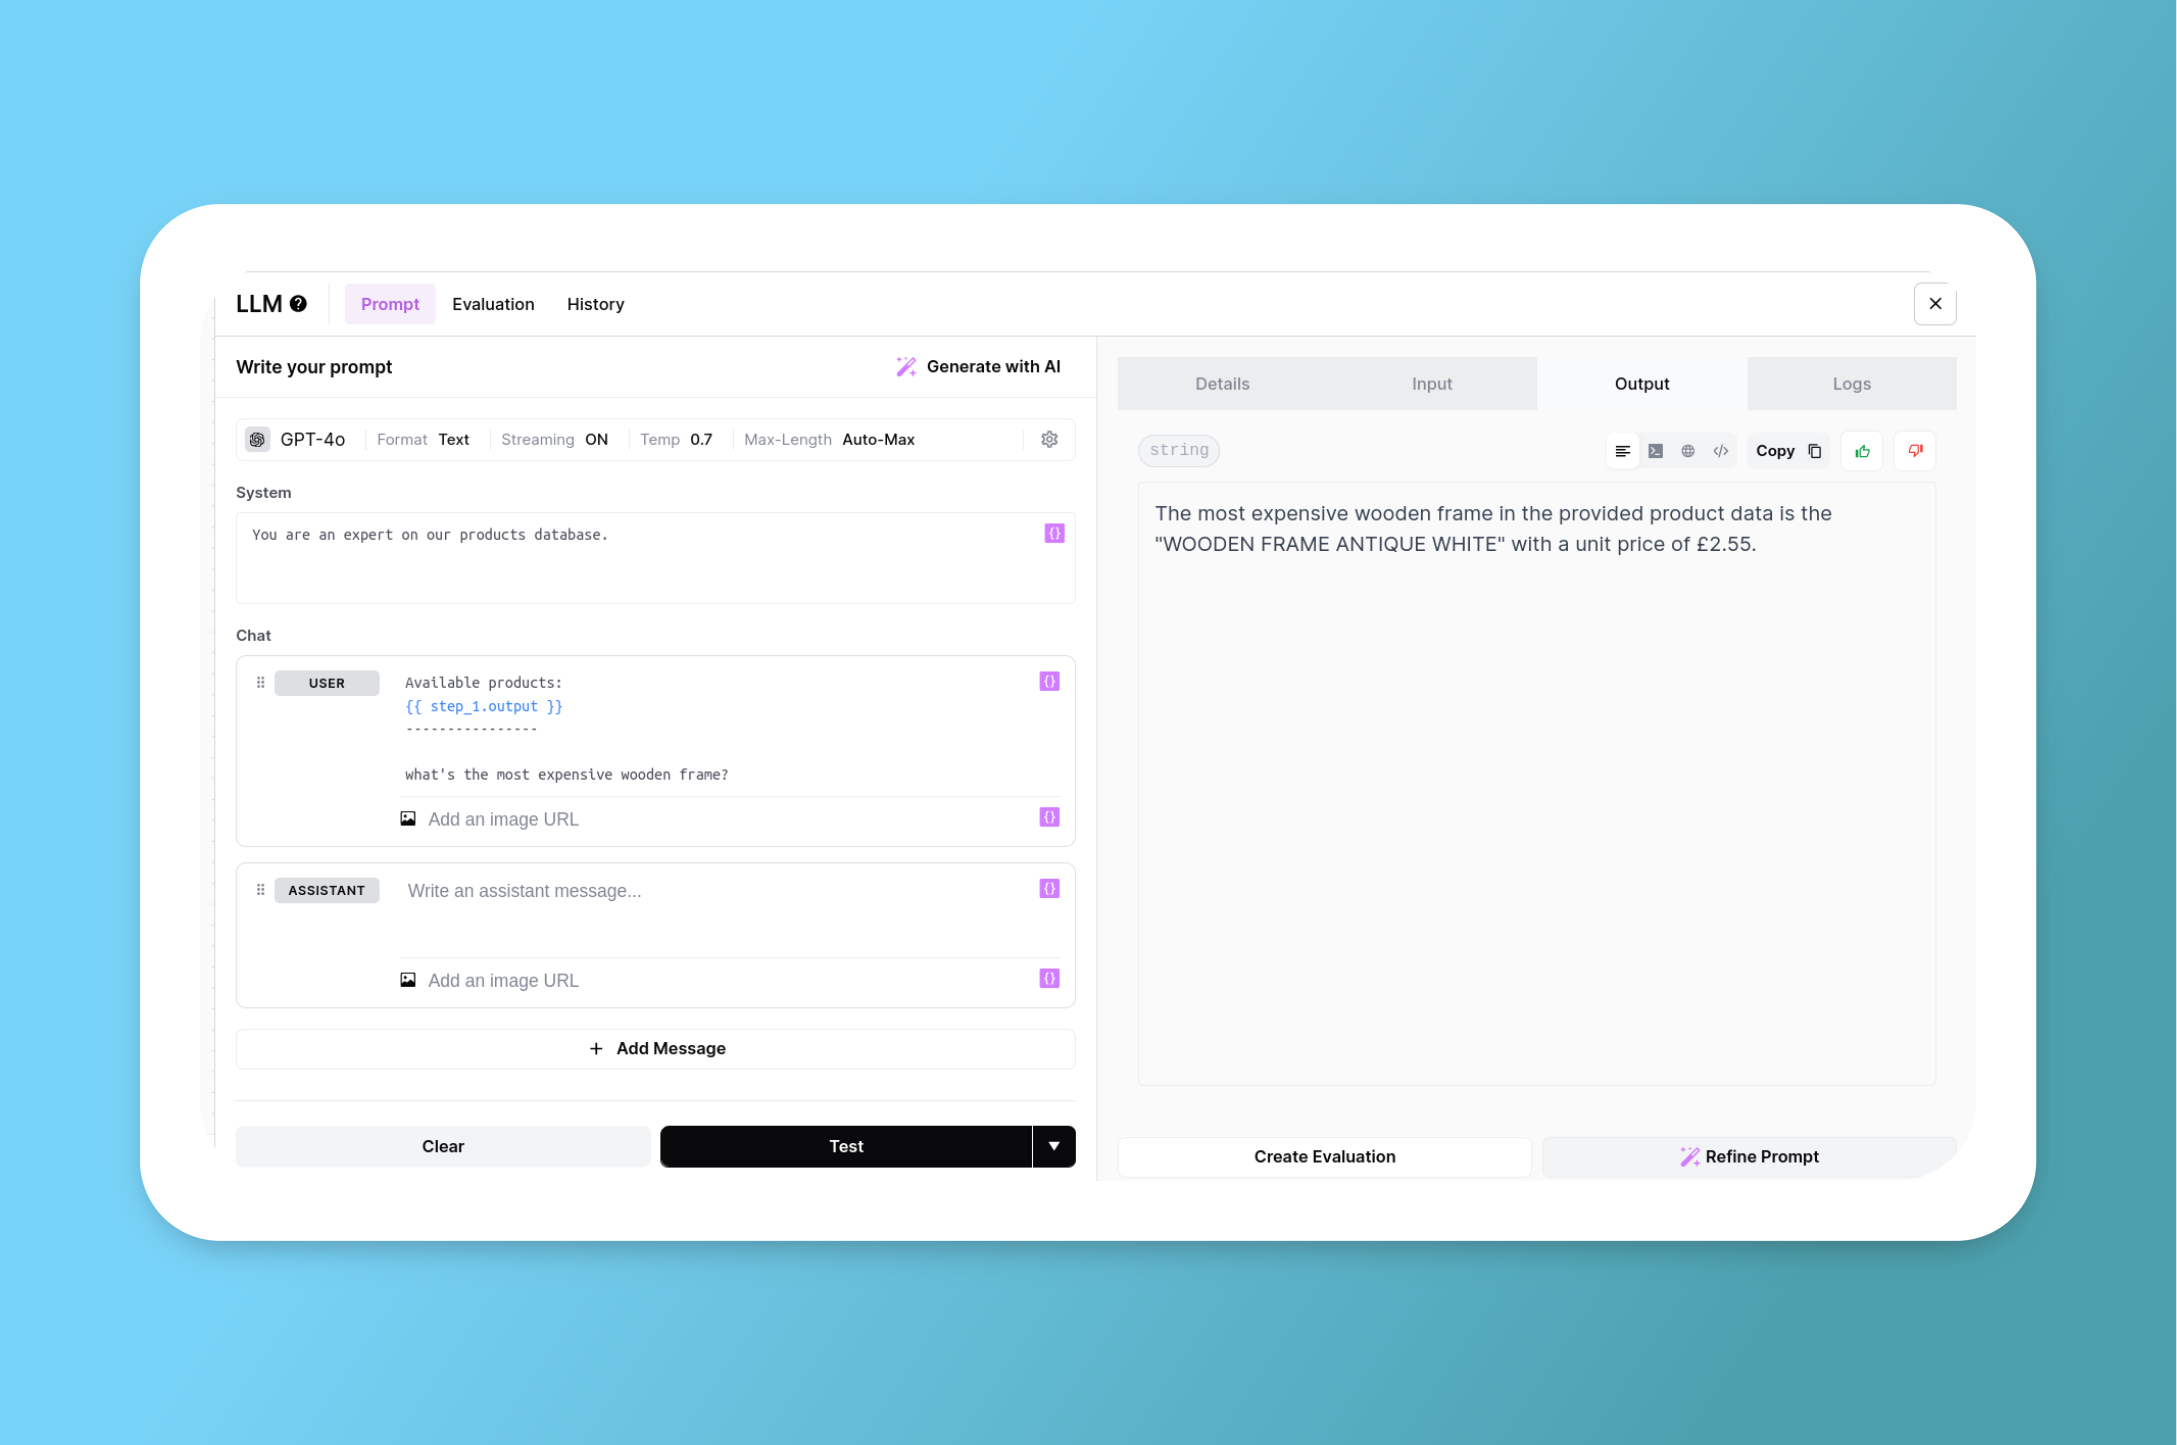
Wir können die Ausgabe des Wissensdatenbank-Abrufschritts in einen LLM-Schritt für die Durchführung von Retrieval-gestützter Generierung übergeben.
Im Anschluss an unser Produkte-Beispiel können wir die vollständige Produktliste abrufen und sie so an einen LLM-Schritt übergeben:
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.airops.com/docs/de/aktionen/workflow-concepts/workflow-steps/memory-steps/knowledge-base-read.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.